
MySQL中间件之ProxySQL(11):链式规则( flagIN 和 flagOUT )
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html
1.理解链式规则
在mysql_query_rules表中,有两个特殊字段"flagIN"和"flagOUT",它们分别用来定义规则的入口和出口,从而实现链式规则(chains of rules)。
链式规则的实现方式如下:
- 当入口值flagIN设置为0时,表示开始进入链式规则。如未显式指定规则的flagIN值,则默认都为0。
- 当语句匹配完当前规则后,将记下当前规则的flagOUT值,如果flagOUT值非空(NOT NULL),则为该语句打上flagOUT标记。如果该规则的apply字段值不是1,则继续向下匹配。
- 如果语句的flagOUT标记和下一条规则的flagIN值不同,则跳过该规则,继续向下匹配。直到匹配到
flagOUT=flagIN的规则,则匹配该规则。该规则是链式规则中的另一条规则。 - 直到某规则的apply字段设置为1,或者已经匹配完所有规则,则最后一次被评估的规则将直接生效,不再继续向下匹配。
通过下面两张图,应该很容易理解链式规则的生效方式。
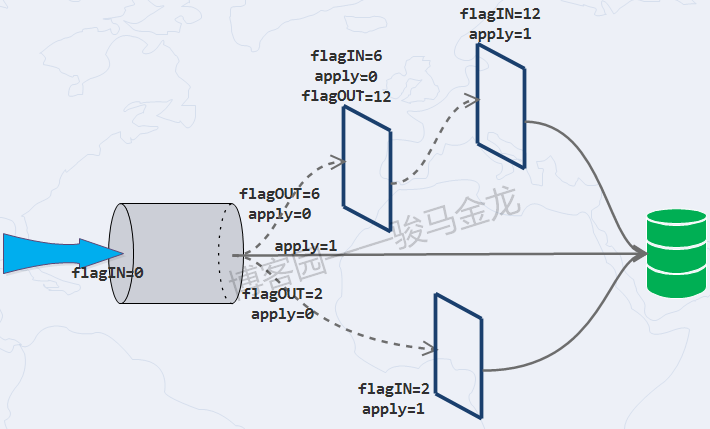
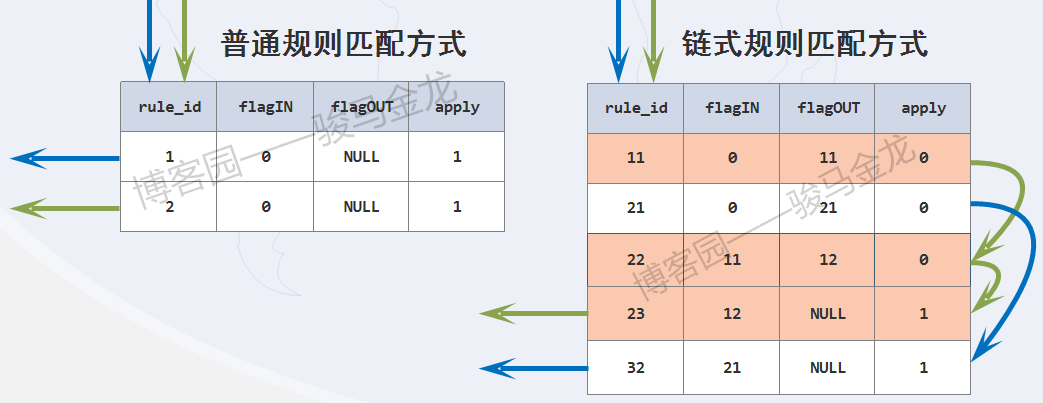
必须注意,规则是按照rule_id的大小顺序进行的。且并非只有apply=1时才会应用规则,当无规则可匹配,或者某规则的flagIN和flagOUT值相同,都会应用最后一次被评估的规则。
以下几个示例,可以解释生效规则:
# rule_id=3 生效

+---------+-------+--------+---------+

| rule_id | apply | flagIN | flagOUT |

+---------+-------+--------+---------+

| 1       | 0     | 0      | 23      |

| 2       | 0     | 23     | 23      |

| 3       | 0     | 23     | NULL    |

+---------+-------+--------+---------+

# rule_id=2 生效

+---------+-------+--------+---------+

| rule_id | apply | flagIN | flagOUT |

+---------+-------+--------+---------+

| 1       | 0     | 0      | 23      |

| 2       | 0     | 23     | 23      |

| 3       | 0     | 24     | NULL    |

+---------+-------+--------+---------+

# rule_id=2 生效,因为匹配完rule_id=2后,还打着flagOUT=23标记

+---------+-------+--------+---------+

| rule_id | apply | flagIN | flagOUT |

+---------+-------+--------+---------+

| 1       | 0     | 0      | 23      |

| 2       | 0     | 23     | NULL    |

| 3       | 1     | 24     | NULL    |

+---------+-------+--------+---------+

# rule_id=3 生效,因为匹配完rule_id=2后,还打着flagOUT=23标记

+---------+-------+--------+---------+

| rule_id | apply | flagIN | flagOUT |

+---------+-------+--------+---------+

| 1       | 0     | 0      | 23      |

| 2       | 0     | 23     | NULL    |

| 3       | 1     | 23     | NULL    |

+---------+-------+--------+---------+
2.链式规则示例
有了普通规则匹配方式,为什么还要设计链式规则呢?虽然ProxySQL通过正则表达式实现了很灵活的规则匹配模式,但需求总是千变万化的,有时候仅通过一条正则匹配规则和替换规则很难实现比较复杂的要求,例如sharding时。
链式规则除了常用的多次替换,还可巧用于多次匹配。
本文简单演示一下链式规则,不具有实际意义,只为后面ProxySQL实现sharding的文章做基础知识铺垫。
2个测试库,共4张表test{1,2}.t{1,2}。
mysql> select * from test1.t1;

+------------------+

| name             |

+------------------+

| test1_t1_malong1 |

| test1_t1_malong2 |

| test1_t1_malong3 |

+------------------+

mysql> select * from test1.t2;

+------------------+

| name             |

+------------------+

| test1_t2_malong1 |

| test1_t2_malong2 |

| test1_t2_malong3 |

+------------------+

mysql> select * from test2.t1;

+--------------------+

| name               |

+--------------------+

| test2_t1_xiaofang1 |

| test2_t1_xiaofang2 |

| test2_t1_xiaofang3 |

+--------------------+

mysql> select * from test2.t2;

+--------------------+

| name               |

+--------------------+

| test2_t2_xiaofang1 |

| test2_t2_xiaofang2 |

| test2_t2_xiaofang3 |

+--------------------+
现在借用链式规则,一步一步地将对test1.t1表的查询路由到test2.t2表的查询。再次声明,此处示例毫无实际意义,仅为演示链式规则的基本用法。
大致链式匹配的过程为:
test1.t1 --> test1.t2 --> test2.t1 --> test2.t2
以下是具体插入的规则:
delete from mysql_query_rules;

select * from stats_mysql_query_digest_reset where 1=0;

insert into mysql_query_rules

(rule_id,active,apply,flagIN,flagOUT,match_pattern,replace_pattern) values

(1,1,0,0,23,"test1\.t1","test1.t2");

insert into mysql_query_rules

(rule_id,active,apply,flagIN,flagOUT,match_pattern,replace_pattern) values

(2,1,0,23,24,"test1\.t2","test2.t1");

insert into mysql_query_rules

(rule_id,active,apply,flagIN,flagOUT,match_pattern,replace_pattern,destination_hostgroup) values

(3,1,1,24,NULL,"test2\.t1","test2.t2",30);

load mysql query rules to runtime;

save mysql query rules to disk;

admin> select rule_id,

              apply,

              flagIN,

              flagOUT,

              match_pattern,

              replace_pattern,

              destination_hostgroup DH

              from mysql_query_rules;

+---------+-------+--------+---------+---------------+-----------------+------+

| rule_id | apply | flagIN | flagOUT | match_pattern | replace_pattern | DH   |

+---------+-------+--------+---------+---------------+-----------------+------+

| 1       | 0     | 0      | 23      | test1\.t1     | test1.t2        | NULL |

| 2       | 0     | 23     | 24      | test1\.t2     | test2.t1        | NULL |

| 3       | 1     | 24     | NULL    | test2\.t1     | test2.t2        | 30   |

+---------+-------+--------+---------+---------------+-----------------+------+
查询test1.t1表,测试结果。
[root@xuexi ~]# mysql -uroot -pP@ssword1! -h127.0.0.1 -P6033 -e "select * from test1.t1;"

+--------------------+

| name               |

+--------------------+

| test2_t2_xiaofang1 |  <-- 查询返回结果为test2.t2内容

| test2_t2_xiaofang2 |

| test2_t2_xiaofang3 |

+--------------------+

admin> select * from stats_mysql_query_rules;

+---------+------+

| rule_id | hits |

+---------+------+

| 1       | 1    |  <-- 3条规则全都命中

| 2       | 1    |

| 3       | 1    |

+---------+------+

admin> select hostgroup,digest_text from stats_mysql_query_digest;

+-----------+----------------------------------+

| hostgroup | digest_text                      |

+-----------+----------------------------------+

| 30        | select * from test2.t2           |  <-- 路由目标hg=30

+-----------+----------------------------------+
显然,已经按照预想中的方式进行匹配、替换、路由。
一个问题:如果查询的是test1.t2表或test2.t1表,会进行链式匹配吗?
答案是不会,因为rule_id=2和rule_id=3这两个规则的flagIN都是非0值,而每个SQL语句初始时只进入flagIN=0的规则。
此外还需注意,当某语句未按照我们的期望途经所有的链式规则,则可能会根据destination_hostgroup字段的值直接路由出去,即使没有指定该字段值,还有用户的默认路由目标组,或者基于端口的路由目标。所以,在写链式规则时,应当尽可能地针对某一类型的语句进行完完整整的定制,保证这类语句能途经我们所期望的所有规则。
MySQL中间件之ProxySQL(11):链式规则( flagIN 和 flagOUT )的更多相关文章
- ProxySQL(11):链式规则( flagIN 和 flagOUT )
文章转载自:https://www.cnblogs.com/f-ck-need-u/p/9350631.html 理解链式规则 在mysql_query_rules表中,有两个特殊字段"fl ...
- MySQL中间件之ProxySQL(7):详述ProxySQL的路由规则
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html 1.关于ProxySQL路由的简述 当ProxySQL收到前端app发 ...
- MySQL中间件之ProxySQL(9):ProxySQL的查询缓存功能
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html ProxySQL支持查询缓存的功能,可以将后端返回的结果集缓存在自己的 ...
- MySQL中间件之ProxySQL(1):简介和安装
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html 1.ProxySQL简介 之前的文章里,介绍了一个MySQL的中间件: ...
- MySQL中间件之ProxySQL(10):读写分离方法论
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html 1.不同类型的读写分离 数据库中间件最基本的功能就是实现读写分离,Pr ...
- MySQL中间件之ProxySQL(6):管理后端节点
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html 1.配置后端节点前的说明 为了让ProxySQL能够找到后端的MySQ ...
- MySQL中间件之ProxySQL(8):SQL语句的重写规则
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html 1.为什么要重写SQL语句 ProxySQL在收到前端发送来的SQL语 ...
- MySQL中间件之ProxySQL(14):ProxySQL+PXC
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html 1.ProxySQL+PXC 本文演示ProxySQL代理PXC(Pe ...
- MySQL中间件之ProxySQL(5):线程、线程池、连接池
返回ProxySQL系列文章:http://www.cnblogs.com/f-ck-need-u/p/7586194.html 1.ProxySQL的线程 ProxySQL由多个模块组成,是一个多线 ...
随机推荐
- Ubuntu 16.04更新grub-pc提示脚本/var/lib/dpkg/info/grub-pc.postinst 执行错误
错误信息: $ sudo aptitude upgrade 下列仅部分安装的软件包将被配置: grub-pc 将不会安装,升级或者删除任何软件包. 0 个软件包被升级,新安装 0 个, 0 个将被删除 ...
- JS prototype chaining(原型链)整理中······
初学原型链整理 构造器(constructor).原型(prototype).实例(instance); 每一个构造器都有一个prototype对象,这个prototype对象有一个指针指向该构造器: ...
- linux下使用iptables统计ip/端口流量
1.添加ip/端口的流量统计 入网流量: iptables -A INPUT -d 出网流量: iptables -A OUTPUT -s 2.查看流量统计信息 iptables -L -v -n - ...
- 【repost】javascript callback
在javascript中回调函数非常重要,它们几乎无处不在.像其他更加传统的编程语言都有回调函数概念,但是非常奇怪的是,完完整整谈论回调函数的在线教程比较少,倒是有一堆关于call()和apply() ...
- python random 模块
http://blog.csdn.net/m0_38061927/article/details/75335069
- 我的C#跨平台之旅(一):从 Hello World 开始
创建一个“控制台应用程序”,目标框架为“.NET Framework 4.5”,并移除无关的文件及引用,仅保留对 “system.dll”的引用:其中工程文件中核心内容如下: 使用NuGet添加如下引 ...
- HTML 通过js实现div的拖动效果
最近做项目,碰到一个问题,需要对div实现拖动效果. 在度娘找了很多,要么觉得代码太长,要么就是效果不理想,不过最后还是找到了一个不错的,感谢大神的留贴,方便了我们,就把代码贴下面了: <!DO ...
- Delphi ClientDataSet复制记录
数据源记录集:ClientDataSetSource:目标记录集:ClientDataSetCopy 1)复制一条记录. ClientDataSetCopy.Close; ClientDataSet ...
- CLion之C++框架篇-安装工具,基础框架的搭建(一)
背景 日常学习C++,也就是看看书.在vim里写写代码.在日常项目开发中,也是边看书(一是系统性理解.二是找找有什么更好的代码编写方式)边写代码,会顺带看看别人的代码怎么写的? 日常学 ...
- 深入分析.NET应用程序SQL注入【危害】
前言: 前面我们已经简单的剖析了一下.NET应用程序SQL注入.没有看过的朋友移步:http://bbs.ichunqiu.com/thread-7636-1-1.html,在上一篇文章我们已经了 ...