
SVM: 使用kernels(核函数)的整个SVM算法过程
将所有的样本都选做landmarks

一种方法是将所有的training data都做为landmarks,这样就会有m个landmarks(m个trainnign data),这样features就是某个x(可以是trainning data/cross validation data/test data里面的)与这些landmarks之间的距离的远近程度的描述。
landmarks选定后得出新的features向量
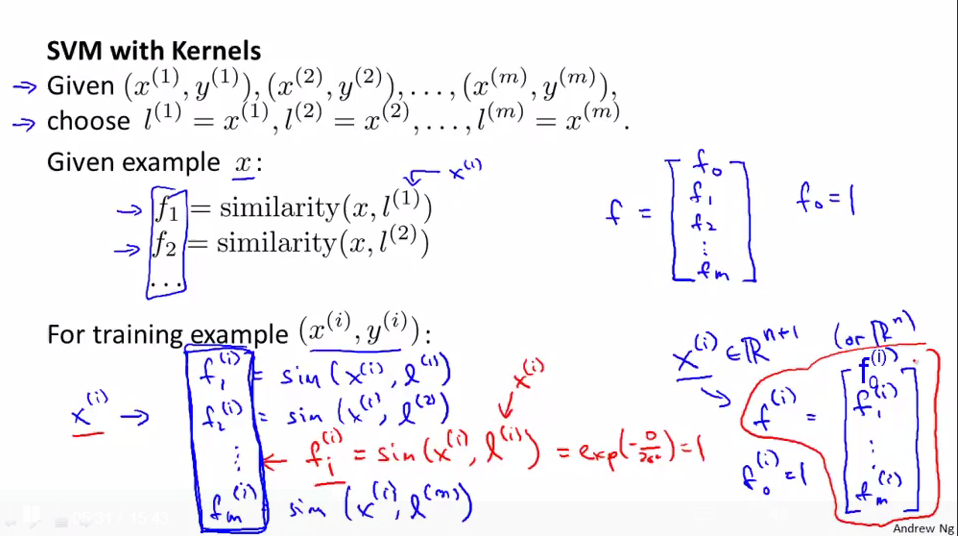
给出一个x,则通过这些landmarks来计算features向量,和之前的类似,将f0=1;
对于在training data里面的x(i)则通过kernel函数映射后变为f1(i),f2(i).....fm(i)(m个trainning data,m个landmarks),对于fi(i),由高斯核函数计算得出1
如何minimize cost function得出parameters-- θ
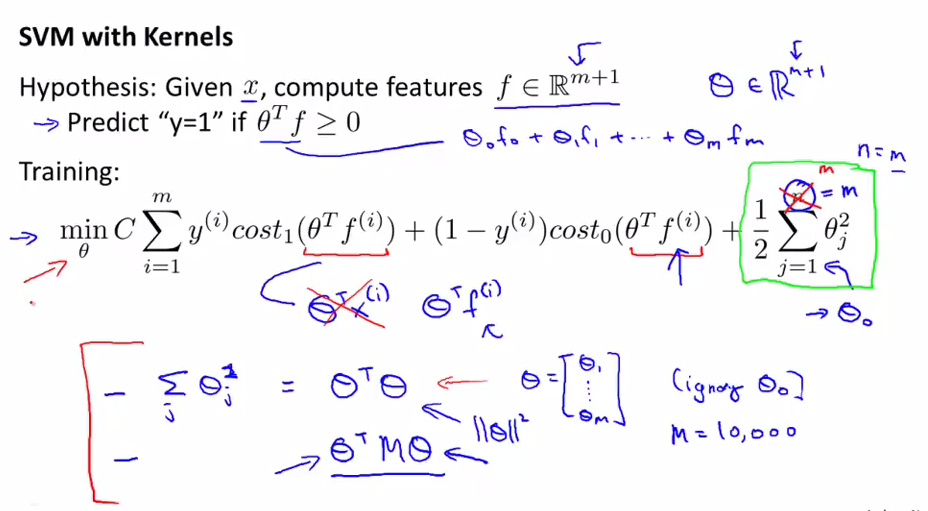
我们根据核函数计算出new features f(有m+1维):m个landmarks(m个data set),+1是f0=1
cost function与之前的有些不同,因为我们用了新的features,所以z不是θTx(i)而是θTf(i);后面的正则化项因为θ为m+1维,不对θ0正则化,即从θ1-m进行累加
这儿需要注意的是在使用SVM与核函数时,不是使用θTθ来表示parameters的平方的累加,而是使用θTMθ(M为依赖于采用的某个核函数的矩阵),为另一种略有区别的距离度量方式,不使用||θ||2进行最小化,而是最小化另一种类型的度量(参数向量θ的变尺度形式,这种变化和核函数有关),这样使得SVM有效率的运行,之所以这样做是为了适应大的数据集,因为当我们的数据集很大的时,landmarks就会很多,θ的维数也会很大,这样计算θ就会很慢,所以做了这样的优化。
kernels能应用到其它算法吗?如logistic regression等?可以将kernels应用到其它算法,但是用于SVM的计算技巧却不能较好的推广到其它算法(如logistic regression),所以将kernels应用到logistic regression时,会变得非常慢。
SVM与kernels是相配的,而logistic regression与kernels会十分慢。
一些计算小技巧是人们专门为使用kernels的SVM来开发的
如何确定SVM的一些参数(如C与高斯核函数的σ2)--bias与variance之间的权衡
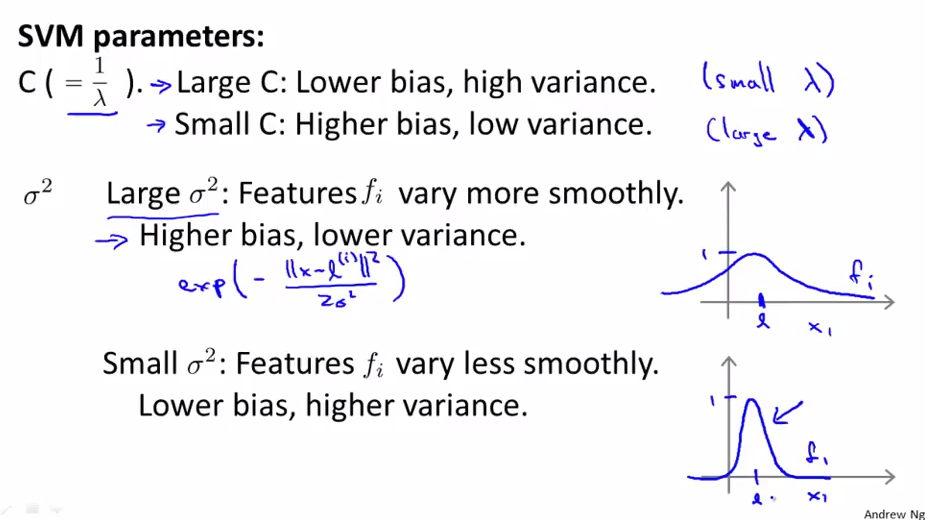
C=1/λ,λ为正则化参数,当C大时,表示λ小,则会high variance,low bias(overfitting)
当C小是,表示λ大,则会high bias, low variance(underfitting)
σ2为高斯核函数的参数,用来表示f(新的features)与x之间变化是平缓的还是急剧的。
大的σ2,表示参数的值随着x的变化而变化平缓,所以会出现underfitting(high bias,lower variance)
小的σ2,表示参数的值随着x的变化而变化急剧所以会出现overfitting(high variance,lower bias)
SVM: 使用kernels(核函数)的整个SVM算法过程的更多相关文章
- SVM: 用kernels(核函数)来定义新的features,避免使用多项式,高斯kernel
应用kernels来进行非线性分类 非线性分类:是否存在好的features的选择(而不是多项式)--f1,f2,f3.... 上图是一个非线性分类的问题,前面讲过,我们可以应用多项式(feature ...
- (转载)python应用svm算法过程
除了在Matlab中使用PRTools工具箱中的svm算法,Python中一样可以使用支持向量机做分类.因为Python中的sklearn库也集成了SVM算法,本文的运行环境是Pycharm. 一.导 ...
- 解密SVM系列(四):SVM非线性分类原理实验
前面几节我们讨论了SVM原理.求解线性分类下SVM的SMO方法.本节将分析SVM处理非线性分类的相关问题. 一般的非线性分类例如以下左所看到的(后面我们将实战以下这种情况): 能够看到在原始空间中你想 ...
- 解密SVM系列(二):SVM的理论基础(转载)
解密SVM系列(二):SVM的理论基础 原文博主讲解地太好了 收藏下 解密SVM系列(三):SMO算法原理与实战求解 支持向量机通俗导论(理解SVM的三层境界) 上节我们探讨了关于拉格朗日乘 ...
- 牛客网Java刷题知识点之垃圾回收算法过程、哪些内存需要回收、被标记需要清除对象的自我救赎、对象将根据存活的时间被分为:年轻代、年老代(Old Generation)、永久代、垃圾回收器的分类
不多说,直接上干货! 首先,大家要搞清楚,java里的内存是怎么分配的.详细见 牛客网Java刷题知识点之内存的划分(寄存器.本地方法区.方法区.栈内存和堆内存) 哪些内存需要回收 其实,一般是对堆内 ...
- 【机器学习算法-python实现】svm支持向量机(3)—核函数
版权声明:本文为博主原创文章,未经博主同意不得转载. https://blog.csdn.net/gshengod/article/details/24983333 (转载请注明出处:http://b ...
- SVM(三)—Kernels(核函数)
(整理自AndrewNG的课件,转载请注明.整理者:华科小涛@http://www.cnblogs.com/hust-ghtao/) 内容整理中...
- SVM为什么需要核函数
生存?还是毁灭?——哈姆雷特 可分?还是不可分?——支持向量机 之前一直在讨论的线性分类器,器如其名(汗,这是什么说法啊),只能对线性可分的样本做处理.如果提供的样本线性不可分,结果很简单,线性分类器 ...
- SVM入门(十)将SVM用于多类分类
源地址:http://www.blogjava.net/zhenandaci/archive/2009/03/26/262113.html 从 SVM的那几张图可以看出来,SVM是一种典型的两类分类器 ...
随机推荐
- springboot添加servlet的两种方法
1.是自己继承HttpServlet. 那么在类上面加 @WebServlet(loadOnStartup=1,urlPatterns={"/xxxServlet"}) 就可以了 ...
- K8S从入门到放弃系列-(16)Kubernetes集群Prometheus-operator监控部署
Prometheus Operator不同于Prometheus,Prometheus Operator是 CoreOS 开源的一套用于管理在 Kubernetes 集群上的 Prometheus 控 ...
- 使用JMeter进行Apache Kafka负载测试
1.卡夫卡负载测试 在这个Apache Kafka教程中,我们将了解如何使用Apache JMeter,如何在Apache Kafka上执行Kafka负载测试.此外,这个Kafka负载测试教程教我们如 ...
- 解决elementui日期时间选择器提交时与后台date类型不匹配问题
问题描述: 在前端使用elementui的日期时间选择器后,在通过axios进行提交的时候,前端控制台出现了400(数据类型不匹配的错误)的错误. <el-form-item label=&qu ...
- windows server系统打印服务配置
系统环境:windows server 2008 R2 Enterprise Service Pack 1 安装内存:8G 系统类型:64位操作系统 目标:在此系统上开启打印服务,可以添加网络打印机 ...
- Python学习日记(一) String函数使用
s = "abcaDa a" s2 = "123a abc ABCSAa s " s3 = "\tas \t\tb123" s4 = ' & ...
- python3遇到的问题
a bytes-like object is required,not str': 问题出在python3.5和Python2.7在套接字返回值解码上有区别:python bytes和str两种类型可 ...
- 基础数字电路的Verilog写法
Verilog是硬件描述电路,我对此一直稀里糊涂,于是将锆石科技开发板附带的的一些基础数字电路Verilog程序整理记录下来,并且查看他们的RTL视图,总算有点理解了. 1.基本运算符 module ...
- 一步一步手写GIS开源项目-(2)地图平移缩放实现
系列文章目录 一步一步手写GIS开源项目-(1)500行代码实现基础GIS展示功能 一步一步手写GIS开源项目-(2)地图平移缩放实现 项目github地址:https://github.com/Hu ...
- Java电商项目,秒杀,抢购等高并发场景的具体场景和一些概念以及处理思路
这里我借鉴了网上其他大佬的观点: 一:高并发带来的挑战 原因:秒杀抢购会经常会带来每秒几万的高并发场景,为了更快的返回结果给用户. 吞吐量指标QPS(每秒处理请求数),假设一个业务请求响应耗时为100 ...