
Python 之selenium+phantomJS斗鱼抓取案例
from selenium import webdriver

from bs4 import BeautifulSoup

import time

if __name__ == '__main__':

    driver = webdriver.PhantomJS()

    driver.get("https://www.douyu.com/directory/all")

    count = 0  # 总页数

    total = 0  # 房间数

    time.sleep(5)

    while True:

        # 判断是否到达尾页,如果是true,则推出循环

        attr = driver.find_element_by_css_selector(".dy-Pagination-next").get_attribute("aria-disabled")

        if "true" in attr:

            break

        try:

            page_count = 0 # 记录每页多少条数据

            # 解析html

            soup = BeautifulSoup(driver.page_source, "lxml")

            names = soup.find_all("h2", attrs={"class": "DyListCover-user"})

            looks = soup.find_all("span", attrs={"class": "DyListCover-hot"})

            for name, look in zip(names, looks):

                print("房间:" + name.get_text() + "\t人数:" + look.get_text())

                total += 1

                page_count += 1

            count += 1

            print("==================第%s页,每页%s条数据==================" % (str(count), str(page_count)))

            # 保存每一页的图片

            driver.save_screenshot("./douyu/douyu_%s.png" % str(count))

            # 点击下一页

            driver.find_element_by_css_selector(".dy-Pagination-next").click()

            # 等待数据加载完毕

            time.sleep(3)

        except RuntimeError as e:

            print(e)

    print("总页数:" + str(count))

    print("总房间数:" + str(total))
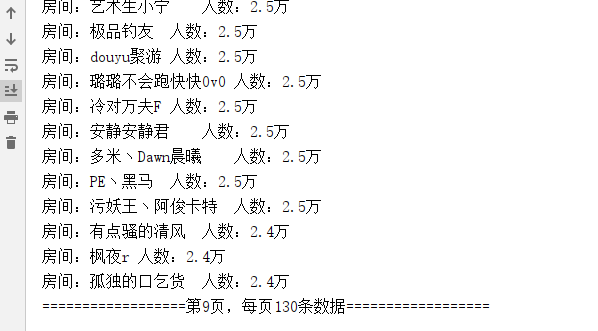
结果如图:

Python 之selenium+phantomJS斗鱼抓取案例的更多相关文章
- 数据抓取的艺术(一):Selenium+Phantomjs数据抓取环境配置
数据抓取的艺术(一):Selenium+Phantomjs数据抓取环境配置 2013-05-15 15:08:14 分类: Python/Ruby 数据抓取是一门艺术,和其他软件不同,世界上 ...
- Python开发爬虫之动态网页抓取篇:爬取博客评论数据——通过Selenium模拟浏览器抓取
区别于上篇动态网页抓取,这里介绍另一种方法,即使用浏览器渲染引擎.直接用浏览器在显示网页时解析 HTML.应用 CSS 样式并执行 JavaScript 的语句. 这个方法在爬虫过程中会打开一个浏览器 ...
- Selenium模拟浏览器抓取淘宝美食信息
前言: 无意中在网上发现了静觅大神(崔老师),又无意中发现自己硬盘里有静觅大神录制的视频,于是乎看了其中一个,可以说是非常牛逼了,让我这个用urllib,requests用了那么久的小白,体会到sel ...
- 使用selenium模拟浏览器抓取淘宝信息
通过Selenium模拟浏览器抓取淘宝商品美食信息,并存储到MongoDB数据库中. from selenium import webdriver from selenium.common.excep ...
- python网络爬虫-动态网页抓取(五)
动态抓取的实例 在开始爬虫之前,我们需要了解一下Ajax(异步请求).它的价值在于在与后台进行少量的数据交换就可以使网页实现异步更新. 如果使用Ajax加载的动态网页抓取,有两种方法: 通过浏览器审查 ...
- python爬虫beta版之抓取知乎单页面回答(low 逼版)
闲着无聊,逛知乎.发现想找点有意思的回答也不容易,就想说要不写个爬虫帮我把点赞数最多的给我搞下来方便阅读,也许还能做做数据分析(意淫中--) 鉴于之前用python写爬虫,帮运营人员抓取过京东的商品品 ...
- 利用python脚本(xpath)抓取数据
有人会问re和xpath是什么关系?如果你了解js与jquery,那么这个就很好理解了. 上一篇:利用python脚本(re)抓取美空mm图片 # -*- coding:utf-8 -*- from ...
- Python爬虫实战四之抓取淘宝MM照片
原文:Python爬虫实战四之抓取淘宝MM照片其实还有好多,大家可以看 Python爬虫学习系列教程 福利啊福利,本次为大家带来的项目是抓取淘宝MM照片并保存起来,大家有没有很激动呢? 本篇目标 1. ...
- Python爬虫实战六之抓取爱问知识人问题并保存至数据库
大家好,本次为大家带来的是抓取爱问知识人的问题并将问题和答案保存到数据库的方法,涉及的内容包括: Urllib的用法及异常处理 Beautiful Soup的简单应用 MySQLdb的基础用法 正则表 ...
随机推荐
- [Dart] Understand Variables and Constants in Dart
In this lesson, we will look at how to create variables and constants. These are containers that sto ...
- Python3基础(二) 基本数据类型
Python中的变量不需要声明.每个变量在使用前都必须赋值,变量赋值以后该变量才会被创建.在Python中,变量就是变量,它没有类型,我们所说的"类型"是变量所指的内存中对象的类型 ...
- 【Cocos2dx游戏开发】Cocos2d-x简介
一.简介 最近在做一个Android下的卡牌游戏--<九州幻想>开发项目,而我们使用的引擎是Cocos2dx,所以想要写写笔记来记录一下项目中的收获.当然首先稍微介绍一下Cocos2d-x ...
- 2015:WPS笔试-Android开发岗位
题目一共三道: 一:实现一个函数,能够推断两条直线的关系:平行.重合.垂直或相交. 二:实现一个函数.能够得到随意两个日期的相隔天数. 三:针对题目一或题目二,实现一个完整的单元測试. (笔试后在网上 ...
- impex 语法
impex 语法 2016-01-14 16:23 588人阅读 评论(0) 收藏 举报 分类: hybris(8) 脱离java Model单纯的去看impex文件的代码是不能很好理解impex ...
- Hadoop生态系统学习路线
主要介绍Hadoop家族产品,经常使用的项目包含Hadoop, Hive, Pig, HBase, Sqoop, Mahout, Zookeeper, Avro, Ambari, Chukwa.新添加 ...
- react State改变,页面却没有改变
react 小白编程 做项目时遇到了个问题,无论我怎么查看我的action.reducer 还是 dispatch 函数,都没有发现有什么毛病.但是 debugger 的时候,state 改变了,页面 ...
- Android中静态变量的生命周期
静态变量的生命周期,起始于类的加载,终止于类的释放.什么时候类会加载呢?我们知道,在app打开时,会创建一个进程,然后初始化一个dvm的实例,负责类的加载释放 和 垃圾回收等.换句话说,在进程创建之后 ...
- MDK链接脚本错误
我想让我的程序运行在RAM中而不是在SPI FLASH上,写了一个scatterfile: ROM 0x00000000 0x00200000 ;spi flash{STARTUP +0 { star ...
- golang函数——可以为类型(包括内置数据类型)定义函数,类似类方法,同时支持多返回值
不可或缺的函数,在Go中定义函数的方式如下: func (p myType ) funcName ( a, b int , c string ) ( r , s int ) { return } 通过 ...