
Java调用Kettle
Java 调用 kettle,难的不是怎么调用,而是解决 maven 依赖冲突问题,
直接将 kettle 依赖,添加到我们的 maven 工程,可能会导致代码大范围报错;
解决方案也很简单,就是直接从 spoon 的 lib 目录下,复制我们所需的 jar 包,按需导入我们的工程。
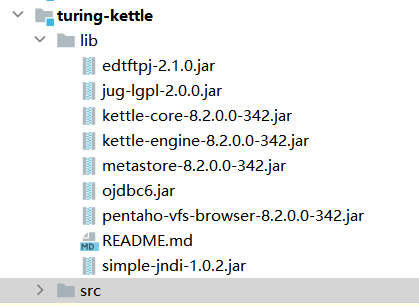
主要用到的jar包如下,这些足以调起 kettle 脚本,剩下的还有 ftp、http 等服务,用啥加啥。
比如:下面没有 ftp 的依赖,如果 kettle 脚本是处理 ftp 的,那就会报错,
这时候就要根据报错信息,去 kettle 工程的pom.xml文件中,把 ftp 相关的依赖找出来。(去lib目录找jar包也一样)
这里就不提供工具包了,换成 apache 的 commons,照着意思自己改一改。
import cn.seaboot.commons.core.Converter;

import cn.seaboot.commons.exception.SystemError;

import cn.seaboot.commons.file.FileUtils;

import cn.seaboot.commons.file.IOUtils;

import cn.seaboot.commons.file.PropertiesUtils;

import org.pentaho.di.core.KettleEnvironment;

import org.pentaho.di.core.database.DatabaseMeta;

import org.pentaho.di.core.exception.KettleException;

import org.pentaho.di.core.logging.ChannelLogTable;

import org.pentaho.di.core.logging.JobEntryLogTable;

import org.pentaho.di.core.logging.JobLogTable;

import org.pentaho.di.job.Job;

import org.pentaho.di.job.JobMeta;

import org.slf4j.Logger;

import org.slf4j.LoggerFactory;

import org.springframework.stereotype.Service;

import javax.annotation.PostConstruct;

import javax.annotation.PreDestroy;

import java.io.File;

import java.io.IOException;

import java.io.InputStream;

import java.util.HashMap;

import java.util.Map;

import java.util.Properties;

/**

 * Kettle桥接器,通过这个类,调用使用Kettle提供的jar包运行脚本

 * <p>

 * KettleBridge kettleBridge = new KettleBridge();

 * kettleBridge.init();

 * kettleBridge.execute(filepath, null);

 *

 * @author Mr.css

 * @version 2022-03-28 14:44

 */

@Service

public class KettleBridge {

    private Logger logger = LoggerFactory.getLogger(KettleBridge.class);

    /**

     * Kettle 环境初始化

     */

    @PostConstruct

    public void init() {

        try {

            KettleEnvironment.init();

            logger.debug("【Configuration】Kettle environment init succeed!");

        } catch (KettleException e) {

            throw new SystemError("【Configuration】Kettle Environment build failed!", e);

        }

    }

    /**

     * 设置输出日志,将日志输出到数据库表里

     *

     * @param jobMeta -

     */

    private void initDatabase(JobMeta jobMeta) {

        DatabaseMeta databaseMeta = new DatabaseMeta();

        databaseMeta.setName("med");

        databaseMeta.setDatabaseType("MySQL");

        databaseMeta.setAccessType(DatabaseMeta.TYPE_ACCESS_NATIVE);

        databaseMeta.setHostname("localhost");

        databaseMeta.setDBName("med");

        databaseMeta.setDBPort("3306");

        databaseMeta.setUsername("root");

        databaseMeta.setPassword("root");

        jobMeta.addDatabase(databaseMeta);

        // databaseMeta.name 对应于下面的 connectionName

        // 任务日志

        JobLogTable jobLogTable = JobLogTable.getDefault(jobMeta, jobMeta);

        jobLogTable.setConnectionName("med");

        jobLogTable.setSchemaName("med");

        jobLogTable.setTableName("t_kettle_job_log");

        jobMeta.setJobLogTable(jobLogTable);

        // 任务节点日志

        JobEntryLogTable jobEntryLogTable = JobEntryLogTable.getDefault(jobMeta, jobMeta);

        jobEntryLogTable.setConnectionName("med");

        jobEntryLogTable.setSchemaName("med");

        jobEntryLogTable.setTableName("t_kettle_item_log");

        jobMeta.setJobEntryLogTable(jobEntryLogTable);

        // 任通道日志

        ChannelLogTable channelLogTable = ChannelLogTable.getDefault(jobMeta, jobMeta);

        channelLogTable.setConnectionName("med");

        channelLogTable.setSchemaName("med");

        channelLogTable.setTableName("t_kettle_channel_log");

        jobMeta.setChannelLogTable(channelLogTable);

    }

    /**

     * Kettle 环境销毁

     */

    @PreDestroy

    public void shutdown() {

        KettleEnvironment.shutdown();

    }

    /**

     * 执行kettle脚本,Kettle以文件作为脚本的最小单位,提供脚本所在的绝对路即可

     *

     * @param path   脚本路径

     * @param params 脚本运行所需的参数变量

     * @return 执行结果

     * @throws KettleException run kettle cause any exception

     * @throws IOException     can not read kettle.properties

     */

    public JobResult execute(String path, Map<String, Object> params) throws KettleException, IOException {

        // 初始化job路径

        JobMeta jobMeta = new JobMeta(path, null);

        Job job = new Job(null, jobMeta);

        // 设置环境变量

        Map<String, String> en = this.loadVariable(params);

        for (Map.Entry<String, String> entry : en.entrySet()) {

            job.setVariable(entry.getKey(), entry.getValue());

        }

        // 日志设置

        this.initDatabase(jobMeta);

        // 启动等待直到结束

        job.start();

        job.waitUntilFinished();

        // 为了避免出现意外的编程,通过对象打包执行结果,不返回Job对象

        JobResult result = new JobResult();

        result.setBatchId(job.getBatchId());

        result.setErrors(job.getErrors());

        result.setPassedBatchId(job.getPassedBatchId());

        result.setStatus(job.getStatus());

        result.setParams(en);

        return result;

    }

    /**

     * 载入环境变量

     * 这种写法不是最优的,会损耗一部分性能,主要为了方便整理代码

     *

     * @param params 用户指定的变量

     * @return 最终使用的变量

     * @throws IOException 读取配置异常

     */

    private Map<String, String> loadVariable(Map<String, Object> params) throws IOException {

        Map<String, String> result = new HashMap<>();

        // 用户文件夹下的kettle.properties

        Properties properties = this.readKettleProperties();

        if (properties != null) {

            for (Map.Entry<Object, Object> entry : properties.entrySet()) {

                result.put(Converter.toString(entry.getKey()), Converter.toString(entry.getValue()));

            }

        }

        // 用户指定的环境变量

        if (params != null) {

            for (Map.Entry<String, Object> entry : params.entrySet()) {

                result.put(entry.getKey(), Converter.toString(entry.getValue()));

            }

        }

        return result;

    }

    /**

     * 获取kettle配置参数,读取用户文件夹下的kettle.properties

     *

     * @return 参数

     * @throws IOException can not read kettle.properties

     */

    private Properties readKettleProperties() throws IOException {

        String home = FileUtils.getUserDirectoryPath();

        if (home != null) {

            File file = new File(home, ".kettle/kettle.properties");

            if (file.exists()) {

                try (InputStream is = IOUtils.openFileInputStream(file)) {

                    return PropertiesUtils.load(is);

                }

            }

        } else {

            logger.debug("Can not found user.home, had batter find out why!");

        }

        return null;

    }

}
Java调用Kettle的更多相关文章
- java调用kettle的job和transfer工具类
package com.woaiyitiaocai.util; import java.util.Map; import java.util.UUID; import org.apache.log4j ...
- 运用Java调用Kettle Job和Trans(带参数)
1.首先创建一个kettle trans 2.对表输入进行编辑 ${dateNow}为要传入的参数. 3.代码编写 首先需要把包导入 import org.pentaho.di.core.Kettle ...
- java程序调用kettle
(1).将相应的kettle的jar包导入的java项目,主要的jar包有一下几个. (2).java程序. package cn.com.taiji.oosweb.test.web; import ...
- java调用kettle_实现(2)
(1).参照“java调用kettle_导入jar包(1)”,应用etl工具下lib里的所有jar (2). 最近要对一个系统的数据同步到另一个系统中,要求新系统的数据结果完成之后,实时同步到另一个系 ...
- java调用kettle_导入jar包(1)
版权声明:本文为博主原创文章,未经博主允许不得转载. Java调用Kettle执行任务或转换,需要使用Kettle中的jar,可以先导入lib目录中的几个基本的jar,如:kettle-core.ja ...
- 【Kettle】Java借助Kettle将Excel导入数据
示例功能(仅供测试): 在JAVA项目中,将数据从Excel文件导入数据库中.实现该能有多种方法,而本例则是“不走寻常路”,尝试借助Kettle实现数据导入. 原理: Java中调用存储在Kettle ...
- java中调用kettle转换文件
java中调用kettle转换文件 通过命令行也能够调用,然后java中调用命令行代码也能够.这样没有和java代码逻辑无缝集成.本文说明kettle5.1中假设通过其它API和java代码无缝集成: ...
- JAVA调用 keytool 生成keystore 和 cer 证书
keytool是一个Java数据证书的管理工具, keytool将密钥(key)和证书(certificates)存在一个称为keystore的文件中在keystore里, 包含两种数据: 密钥实体( ...
- java调用mysql服务做备份与恢复
首先添加mysql的bin到环境变量,这样可以简写部分命令,并且做到不依赖系统mysql的具体安装路径. 重启计算机可以让添加的环境变量在java代码中调用时生效.(cmd中生效但java中调用没有生 ...
- 存储过程详解与java调用(转)
存储过程的一些基本语法: --------------创建存储过程----------------- CREATE PROC [ EDURE ] procedure_name [ ; number ] ...
随机推荐
- 初学 Socket.io
概念 Socket.io 是一个支持客户端和服务器之间的低延迟.双向和基于事件的通信的库,除了支持 JavaScript 以外,还支持 Java.Python.Golang. Socket.io 构建 ...
- Postgresql invalid command \N数据恢复处理
做一个单表恢复工作,数据在1000多W,说是报了错误导不进去,环境与流程见下:恢复步骤: 1.导出语句 pg_dump -h xxxxx -p 5432 -U postgres -b -Fp db_t ...
- Dynamics365 DOC
Sample: Early-bound table operationshttps://docs.microsoft.com/en-us/powerapps/developer/data-platfo ...
- java学习日记20230228-数据类型及加号运算
程序中+使用: 1.两侧是数值型,则相加: 2.一方为字符串,则拼接: 3.运算顺序从做到右: 数据类型 每一种数据都定义了明确的数据类型,在内存中分配了不同大小的内存空间: java数据类型 基本数 ...
- python判断文件后缀名
endswith()方法 利用文件名或路径名对文件后缀进行判断,例如对文件名后缀是否为.jpg的文件进行判断. path = "file.jpg" bool = path.ends ...
- mysql8使用tmpfs内存磁盘当内存数据库的配置方法
序: 内存关系数据库没有找到开源好用的,很多都是商用.虽然mysql有memory引擎,但写是整体锁表,没法用. 一直想将mysql放入内存中,搜索n次资料,没找到合适的,可能之前思路不对. 最近在测 ...
- redis底层数据结构之字典(dict)
字典(dict) 字典又称为符号表或者关联数组.或映射(map),是一种用于保存键值对(key-value)的抽象数据结构 字典中的每个key都是唯一的,通过key对值来进行查找或修改,时间复杂度为 ...
- (app笔记)Appium如何开启、配置、启用
1.安装adb 2.打开手机调试 3.连接手机 4.appium运行前,手机需要io.appium.uiautomator2.server 和 Appium Settings. 5.appium操作: ...
- 电商项目maven框架搭建引入dubbo配置文件报错
解决:dubbo配置文件报红叉的问题 构建dobbo-provider配置文件时,报红叉错误,本质即找不到对应的dubbo.xsd文件. 1.下载模板 模板下载地址:http://download.c ...
- Libusb测试USB device(2)
因为测试的比较混乱,我就按照我的问题导向来描述我的过程吧 一. 提示libusb_context对象为NULL的错误: 在简化的过程中,我没有加入dev_handler判断为空就进行了具体的工作: 1 ...