
Spark:利用Eclipse构建Spark集成开发环境
前一篇文章“Apache Spark学习:将Spark部署到Hadoop 2.2.0上”介绍了如何使用Maven编译生成可直接运行在Hadoop 2.2.0上的Spark jar包,而本文则在此基础上,介绍如何利用Eclipse构建Spark集成开发环境。
(1) 准备工作
在正式介绍之前,先要以下软硬件准备:
软件准备:
Eclipse Juno版本(4.2版本),可以直接点击这里下载:Eclipse 4.2
Scala 2.9.3版本,Window安装程序可以直接点击这里下载:Scala 2.9.3
Eclipse Scala IDE插件,可直接点击这里下载:Scala IDE(for Scala 2.9.x and Eclipse Juno)
硬件准备
装有Linux或者Windows操作系统的机器一台
(2) 构建Spark集成开发环境
我是在windows操作系统下操作的,流程如下:
步骤1:安装scala 2.9.3:直接点击安装即可。
步骤2:将Eclipse Scala IDE插件中features和plugins两个目录下的所有文件拷贝到Eclipse解压后对应的目录中
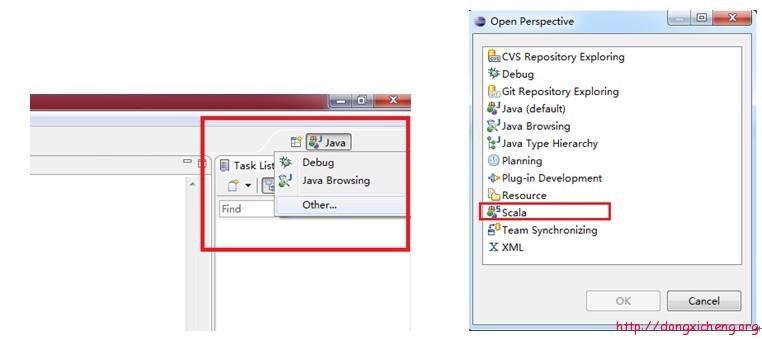
步骤3:重新启动Eclipse,点击eclipse右上角方框按钮,如下图所示,展开后,点击“Other….”,查看是否有“Scala”一项,有的话,直接点击打开,否则进行步骤4操作。
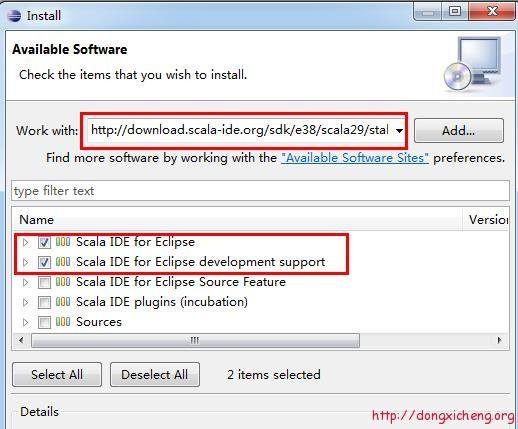
步骤4:在Eclipse中,依次选择“Help” –> “Install New Software…”,在打开的卡里填入http://download.scala-ide.org/sdk/e38/scala29/stable/site,并按回车键,可看到以下内容,选择前两项进行安装即可。(由于步骤3已经将jar包拷贝到eclipse中,安装很快,只是疏通一下)安装完后,重复操作一遍步骤3便可。
(3) 使用Scala语言开发Spark程序
在eclipse中,依次选择“File” –>“New” –> “Other…” –> “Scala Wizard” –> “Scala Project”,创建一个Scala工程,并命名为“SparkScala”。
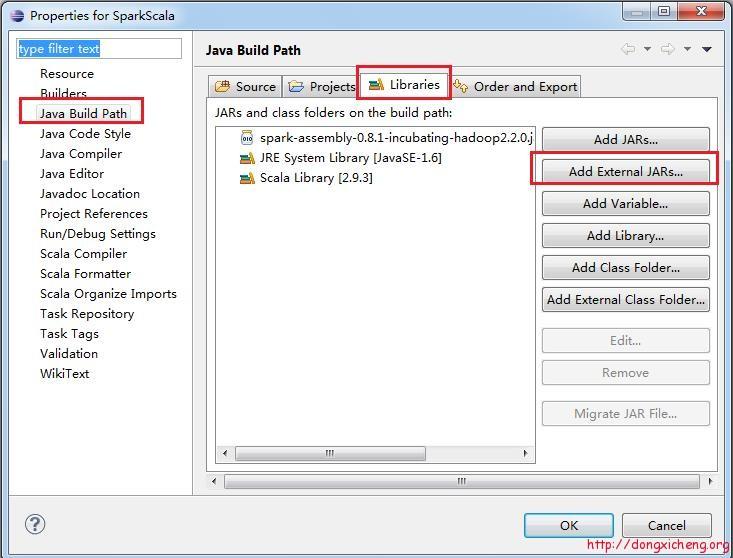
右击“SaprkScala”工程,选择“Properties”,在弹出的框中,按照下图所示,依次选择“Java Build Path” –>“Libraties” –>“Add External JARs…”,导入文章“Apache Spark:将Spark部署到Hadoop 2.2.0上”中给出的
assembly/target/scala-2.9.3/目录下的spark-assembly-0.8.1-incubating- hadoop2.2.0.jar,这个jar包也可以自己编译spark生成,放在spark目录下的assembly/target/scala- 2.9.3/目录中。
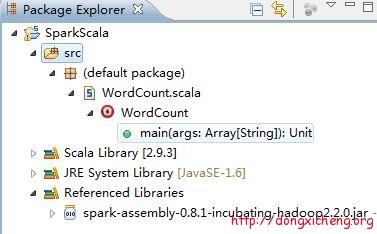
跟创建Scala工程类似,在工程中增加一个Scala Class,命名为:WordCount,整个工程结构如下:
WordCount就是最经典的词频统计程序,它将统计输入目录中所有单词出现的总次数,Scala代码如下:
- import org.apache.spark._
- import SparkContext._
- object WordCount {
- def main(args: Array[String]) {
- if (args.length != 3 ){
- println("usage is org.test.WordCount <master> <input> <output>")
- return
- }
- val sc = new SparkContext(args(0), "WordCount",
- System.getenv("SPARK_HOME"), Seq(System.getenv("SPARK_TEST_JAR")))
- val textFile = sc.textFile(args(1))
- val result = textFile.flatMap(line => line.split("\\s+"))
- .map(word => (word, 1)).reduceByKey(_ + _)
- result.saveAsTextFile(args(2))
- }
- }
在Scala工程中,右击“WordCount.scala”,选择“Export”,并在弹出框中选择“Java” –> “JAR File”,进而将该程序编译成jar包,可以起名为“spark-wordcount-in-scala.jar”,我导出的jar包下载地址是 spark-wordcount-in-scala.jar。
该WordCount程序接收三个参数,分别是master位置,HDFS输入目录和HDFS输出目录,为此,可编写run_spark_wordcount.sh脚本:
|
需要注意以下几点:WordCount程序的输入参数通过“-args”指定,每个参数依次单独指定,第二个参数是HDFS上的输入目录,需要事先创建好,并上传几个文本文件,以便统计词频,第三个参数是HDFS上的输出目录,动态创建,运行前不能存在。
直接运行run_spark_wordcount.sh脚本即可得到运算结果。
在运行过程中,发现一个bug,org.apache.spark.deploy.yarn.Client有一个参数“–name”可以指定应用程序名称:
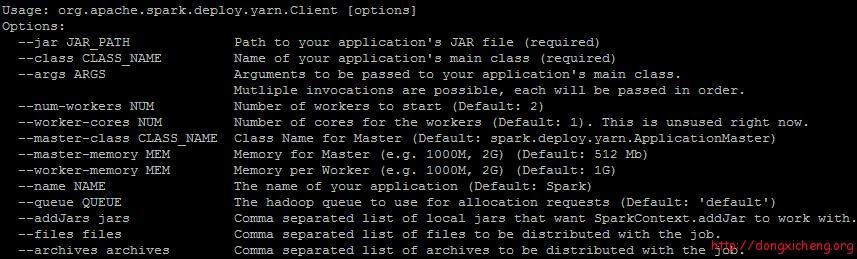
但是使用过程中,该参数会阻塞应用程序,查看源代码发现原来是个bug,该Bug已提交到Spark jira上:
- // 位置:new-yarn/src/main/scala/org/apache/spark/deploy/yarn/ClientArguments.scala
- case ("--queue") :: value :: tail =>
- amQueue = value
- args = tail
- case ("--name") :: value :: tail =>
- appName = value
- args = tail //漏了这行代码,导致程序阻塞
- case ("--addJars") :: value :: tail =>
- addJars = value
- args = tail
因此,大家先不要使用“–name”这个参数,或者修复这个bug,重新编译Spark。
(4) 使用Java语言开发Spark程序
方法跟普通的Java程序开发一样,只要将Spark开发程序包spark-assembly-0.8.1-incubating-hadoop2.2.0.jar作为三方依赖库即可。
(5) 总结
初步试用Spark On YARN过程中,发现问题还是非常多,使用起来非常不方便,门槛还是很高,远不如Spark On Mesos成熟。
Spark:利用Eclipse构建Spark集成开发环境的更多相关文章
- Spark Streaming揭秘 Day28 在集成开发环境中详解Spark Streaming的运行日志内幕
Spark Streaming揭秘 Day28 在集成开发环境中详解Spark Streaming的运行日志内幕 今天会逐行解析一下SparkStreaming运行的日志,运行的是WordCountO ...
- 集成开发环境(IDE)
学习目标: 1.了解Java的IDE开发工具 2.会使用Eclipse.IDEA开发工具新建项目,编写代码,并运行程序. 学习过程: 使用文本开发效率无疑是很低的,每次编写完代码后,还需要手动的编译执 ...
- Spark+ECLIPSE+JAVA+MAVEN windows开发环境搭建及入门实例【附详细代码】
http://blog.csdn.net/xiefu5hh/article/details/51707529 Spark+ECLIPSE+JAVA+MAVEN windows开发环境搭建及入门实例[附 ...
- 使用Eclipse+Maven+Jetty构建Java Web开发环境(几个教程综合集成2014发行)
工作需要使用Jetty由于web集装箱,得知Eclipse+Maven+Jetty该组合是非常好的,因此,要在网上找了很多教程,但不写或多或少特定的或过时的内容而导致最终的配置失败,易于配置为未来的同 ...
- Python集成开发环境(Eclipse+Pydev)
刚開始学习python,就用Editplus, Notepad++来写小程序, 后来接触了Sublime Text2.认为很不错,没事写写代码.就用编辑器Sublime Text2,最好再配搭一个ap ...
- [国嵌笔记][019][Eclipse集成开发环境]
Eclipse集成开发环境的作用 可以编译程序,也可以对程序进行在线调试 集成开发环境 1.JLink连接开发板的JTAG 2.JLink连接PC的USB 3.eclipse软件 4.gdb serv ...
- ROS_Kinetic_08 ROS的集成开发环境(IDEs)之使用Eclipse
ROS_Kinetic_08 ROS的集成开发环境(IDEs)之使用Eclipse ROS支持的IDEs比较丰富,这里以Eclipse为例介绍一下. 具体内容参考:http://wiki.ros.or ...
- 五款实用免费的Python机器学习集成开发环境(5 free Python IDE for Machine Learning)(图文详解)
前言 集成开发环境(IDE)是提供给程序员和开发者的一种基本应用,用来编写和测试软件.一般而言,IDE 由一个编辑器,一个编译器(或称之为解释器),和一个调试器组成,通常能够通过 GUI(图形界面)来 ...
- Android开发新手学习总结(一)——使用Android Studio搭建Android集成开发环境
[新手连载]一:使用Android Studio搭建Android集成开发环境http://bbs.itcast.cn/forum.php?mod=viewthread&tid=87055&a ...
随机推荐
- Chrome 35个开发者工具的小技巧
来源:w3cplus - 南北(@ping4god) 网址:http://www.w3cplus.com/tools/dev-tips.html 谷歌浏览器如今是Web开发者们所使用的最流行的网页浏览 ...
- ASP.NET访问Excel 失败的解决方法(错误号:80070005,8000401a)
用asp.net把值写入Excel在本地测试通过,然后提交服务器后老是写入不成功 并提示错误: Retrieving the COM class factory for component with ...
- C#删除程序自身【总结】
偶然看到一个可以自删除的程序,于是了解下如何实现.然后整理如下: 思路: 在.NET程序中,因为运行中的程序是受系统保护的,不能自己删除自身的,所以自删除的思路: 在关闭本程序之前启动新的进程打开另 ...
- bitbucket+sourcetree+p4merge for windows 版本控制
这里选择bitbucket作为仓库的原因是,它能够在设置私有仓库的前提下组建5人团队 一:https://bitbucket.org/ 注册bitbucket 二:http://www.sourcet ...
- Java集合源码分析(一)
Java集合工具包位于Java.util包下,包含了很多常用的数据结构,如数组.链表.栈.队列.集合.哈希表等.学习Java集合框架下大致可以分为如下五个部分:List列表.Set集合.Map映射.迭 ...
- extern的用法
extern作为外部函数声明的用法: 1. 可以扩展函数的应用范围: 107.h #ifndef _107H_ #def _107H_ extern void func(); #endif 107.c ...
- nodejs操作mongodb数据库封装DB类
这个DB类也算是我经历了3个实际项目应用的,现分享出来,有需要的请借鉴批评. 上面的注释都挺详细的,我使用到了nodejs的插件mongoose,用mongoose操作mongodb其实蛮方便的. 关 ...
- Git远程和分支管理
一.远程 Git是分布式版本控制系统,最重要的优点就是远程仓库托管代码.不用自己搭建一个服务器,在github上面注册一个账户就可免费获取远程仓库. 首先需要先在github上面 ...
- 对chain.doFilter(request,response)的理解
他的作用是将请求转发给过滤器链上下一个对象.这里的“下”指的是哪里 ? 指的是下一个filter,如果没有filter那就是你请求的资源. 一般filter都是一个链,web.xml 里面配置了几个就 ...
- Number()、parseInt() 和 parseFloat() 的区别
一:Number() 如果是Boolean值,true和false值将分别被转换为1和0. 如果是数字值,只是简单的传入和返回. 如果是null值,返回0. 如果是undefined,返回NaN. 如 ...