
机器学习入门实战——基于knn的airbnb房租预测
数据读取
import pandas as pd

features=['accommodates','bathrooms','bedrooms','beds','price','minimum_nights','maximum_nights','number_of_reviews']

dc_listings=pd.read_csv('listings.csv')

dc_listings=dc_listings[features]

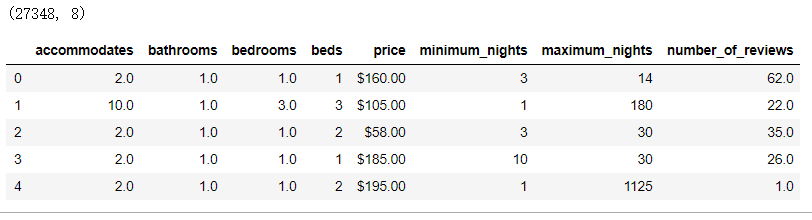
print(dc_listings.shape)

dc_listings.head()
运行结果:
K:候选对象个数,近邻数(如找3个和自己最近的样本)
import numpy as np

our_acc_value=3#房间数为3个

dc_listings['distance']=np.abs(dc_listings.accommodates-our_acc_value)#为dc_listings新增distance列,用于保存当前房间数与3的差值

dc_listings.distance.value_counts().sort_index()#统计各差值的情况
输出:
0.0      3370

1.0     17967

1.5         2

2.0      3865

3.0      1250

4.0       221

5.0       334

6.0        58

7.0       125

8.0        15

9.0        44

10.0        5

11.0       14

12.0        5

13.0       73

Name: distance, dtype: int64
原始数据统计过程中可能会存在一些规律,一般需要进行洗牌操作,打乱原有秩序(使用sample函数)
dc_listings=dc_listings.sample(frac=1,random_state=0)#洗牌 frac:抽取行的比例,1为100%  random_state:0表示不得取重复数据 1表示可以取重复数据

dc_listings=dc_listings.sort_values('distance')#统计差值(房间数-3)的情况 将dc_listings按照distance列排序 将和房间数3最近的放在最前面

dc_listings.price.head()#取前5条的价格 由于数据时乱的,所以id和price均无规律
输出结果:
2732     $129.00

14798    $249.00

27309    $170.00

20977    $169.00

11178    $100.00

Name: price, dtype: object
对价格进行类型转换,去掉$符号,转换成float,然后对前五个价格取均值,用前5个的均值来预测当前房价
dc_listings['price']=dc_listings.price.str.replace("\$|,",'').astype(float)

mean_price=dc_listings.price.iloc[:5].mean()

mean_price
输出:163.4
拿75%的数据作为训练集,25%的数据作为测试集来进行模型的评估,训练集和测试集不可重复。
dc_listings.drop('distance',axis=1)#删除distance列

train_df=dc_listings.copy().iloc[:20544]#27392*0.75行为训练集

test_df=dc_listings.copy().iloc[20544:]#剩下的作为测试集(27392*0.25)
基于单变量预测价格
#new_listing_value:当前样本的feature_clolumn(如accomodates)列属性取值

#feture_column:计算房租使用的单属性

def predict_price(new_listing_value,feature_column):

    temp_df=train_df#使用训练集来预测测试集房租结果

    dc_listings[feature_column]=train_df[feature_column].astype(float)#统一将格式转换成float否则会报错

    temp_df['distance']=np.abs(train_df[feature_column]-new_listing_value)

    temp_df=temp_df.sort_values('distance')

    knn_5=temp_df.price.iloc[:5]

    predict_price=knn_5.mean()

    return(predict_price)
对测试集的每一条记录使用accomodates属性预测其房租价格
#new_listing_value的值即为accommodates的取值

test_df['predicted_price']=test_df.accommodates.apply(predict_price,feature_column='accommodates')

test_df.predicted_price.head()
输出:
14122    134.0

23556    418.0

16317    134.0

26230    134.0

19769    134.0

Name: predicted_price, dtype: float64
root mean square error(RMSE)均方根误差
得到每个样本的预测值后计算均方根误差用于评估模型(值越小模型越好)
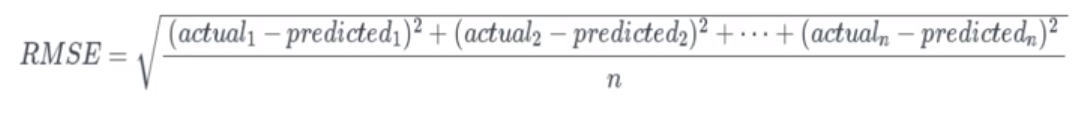
test_df['squared_error']=(test_df['predicted_price']-test_df['price'])**(2)

mse=test_df['squared_error'].mean()

rmse=mse**(1/2)

rmse
输出结果:
348.689169172284
试试不同的变量(属性)
for feature in ['accommodates','bedrooms','bathrooms','number_of_reviews']:

    test_df['predicted_price']=test_df[feature].apply(predict_price,feature_column=feature)

    test_df['squared_error']=(test_df['predicted_price']-test_df['price'])**(2)

    mse=test_df['squared_error'].mean()

    rmse=mse**(1/2)

    print("RMSE for the {} column:{}".format(feature,rmse))
输出:
RMSE for the accommodates column:348.689169172284

RMSE for the bedrooms column:344.64855009943

RMSE for the bathrooms column:361.1230782594195

RMSE for the number_of_reviews column:383.4946020709275

注:由于每个测试集中的样本都要与训练集中样本一一比对,所以上述程序运行时间较长,需要耐心等待……
标准化
同时使用多个属性——如房间数(个位数)和房间面积(几十甚至上百)进行计算的时候,由于变量取值范围的不同(取值范围大的影响较大)会导致对计算结果的不良影响(如计算欧式距离时,房间面积差值平方计算结果通常较大,而房间数差值平方较小),而各个属性是独立的即它们是同等重要的,所以需要对数据进行标准化,如采用z-score标准化或归一化等手段进行预处理
z-score 标准化(Z-score normalization)
要求数据总体均值μ=0 标准差σ=1
转换公式如下:
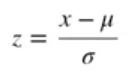
其中μ为原始数据均值,
机器学习入门实战——基于knn的airbnb房租预测的更多相关文章
- web安全之机器学习入门——3.1 KNN/k近邻
目录 sklearn.neighbors.NearestNeighbors 参数/方法 基础用法 用于监督学习 检测异常操作(一) 检测异常操作(二) 检测rootkit 检测webshell skl ...
- 分享《机器学习实战基于Scikit-Learn和TensorFlow》中英文PDF源代码+《深度学习之TensorFlow入门原理与进阶实战》PDF+源代码
下载:https://pan.baidu.com/s/1qKaDd9PSUUGbBQNB3tkDzw <机器学习实战:基于Scikit-Learn和TensorFlow>高清中文版PDF+ ...
- Spark入门实战系列--8.Spark MLlib(上)--机器学习及SparkMLlib简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .机器学习概念 1.1 机器学习的定义 在维基百科上对机器学习提出以下几种定义: l“机器学 ...
- Spark入门实战系列--8.Spark MLlib(下)--机器学习库SparkMLlib实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .MLlib实例 1.1 聚类实例 1.1.1 算法说明 聚类(Cluster analys ...
- 向大家介绍我的新书:《基于股票大数据分析的Python入门实战》
我在公司里做了一段时间Python数据分析和机器学习的工作后,就尝试着写一本Python数据分析方面的书.正好去年有段时间股票题材比较火,就在清华出版社夏老师指导下构思了这本书.在这段特殊时期内,夏老 ...
- 基于股票大数据分析的Python入门实战(视频教学版)的精彩插图汇总
在我写的这本书,<基于股票大数据分析的Python入门实战(视频教学版)>里,用能吸引人的股票案例,带领大家入门Python的语法,数据分析和机器学习. 京东链接是这个:https://i ...
- 【机器学习】机器学习入门01 - kNN算法
0. 写在前面 近日加入了一个机器学习的学习小组,每周按照学习计划学习一个机器学习的小专题.笔者恰好近来计划深入学习Python,刚刚熟悉了其基本的语法知识(主要是与C系语言的差别),决定以此作为对P ...
- Spark入门实战系列--1.Spark及其生态圈简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .简介 1.1 Spark简介 年6月进入Apache成为孵化项目,8个月后成为Apache ...
- Spark入门实战系列--3.Spark编程模型(上)--编程模型及SparkShell实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark编程模型 1.1 术语定义 l应用程序(Application): 基于Spar ...
随机推荐
- 飞机大战(1)--添加logo和加载动画
注:以下代码都是用scratch 3.0版本编写 素材链接: 链接:https://pan.baidu.com/s/1sXqeZVuFgVTYT0OtqxXilw 提取码:1126 一.背景添加 导入 ...
- canvas性能-drawImage渲染图片
canvas性能-绘制图片 目录 canvas性能-绘制图片 canvas绘制图片 drawImage putImageData createPattern 测试绘制耗时 drawImage Imag ...
- 单台服务器-利用docker搭建Redis哨兵集群模式
前言:只有一台华为云服务器,所以打算创建三个容器来模拟三个服务器了. 一:拉取redis镜像 二:拉取redis.conf文件 放在自定义的目录下:wget -c http://download.re ...
- Seata RPC 模块的重构之路
简介: RPC 模块是我最初研究 Seata 源码开始的地方,因此我对 Seata 的 RPC 模块有过一些深刻研究,在我研究了一番后,发现 RPC 模块中的代码需要进行优化,使得代码更加优雅,交互逻 ...
- Scrapy——將數據保存到MySQL數據庫
Scrapy--將數據保存到MySQL數據庫 1. 在MySQL中創建數據庫表job_inf: 1 Create table job_inf( 2 id int(11) not null auto_i ...
- 为什么 TCP 协议有粘包问题
为什么 TCP 协议有粘包问题 这部分转载自draveness博客. TCP/IP 协议簇建立了互联网中通信协议的概念模型,该协议簇中的两个主要协议就是 TCP 和 IP 协议.TCP/ IP 协议簇 ...
- Angular入门到精通系列教程(14)- Angular 编译打包 & Docker发布
目录 1. 概要 2. 编译打包 2.1. 基本打包命令 2.2. 打包部署到二级目录 3. Angular站点的发布 3.1. web服务器发布 3.2. 使用docker发布 4. 总结 环境: ...
- Redis集群动态增加和删除节点
一.添加节点 1.首先将需要添加的节点启动: 这里启动redis6383.conf和redis6393.conf两个节点 查看原有节点: 3个主节点所对应的哈希槽(hash slo ...
- LOJ10132
在 Adera 的异时空中有一张地图.这张地图上有 N 个点,有 N-1 条双向边把它们连通起来.起初地图上没有任何异象石,在接下来的 M 个时刻中,每个时刻会发生以下三种类型的事件之一: 地图的某个 ...
- Spring MVC—数据绑定机制,数据转换,数据格式化配置,数据校验
Spring MVC数据绑定机制 数据转换 Spring MVC处理JSON 数据格式化配置使用 数据校验 数据校验 Spring MVC数据绑定机制 Spring MVC解析JSON格式的数据: 步 ...