
kylin_学习_01_kylin安装部署
一、环境准备
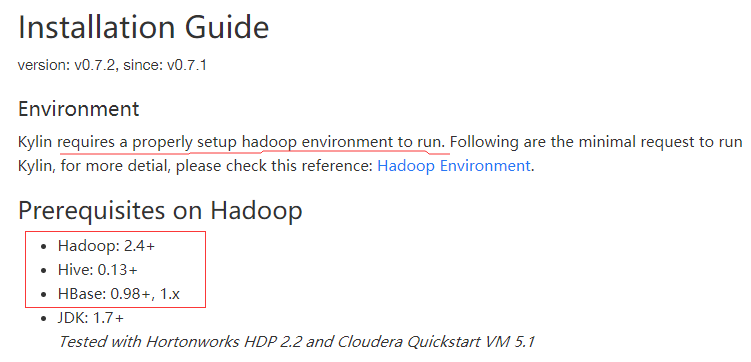
根据官方文档,kylin是需要运行在hadoop环境下的,如下图:
1.hadoop环境搭建
参考:hadoop_学习_02_Hadoop环境搭建(单机)
2.hbase环境搭建
3.hive环境搭建
二、kylin下载与解压
1.下载地址
前往官方 http://kylin.apache.org/download
可发现提供了一个镜像下载地址,如下:
http://mirrors.shu.edu.cn/apache/kylin/apache-kylin-2.3.0/apache-kylin-2.3.0-hbase1x-bin.tar.gz
2.下载
使用命令进行下载
wget http://mirrors.shu.edu.cn/apache/kylin/apache-kylin-2.3./apache-kylin-2.3.-hbase1x-bin.tar.gz
或者先在本地下载,然后上传服务器
3.解压
tar -zxvf apache-kylin-2.3.0-hbase1x-bin.tar.gz
三、kylin配置
1.配置环境变量
(1)编辑 profile 文件
vim /etc/profile
(2)设置 KYLIN_HOME ,并将其添加到path中。并修改 CATALINA_HOME 为 kylin 下的 tomcat
# 1. java

export JAVA_HOME=/usr/java/jdk1..0_80

export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar

# 2. Tomcat

#export CATALINA_HOME=/developer/apache-tomcat-7.0.73

#export CATALINA_HOME=/developer/saiku-server/tomcat

export CATALINA_HOME=/developer/apache-kylin-2.3.0-bin/tomcat

# 3. Maven

export MAVEN_HOME=/developer/apache-maven-3.0.

# 4. hadoop

export HADOOP_HOME=/developer/hadoop-2.6.

# 5. hbase

export HBASE_HOME=/developer/hbase-1.2.

# 6. hive

export HIVE_HOME=/developer/apache-hive-1.1.-bin

export HIVE_CONF_DIR=${HIVE_HOME}/conf

export HCAT_HOME=$HIVE_HOME/hcatalog

# 7. kylin

export KYLIN_HOME=/developer/apache-kylin-2.3.0-bin

export hive_dependency=$HIVE_HOME/conf:$HIVE_HOME/lib/*:$HCAT_HOME/share/hcatalog/hive-hcatalog-core-1.1.0.jar

#Path

# 1. big data

export PATH=$KYLIN_HOME/bin:$PATH

export PATH=$HIVE_HOME/bin:$HBASE_HOME/bin:$HADOOP_HOME/bin:$PATH

export PATH=$MAVEN_HOME/bin:$CATALINA_HOME/bin:$JAVA_HOME/bin:$PATH

export LC_ALL=en_US.UTF-
2.配置 kylin.sh
在文件开始的地方,添加如下配置:
export KYLIN_HOME=/developer/apache-kylin-2.3.0-bin

export HBASE_CLASSPATH_PREFIX=$CATALINA_HOME/bin/bootstrap.jar:$CATALINA_HOME/bin/tomcat-juli.jar:$CATALINA_HOME/lib/*:$hive_dependency:$HBASE_CLASSPATH_PREFIX
四、启动kylin
1.确保 hadoop、hbase已经启动
(1)启动hadoop
进入hadoop 的 sbin 目录,执行
./start-all.sh
(2) 启动 hbase
进入hbase的 bin 目录,执行
./start-hbase.sh
2.启动 kylin
进入 kylin 的 bin 目录,执行
./kylin.sh start
即可启动kylin
3.访问kylin管理界面
启动kylin之后,浏览器访问:http://your_hostname:7070/kylin。输入用户名 ADMIN 、密码 KYLIN ,即可登录
例如:
192.168.1.102:7070/kylin
五、配置hive数据源
1.配置数据源
(1)依次选择 Model -> Data Source -> Load Hive Table
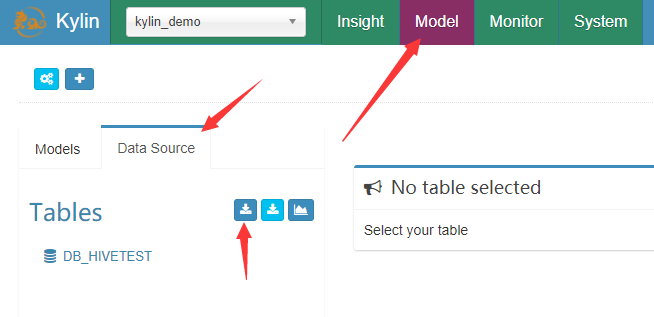
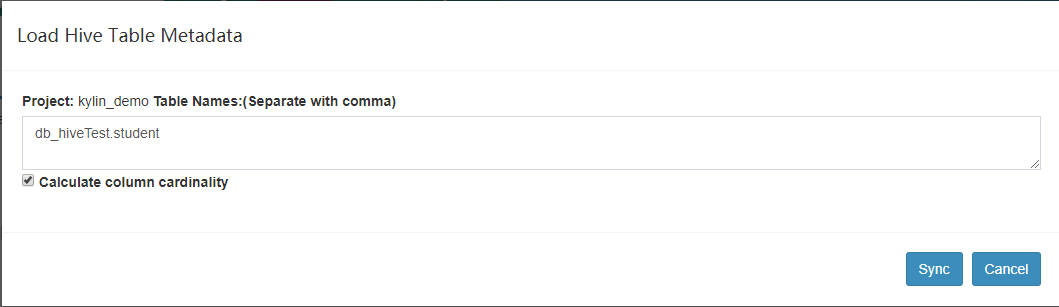
(2)输入 hive 中数据库的表名格式为: 数据库名.数据表名
如:db_hiveTest.student ,然后点击Sync即可。
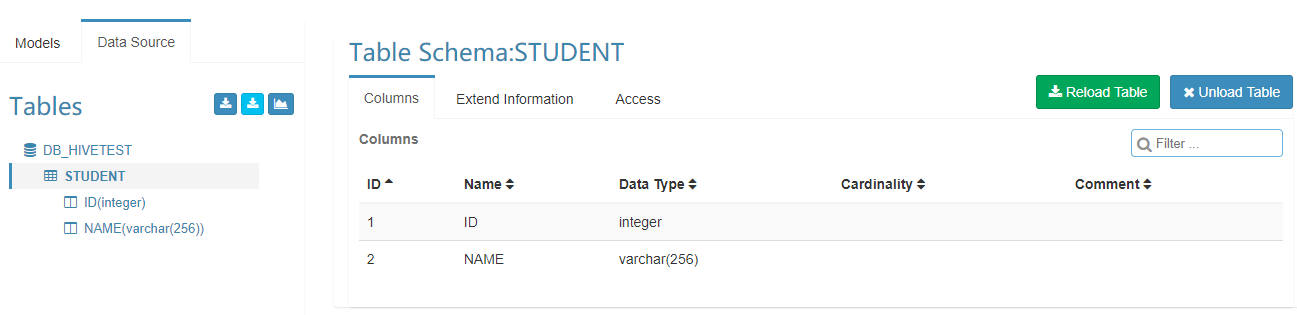
添加成功后,效果如下图:
五、参考资料
1.官方安装向导 :
Installation Guide( http://kylin.apache.org/cn/docs23/install/index.html )
2.HDP下载地址:
https://zh.hortonworks.com/downloads/
kylin_学习_01_kylin安装部署的更多相关文章
- Redis学习01_redis安装部署(centos)
原文: http://www.cnblogs.com/herblog/p/9305668.html Redis学习(一):CentOS下redis安装和部署 1.基础知识 redis是用C语言开发的 ...
- Robot Framework入门学习1 安装部署详解
安装注意: 目前Robot framework-ride不支持python3,安装时请下载python2.7版本. Robot Framework安装时出现了一点小问题,网上没有找到直接的介绍,现将安 ...
- 大数据学习——flume安装部署
1.Flume的安装非常简单,只需要解压即可,当然,前提是已有hadoop环境 上传安装包到数据源所在节点上 然后解压 tar -zxvf apache-flume-1.6.0-bin.tar.gz ...
- 大数据学习——hive安装部署
1上传压缩包 2 解压 tar -zxvf apache-hive-1.2.1-bin.tar.gz -C apps 3 重命名 mv apache-hive-1.2.1-bin hive 4 设置环 ...
- 【Spark学习】Spark 1.1.0 with CDH5.2 安装部署
[时间]2014年11月18日 [平台]Centos 6.5 [工具]scp [软件]jdk-7u67-linux-x64.rpm spark-worker-1.1.0+cdh5.2.0+56-1.c ...
- Hadoop学习------Hadoop安装方式之(二):伪分布部署
要想发挥Hadoop分布式.并行处理的优势,还须以分布式模式来部署运行Hadoop.单机模式是指Hadoop在单个节点上以单个进程的方式运行,伪分布模式是指在单个节点上运行NameNode.DataN ...
- 【Zookeeper学习】Zookeeper-3.4.6安装部署
[时间]2014年11月19日 [平台]Centos 6.5 [工具] [软件]jdk-7u67-linux-x64.rpm zookeeper-3.4.6.tar.gz [步骤] 1. 准备条件 ( ...
- Elasticsearch学习之ElasticSearch 5.0.0 安装部署常见错误或问题
ElasticSearch 5.0.0 安装部署常见错误或问题 问题一: [--06T16::,][WARN ][o.e.b.JNANatives ] unable to install syscal ...
- 大数据技术之_13_Azkaban学习_Azkaban(阿兹卡班)介绍 + Azkaban 安装部署 + Azkaban 实战
一 概述1.1 为什么需要工作流调度系统1.2 常见工作流调度系统1.3 各种调度工具特性对比1.4 Azkaban 与 Oozie 对比二 Azkaban(阿兹卡班) 介绍三 Azkaban 安装部 ...
随机推荐
- 01 mongodb 的特点
mongoDB 介绍(特点.优点.原理) 介绍:MongoDB是一个基于分布式文件存储的数据库.由C++语言编写.旨在为WEB应用提供可扩展的高性能数据存储解决方案. 特点:高性能.易部署.易使用,存 ...
- windows 和 linux 上 循环读取文件名称的区别和方法
function showGetFileName($type){ $url="/opt/mobile_system/gscdn"; //另一台服务器映射到linux过来的路径. # ...
- 最小生成树——Kruskal(克鲁斯卡尔)算法
[0]README 0.1) 本文总结于 数据结构与算法分析, 源代码均为原创, 旨在 理解 Kruskal(克鲁斯卡尔)算法 的idea 并用 源代码加以实现: 0.2)最小生成树的基础知识,参见 ...
- InitialContext和lookup
http://wxg6203.iteye.com/blog/680830 最近因为工作需要开始学习Ejb3,遇到了一个让我很郁闷的事情,做一下小小的总结——小心new InitialContext() ...
- C语言基础知识【变量】
C 变量1.变量其实只不过是程序可操作的存储区的名称.C 中每个变量都有特定的类型,类型决定了变量存储的大小和布局,该范围内的值都可以存储在内存中,运算符可应用于变量上.变量的名称可以由字母.数字和下 ...
- jquery基础研究学习【HTML】
jQuery HTMLjQuery 捕获jQuery 设置jQuery 添加元素jQuery 删除元素jQuery CSS 类jQuery css() 方法jQuery 尺寸 笔记:
- com.netflix.hystrix.contrib.javanica.exception.FallbackDefinitionException: fallback method wasn't found: serviceError([class java.lang.String]) 异常
在使用spring cloud 的 Hystrix 后可能会遇到 如下截图错误: 后台代码如下: 找了好一会经过分析参数方法和原方法参数步一致造成: 修改后代码如下:
- Jmeter 05 JMeter元件详解
1. JMeter 逻辑控制器 Switch条件控制器.While条件控制器.交替控制器.仅一次控制器.随机控制器.随机顺序控制器.条件控制器(如果(if)).循环控制器.录制控制器.ForEach控 ...
- Springboot整合日志时候出现的问题
上图是问题,按照路径去找下,发现其实是jar包重复导致的! 在对应的项目上,右键--->属性(Properties)--->JavaBuild Path 然后选择Libraries 页签 ...
- TFS 中工作项的定制-修改工作流
我们都会用到TFS中的工作项.一般来说,最主要的会用到任务.bug这些工作流来进行项目管理里.但我们发现,实际上,有些模板中的工作流并不能完全符合我们的需要,因此我们会进行工作流的定制操作.下面就会通 ...