
Pandas 基础(9) - 组合方法 merge
首先, 还是以天气为例, 准备如下数据:
df1 = pd.DataFrame({

    'city': ['newyork', 'chicago', 'orlando'],

    'temperature': [21, 24, 32],

})

df2 = pd.DataFrame({

    'city': ['newyork', 'chicago', 'orlando'],

    'humidity': [89, 79, 80],

})

df = pd.merge(df1, df2, on='city')
输出: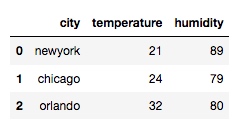
上面的例子就是以 'city' 为基准对两个 dataframe 进行合并, 但是两组数据都是高度一致, 下面调整一下:
df1 = pd.DataFrame({

    'city': ['newyork', 'chicago', 'orlando', 'baltimore'],

    'temperature': [21, 24, 32, 29],

})

df2 = pd.DataFrame({

    'city': ['newyork', 'chicago', 'san francisco'],

    'humidity': [89, 79, 80],

})

df = pd.merge(df1, df2, on='city')
输出: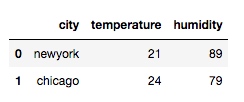
从输出我们看出, 通过 merge 合并, 会取两个数据的交集.
那么, 我们应该可以设想到, 可以通过调整参数, 来达到不同的取值范围.
取并集:
df = pd.merge(df1, df2, on='city', how='outer')
输出: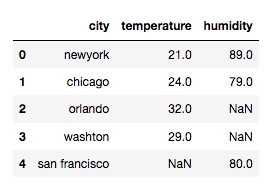
左对齐:
df = pd.merge(df1, df2, on='city', how='left')
输出:
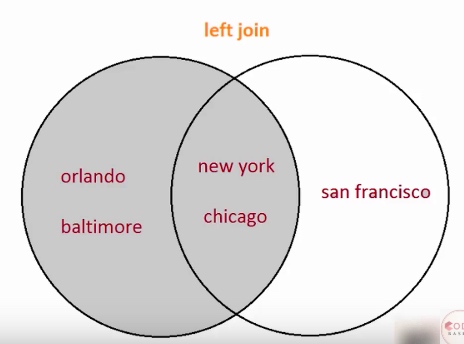
右对齐:
df = pd.merge(df1, df2, on='city', how='right')


另外, 在我们取并集的时候, 我们有时可能会想要知道, 某个数据是来自哪边, 可以通过 indicator 参数来获取:
df = pd.merge(df1, df2, on='city', how='outer', indicator=True)
输出:
在上面的例子中, 被合并的数据的列名是没有冲突的, 所以合并的很顺利, 那么如果两组数据有相同的列名, 又会是什么样呢? 看下面的例子:
df1 = pd.DataFrame({

    'city': ['newyork', 'chicago', 'orlando', 'baltimore'],

    'temperature': [21, 24, 32, 29],

    'humidity': [89, 79, 80, 69],

})

df2 = pd.DataFrame({

    'city': ['newyork', 'chicago', 'san francisco'],

    'temperature': [30, 32, 28],

    'humidity': [80, 60, 70],

})

df = pd.merge(df1, df2, on='city')
输出: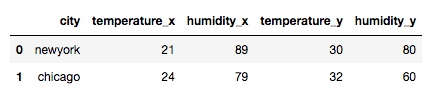
我们发现, 相同的列名被自动加上了 'x', 'y' 作为区分, 为了更直观地观察数据, 我们也可以自定义这个区分的标志:
df3 = pd.merge(df1, df2, on='city', suffixes=['_left', '_right'])
输出: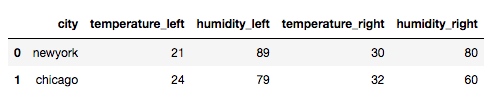
好了, 以上, 就是关于 merge 合并的相关内容, enjoy~~~
Pandas 基础(9) - 组合方法 merge的更多相关文章
- 利用Python进行数据分析(12) pandas基础: 数据合并
pandas 提供了三种主要方法可以对数据进行合并: pandas.merge()方法:数据库风格的合并: pandas.concat()方法:轴向连接,即沿着一条轴将多个对象堆叠到一起: 实例方法c ...
- numpy&pandas基础
numpy基础 import numpy as np 定义array In [156]: np.ones(3) Out[156]: array([1., 1., 1.]) In [157]: np.o ...
- 利用Python进行数据分析(9) pandas基础: 汇总统计和计算
pandas 对象拥有一些常用的数学和统计方法. 例如,sum() 方法,进行列小计: sum() 方法传入 axis=1 指定为横向汇总,即行小计: idxmax() 获取最大值对应的索 ...
- 利用Python进行数据分析(8) pandas基础: Series和DataFrame的基本操作
一.reindex() 方法:重新索引 针对 Series 重新索引指的是根据index参数重新进行排序. 如果传入的索引值在数据里不存在,则不会报错,而是添加缺失值的新行. 不想用缺失值,可以用 ...
- 利用Python进行数据分析(7) pandas基础: Series和DataFrame的简单介绍
一.pandas 是什么 pandas 是基于 NumPy 的一个 Python 数据分析包,主要目的是为了数据分析.它提供了大量高级的数据结构和对数据处理的方法. pandas 有两个主要的数据结构 ...
- Pandas基础学习与Spark Python初探
摘要:pandas是一个强大的Python数据分析工具包,pandas的两个主要数据结构Series(一维)和DataFrame(二维)处理了金融,统计,社会中的绝大多数典型用例科学,以及许多工程领域 ...
- Pandas 基础(1) - 初识及安装 yupyter
Hello, 大家好, 昨天说了我会再更新一个关于 Pandas 基础知识的教程, 这里就是啦......Pandas 被广泛应用于数据分析领域, 是一个很好的分析工具, 也是我们后面学习 machi ...
- 基于 Python 和 Pandas 的数据分析(2) --- Pandas 基础
在这个用 Python 和 Pandas 实现数据分析的教程中, 我们将明确一些 Pandas 基础知识. 加载到 Pandas Dataframe 的数据形式可以很多, 但是通常需要能形成行和列的数 ...
- python学习笔记(四):pandas基础
pandas 基础 serise import pandas as pd from pandas import Series, DataFrame obj = Series([4, -7, 5, 3] ...
随机推荐
- J2EE [web] 403.500.404页面配置
如果想让系统在出错后,看到自定义的错误提示页面,而不是满屏错误原因以及代码. 1.web.xml中 <error-page> <error-code>403</error ...
- [AI][tensorflow][keras] archlinux下 tersorflow and keras 安装
tensorflow TensorFlow is an open-source machine learning library for research and production. https: ...
- HDFS,MapReduce,Hive,Hbase 等之间的关系
HDFS: HDFS是GFS的一种实现,他的完整名字是分布式文件系统,类似于FAT32,NTFS,是一种文件格式,是底层的. Hive与Hbase的数据一般都存储在HDFS上.Hadoop HDFS为 ...
- python 发送无附件邮件
import smtplibimport tracebackfrom email.mime.text import MIMETextfrom config.config import * ...
- caffe编译报错 cudnn.hpp:127:41: error: too few arguments to function ‘cudnnStatus_t cudnnSetPooling2dDescriptor
转载自: https://blog.csdn.net/u011070171/article/details/52292680 这是因为当前版本的caffe的cudnn实现与系统所安装的cudnn的版本 ...
- Apache 2.4.27外网访问403(Forbidden)错误
httpd.conf <Directory /> AllowOverride none #Require all denied 注释这句 Allow from all Require al ...
- 019-并发编程-java.util.concurrent之-Semaphore 信号量
一.概述 Semaphore是一个计数信号量.从概念上将,Semaphore包含一组许可证.如果有需要的话,每个acquire()方法都会阻塞,直到获取一个可用的许可证.每个release()方法都会 ...
- [js]js设计模式-单例模式
单例模式 不同模块之间需要同时开发, // 单例模式: 把描述同一个事物的属性和方法放在同一个内存空间下. // 优点: 分组,防止冲突 // p1 p2也叫做命名空间(模块开发) var p1 = ...
- 【Linux】-NO.87.Assembly.1.滴水逆向.1.001-【介绍】-
1.0.0 Summary Tittle:[Linux]-NO.87.Assembly.1.滴水逆向.1.001-[基础]- Style:Java Series:Log4j Since:2017-04 ...
- day01 格式化输出和while循环的两个小练习
练习1.模拟登陆判断(3次机会) r_name = 'xianyu' r_password = ' i = 3 # 用来控制循环次数 while i > 0: name = input('请输入 ...