
DeepSpeed: 大模型训练框架
背景:
目前,大模型的发展已经非常火热,关于大模型的训练、微调也是各个公司重点关注方向。但是大模型训练的痛点是模型参数过大,动辄上百亿,如果单靠单个GPU来完成训练基本不可能。所以需要多卡或者分布式训练来完成这项工作。
一、分布式训练
1.1 目前主流的大模型分布式训练主要包括两种:
- 数据并行训练
- 模型并行训练
二、DeepSpeed
DeepSpeed是由Microsoft提供的分布式训练工具,旨在支持更大规模的模型和提供更多的优化策略和工具。对于更大模型的训练来说,DeepSpeed提供了更多策略,例如:Zero、Offload等。
2.1 基础组件
分布式训练需要掌握分布式环境中的基础配置,包括节点变化、全局进程编号、局部进程编号、全局总进程数、主节点等。这些组件都跟分布式训练紧密相关,同时组件之间也有非常大的联系,例如通信联系等。
2.2 通信策略
既然是分布式训练,那机器之间必须要保持通信,这样才可以传输模型参数,梯度参数等信息。
DeepSpeed提供了mpi、gioo、nccl等通信策略
| 通信策略 | 通信作用 |
|---|---|
| mpi | 它是一种跨界点的通信库,经常用于CPU集群的分布式训练 |
| gloo | 它是一种高性能的分布式训练框架,可以支持CPU或者GPU的分布式训练 |
| nccl | 它是nvidia提供的GPU专用通信库,广泛用于GPU上的分布式训练 |
我们在使用DeepSpeed进行分布式训练的时候,可以根据自身的情况选择合适的通信库,通常情况下,如果是GPU进行分布式训练,可以选择nccl。
2.3 Zero(零冗余优化器)
Microsoft开发的Zero可以解决分布式训练过程中数据并行和模型并行的限制。比如: Zero通过在数据并行过程中划分模型状态(优化器、梯度、参数),来解决数据并行成可能出现内存冗余的情况(正常数据并行训练,模型全部参数是复制在各个机器上的);同时可以在训练期间使用动态通信计划,在分布式设备之间共享重要的状态变量,这样保持计算粒度和数据并行的通信量。
Zero是用于大规模模型训练优化的技术,它的主要目的是减少模型的内存占用,让模型可以在显卡上训练,内存占用主要分为Model States和Activation两个部分,Zero主要解决的是Model States的内存占用问题。
Zero将模型参数分成三个部分:
| 状态 | 作用 |
|---|---|
| Optimizer States | 优化器在进行梯度更新的时候需要用到的数据 |
| Gradient | 在反向转播过程中产生的数据,其决定参数的更新方向 |
| Model Parameter | 模型参数,在模型训练过程中通过数据“学习”的信息 |
Zero的级别如下:
| 级别 | 作用 |
|---|---|
| Zero-0 | 不使用所有类型的分片,仅使用DeepSpeed作为DDP |
| Zero-1 | 分割Optimizer States, 减少4倍内存,通信容量和数据并行性相同 |
| Zero-2 | 分割Optimizer States和Gradients,减少8倍内存,通信容量和数据并行性相同 |
| Zero-3 | 分割Optimizer States、gradients、Parametes,内存减少与数据并行度呈线性关系。例如,在64个GPU(Nd=64)之间进行拆分将产生64倍的内存缩减。通信量有50%的适度增长 |
| Zero-Infinity | Zero-Infinity是Zero-3的扩展,它允许通过使用 NVMe 固态硬盘扩展 GPU 和 CPU 内存来训练大型模型 |
2.4 Zero-Offload:
相比GPU,CPU就相对比较廉价,所以Zero-Offload思想是将训练阶段的某些模型状态放(offload)到内存以及CPU计算。

Zero-Offload不希望为了最小化显存占用而让系统计算效率下降,但如果使用CPU也需要考虑通信和计算的问题(通信:GPU和CPU的通信;计算:CPU占用过多计算就会导致效率降低)。
Zero-Offload想做的是把计算节点和数据节点分布在GPU和CPU上,计算节点落到哪个设备上,哪个设备就执行计算,数据节点落到哪个设备上,哪个设备就负责存储。
Zero-Offload切分思路:
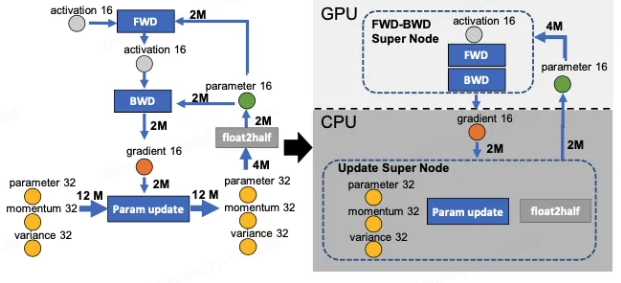
下图中有四个计算类节点:FWD、BWD、Param update和float2half,前两个计算复杂度大致是 O(MB), B是batch size,后两个计算复杂度是 O(M)。为了不降低计算效率,将前两个节点放在GPU,后两个节点不但计算量小还需要和Adam状态打交道,所以放在CPU上,Adam状态自然也放在内存中,为了简化数据图,将前两个节点融合成一个节点FWD-BWD Super Node,将后两个节点融合成一个节点Update Super Node。如下图右边所示,沿着gradient 16和parameter 16两条边切分。
Zero-Offload计算思路:
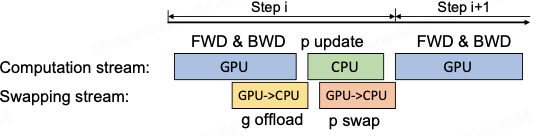
在GPU上面进行前向和后向计算,将梯度传给CPU,进行参数更新,再将更新后的参数传给GPU。为了提高效率,可以将计算和通信并行起来,GPU在反向传播阶段,可以待梯度值填满bucket后,一遍计算新的梯度一遍将bucket传输给CPU,当反向传播结束,CPU基本上已经有最新的梯度值了,同样的,CPU在参数更新时也同步将已经计算好的参数传给GPU,如下图所示。
2.5 混合精度:
混合精度训练是指在训练过程中同时使用FP16(半精度浮点数)和FP32(单精度浮点数)两种精度的技术。使用FP16可以大大减少内存占用,从而可以训练更大规模的模型。但是,由于FP16的精度较低,训练过程中可能会出现梯度消失和模型坍塌等问题。
DeepSpeed支持混合精度的训练,可以在config.json配置文件中设置来启动混合精度("fp16.enabled":true)。在训练的过程中,DeepSpeed会自动将一部分操作转化为FP16格式,并根据需要动态调整精度缩放因子,来保证训练的稳定性和精度。
在使用混合精度训练时,需要注意一些问题,例如梯度裁剪(Gradient Clipping)和学习率调整(Learning Rate Schedule)等。梯度裁剪可以防止梯度爆炸,学习率调整可以帮助模型更好地收敛。
三、总结
DeepSpeed方便了我们在机器有限的情况下来训练、微调大模型,同时它也有很多优秀的性能来使用,后期可以继续挖掘。
目前主流的达模型训练方式: GPU + PyTorch + Megatron-LM + DeepSpeed
优势
- 存储效率:DeepSpeed提供了一种Zero的新型解决方案来减少训练显存的占用,它与传统的数据并行不同,它将模型状态和梯度进行分区来节省大量的显存;
- 可扩展性:DeepSpeed支持高效的数据并行、模型并行、pipeline并行以及它们的组合,这里也称3D并行;
- 易用性: 在训练阶段,只需要修改几行代码就可以使pytorch模型使用DeepSpeed和Zero。
参考:
1. http://wed.xjx100.cn/news/204072.html?action=onClick
2. https://zhuanlan.zhihu.com/p/513571706
作者:京东物流 郑少强
来源:京东云开发者社区 转载请注明来源
DeepSpeed: 大模型训练框架的更多相关文章
- 千亿参数开源大模型 BLOOM 背后的技术
假设你现在有了数据,也搞到了预算,一切就绪,准备开始训练一个大模型,一显身手了,"一朝看尽长安花"似乎近在眼前 -- 且慢!训练可不仅仅像这两个字的发音那么简单,看看 BLOOM ...
- [源码解析] 深度学习分布式训练框架 horovod (8) --- on spark
[源码解析] 深度学习分布式训练框架 horovod (8) --- on spark 目录 [源码解析] 深度学习分布式训练框架 horovod (8) --- on spark 0x00 摘要 0 ...
- 华为高级研究员谢凌曦:下一代AI将走向何方?盘古大模型探路之旅
摘要:为了更深入理解千亿参数的盘古大模型,华为云社区采访到了华为云EI盘古团队高级研究员谢凌曦.谢博士以非常通俗的方式为我们娓娓道来了盘古大模型研发的"前世今生",以及它背后的艰难 ...
- DeepSpeed Chat: 一键式RLHF训练,让你的类ChatGPT千亿大模型提速省钱15倍
DeepSpeed Chat: 一键式RLHF训练,让你的类ChatGPT千亿大模型提速省钱15倍 1. 概述 近日来,ChatGPT及类似模型引发了人工智能(AI)领域的一场风潮. 这场风潮对数字世 ...
- 图神经网络之预训练大模型结合:ERNIESage在链接预测任务应用
1.ERNIESage运行实例介绍(1.8x版本) 本项目原链接:https://aistudio.baidu.com/aistudio/projectdetail/5097085?contribut ...
- 【机器学习PAI实践十】深度学习Caffe框架实现图像分类的模型训练
背景 我们在之前的文章中介绍过如何通过PAI内置的TensorFlow框架实验基于Cifar10的图像分类,文章链接:https://yq.aliyun.com/articles/72841.使用Te ...
- 小白学习之pytorch框架(3)-模型训练三要素+torch.nn.Linear()
模型训练的三要素:数据处理.损失函数.优化算法 数据处理(模块torch.utils.data) 从线性回归的的简洁实现-初始化模型参数(模块torch.nn.init)开始 from torc ...
- 谷歌大规模机器学习:模型训练、特征工程和算法选择 (32PPT下载)
本文转自:http://mp.weixin.qq.com/s/Xe3g2OSkE3BpIC2wdt5J-A 谷歌大规模机器学习:模型训练.特征工程和算法选择 (32PPT下载) 2017-01-26 ...
- Windows下mnist数据集caffemodel分类模型训练及测试
1. MNIST数据集介绍 MNIST是一个手写数字数据库,样本收集的是美国中学生手写样本,比较符合实际情况,大体上样本是这样的: MNIST数据库有以下特性: 包含了60000个训练样本集和1000 ...
- Keras入门(六)模型训练实时可视化
在北京做某个项目的时候,客户要求能够对数据进行训练.预测,同时能导出模型,还有在页面上显示训练的进度.前面的几个要求都不难实现,但在页面上显示训练进度当时笔者并没有实现. 本文将会分享如何在K ...
随机推荐
- 一键搞定发布自己Jar到Maven中央仓库
做java 开发那当然离不开jar包管理, 不知何时一直想想封装一个自己的jar包 然后发布到maven中央仓库给别人使用. hhh 我感觉自己写一个jar包工具然后,被很多人使用是一件很牛,很快乐事 ...
- 即构发布 LCEP 产品「RoomKit」 ,实现房间内0代码接入
2021年2月5日,即构科技正式发布全新形态「低代码互动平台」(Low-code Engagement Platform,简称LCEP)产品「RoomKit」. RoomKit定位为低代码互动平台(L ...
- 公网环境部署zabbix5.0
实验环境 虚拟机两台,一台公网地址为 1.1.1.1,部署 zabbix server,一台公网地址为 1.1.1.2,部署 zabbix proxy,系统为centos7.2. 1 zabbix s ...
- zabbix web 打开 lastest data 显示空白,http 返回 500
问题 当在zabbix web 的 lastest data 界面上进行一个超大查询(没有限定主机)时,可能因为查询过大,超出了php-fpm进程的内存限制,而导致该界面卡住.(此后打开均无显示,F1 ...
- 【overcome error】dereferencing pointer to incomplete type
@ 目录 前言 解决 代码情况 分析问题 尾声 前言 这个问题是我在学习数据结构链栈部分遇到的,英文报错如题所示,中文意思是:取消引用不完整类型的指针,在百度一圈也没明白,(百度搜索,看一个和全看基本 ...
- 牛客小白月赛65 D题 题解
原题链接 题意描述 一共有两堆石子,第一堆有 \(a\) 个,第二堆有 \(b\) 个,牛牛和牛妹轮流取石子,牛牛先手,每次取石子的时候只能从以下 \(2\) 种方案种挑一种来取(对于选择的方案数必须 ...
- 使用MkDocs搭建个人博客
使用MkDocs搭建个人博客 接触编程已经好几年了,阅读了无数大佬的博客文章,但是从来没有自己写过.这其中最重要的原因当然是懒惰,觉得写博客太费时间了,对自己的帮助也不大.可是如今发现自己的记性越来越 ...
- Cilium系列-15-7层网络CiliumNetworkPolicy简介
系列文章 Cilium 系列文章 前言 今天我们进入 Cilium 安全相关主题, 介绍 CiliumNetworkPolicies 相比于 Kubernetes 网络策略最大的不同: 7 层网络策略 ...
- Android13冻结进程分析:如何提高设备性能和用户体验
Android13冻结进程分析:如何提高设备性能和用户体验 本文介绍了Android13中的冻结进程功能,它是一种重要的资源管理策略,可以提高系统性能和稳定性,同时最大限度地节省设备的资源和电池消耗. ...
- 基于 SharpPcap 开发的简易嗅探器
Sniffer Based on SharpPcap A packet capture coursework based on sharpcap development 一个基于 SharpPcap ...