
TensorFlow 深度学习笔记 从线性分类器到深度神经网络
转载请注明作者:梦里风林
Github工程地址:https://github.com/ahangchen/GDLnotes
欢迎star,有问题可以到Issue区讨论
官方教程地址
视频/字幕下载
Limit of Linear Model
- 实际要调整的参数很多
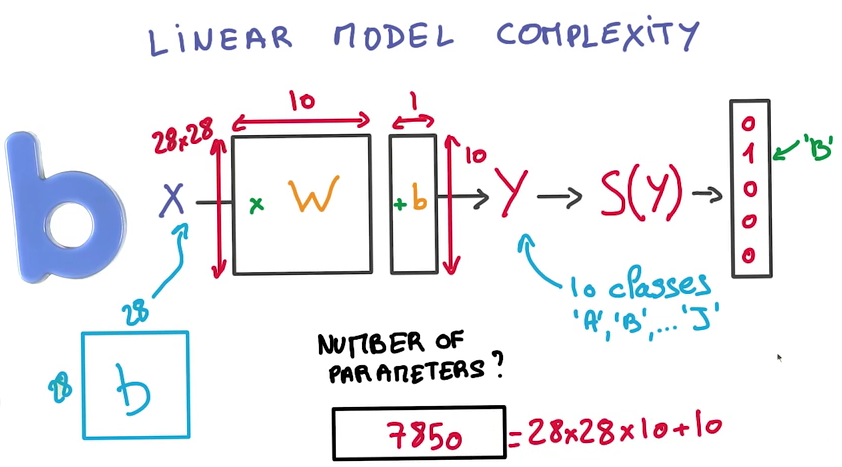
如果有N个Class,K个Label,需要调整的参数就有(N+1)K个
Linear Model不能应对非线性的问题
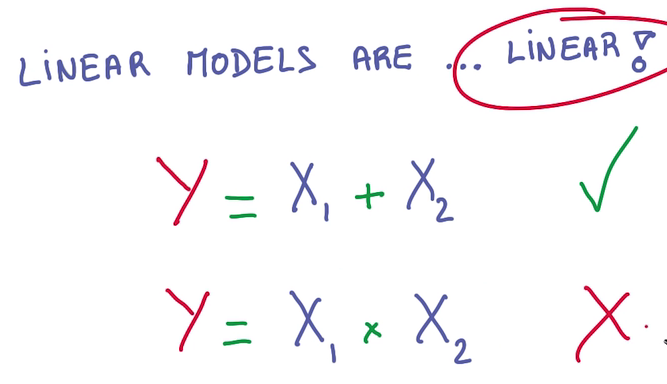
- Linear Model的好处
- GPU就是设计用于大矩阵相乘的,因此它们用来计算Linear Model非常efficient
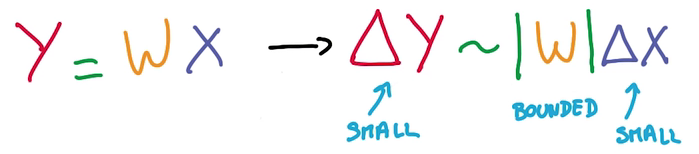
Stable:input的微小改变不会很大地影响output
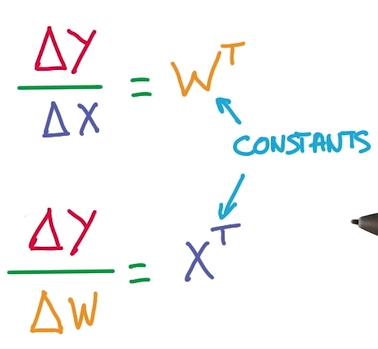
- 求导方便:线性求导是常数
- 我们希望参数函数是线性的,但整个model是非线性的
- 所以需要对各个线性模型做非线性组合
- 最简单的非线性组合:分段线性函数(RELU)

Neural network
- 用一个RELU作为中介,一个Linear Model的输出作为其输入,其输出作为另一个Linear Model的输入,使其能够解决非线性问题

- 神经网络并不一定要完全像神经元那样工作
- Chain Rule:复合函数求导规律

- Lots of data reuse and easy to implement(a simple data pipeline)
- Back propagation
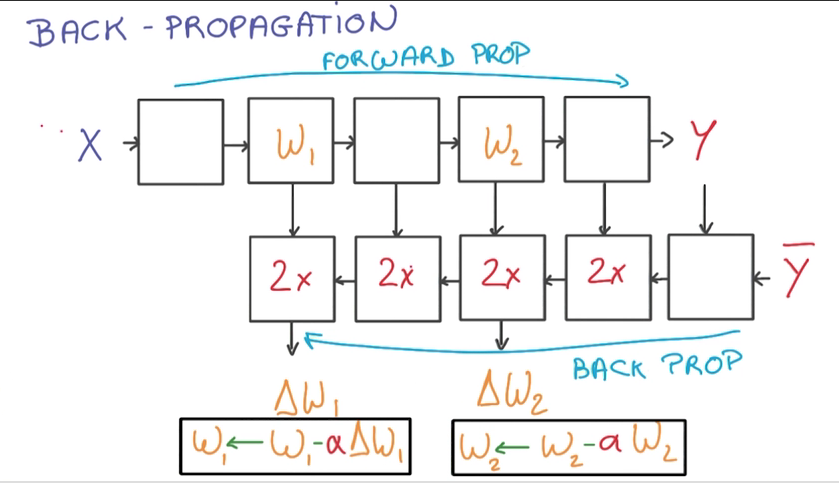
- 计算train_loss时,数据正向流入,计算梯度时,逆向计算
- 计算梯度需要的内存和计算时间是计算train_loss的两倍
Deep Neural Network
Current two layer neural network:
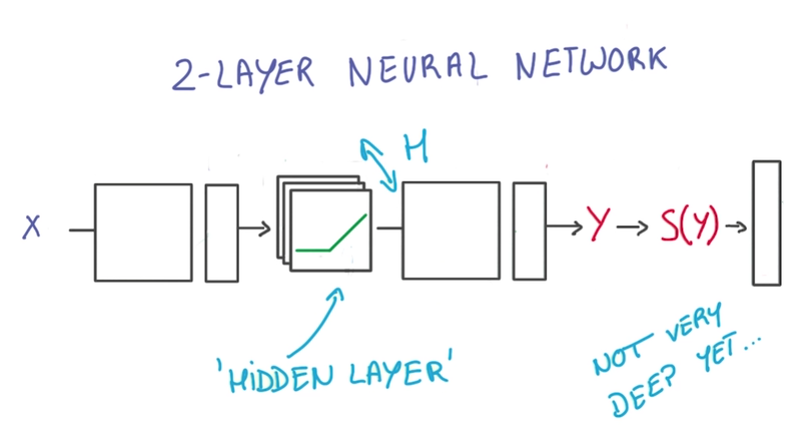
优化:
- 优化RELU(隐藏层), wider
增加linear层,layer deeper
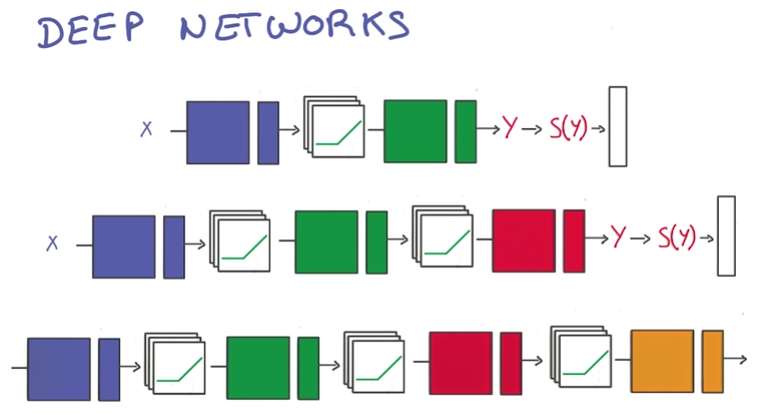
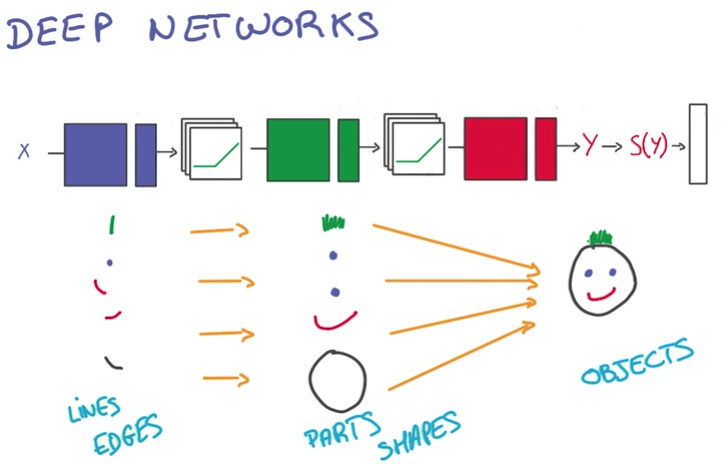
- Performance: few parameters by deeper
随层级变高,获得的信息越综合,越符合目标
About t-model
- t-model只有在有大量数据时有效
- 今天我们才有高效的大数据训练方法:Better Regularization
- 难以决定适应问题的神经网络的规模,因此通常选择更大的规模,并防止过拟合
Avoid Overfit
Early Termination
- 当训练结果与验证集符合度下降时,就停止训练

Regulation
- 给神经网络里加一些常量,做一些限制,减少自由的参数
- L2 regularization
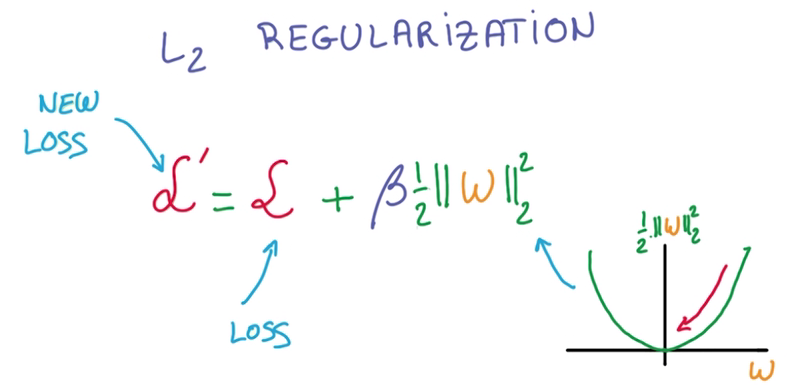
在计算train loss时,增加一个l2 norm作为新的损失,这里需要乘一个β(Hyper parameter),调整这个新的项的值
Hyper parameter:拍脑袋参数→_→
l2模的导数容易计算,即W本身
DropOut
最近才出现,效果极其好
- 从一个layer到另一个layer的value被称为activation
- 将一个layer到另一个layer的value的中,随机地取一半的数据变为0,这其实是将一半的数据直接丢掉
- 由于数据缺失,所以就强迫了神经网络学习redundant的知识,以作为损失部分的补充
- 由于神经网络中总有其他部分作为损失部分的补充,所以最后的结果还是OK的
- More robust and prevent overfit
如果这种方法不能生效,那可能就要使用更大的神经网络了
- 评估神经网络时,就不需要DropOut,因为需要确切的结果
- 可以将所有Activation做平均,作为评估的依据
因为我们在训练时去掉了一半的随机数据,如果要让得到Activation正确量级的平均值,就需要将没去掉的数据翻倍

觉得得我的文章对您有帮助的话,就给个star吧~
TensorFlow 深度学习笔记 从线性分类器到深度神经网络的更多相关文章
- TensorFlow深度学习笔记 文本与序列的深度模型
Deep Models for Text and Sequence 转载请注明作者:梦里风林 Github工程地址:https://github.com/ahangchen/GDLnotes 欢迎st ...
- 深度学习笔记:优化方法总结(BGD,SGD,Momentum,AdaGrad,RMSProp,Adam)
深度学习笔记:优化方法总结(BGD,SGD,Momentum,AdaGrad,RMSProp,Adam) 深度学习笔记(一):logistic分类 深度学习笔记(二):简单神经网络,后向传播算法及实现 ...
- Google TensorFlow深度学习笔记
Google Deep Learning Notes Google 深度学习笔记 由于谷歌机器学习教程更新太慢,所以一边学习Deep Learning教程,经常总结是个好习惯,笔记目录奉上. Gith ...
- UFLDL深度学习笔记 (五)自编码线性解码器
UFLDL深度学习笔记 (五)自编码线性解码器 1. 基本问题 在第一篇 UFLDL深度学习笔记 (一)基本知识与稀疏自编码中讨论了激活函数为\(sigmoid\)函数的系数自编码网络,本文要讨论&q ...
- UFLDL深度学习笔记 (七)拓扑稀疏编码与矩阵化
UFLDL深度学习笔记 (七)拓扑稀疏编码与矩阵化 主要思路 前面几篇所讲的都是围绕神经网络展开的,一个标志就是激活函数非线性:在前人的研究中,也存在线性激活函数的稀疏编码,该方法试图直接学习数据的特 ...
- UFLDL深度学习笔记 (六)卷积神经网络
UFLDL深度学习笔记 (六)卷积神经网络 1. 主要思路 "UFLDL 卷积神经网络"主要讲解了对大尺寸图像应用前面所讨论神经网络学习的方法,其中的变化有两条,第一,对大尺寸图像 ...
- UFLDL深度学习笔记 (三)无监督特征学习
UFLDL深度学习笔记 (三)无监督特征学习 1. 主题思路 "UFLDL 无监督特征学习"本节全称为自我学习与无监督特征学习,和前一节softmax回归很类似,所以本篇笔记会比较 ...
- Deep Learning.ai学习笔记_第一门课_神经网络和深度学习
目录 前言 第一周(深度学习引言) 第二周(神经网络的编程基础) 第三周(浅层神经网络) 第四周(深层神经网络) 前言 目标: 掌握神经网络的基本概念, 学习如何建立神经网络(包含一个深度神经网络), ...
- UFLDL深度学习笔记 (二)SoftMax 回归(矩阵化推导)
UFLDL深度学习笔记 (二)Softmax 回归 本文为学习"UFLDL Softmax回归"的笔记与代码实现,文中略过了对代价函数求偏导的过程,本篇笔记主要补充求偏导步骤的详细 ...
随机推荐
- 如何使用Assetic进行文件管理
安装和配置Assetic 从symfony2.8开始,Assetic就不再被包括在symfony标准版.使用任何Assetic的特性之前需要安装AsseticBundel,在命令行执行下面命令: $ ...
- 处理PHP中字符串的常用操作及函数
1. 确定一个字符串的长度 这是最为常见和基础的例子,对于确定一个字符串的长度,我们应该使用strlen()函数,比如要获取下面字符串$text 的长度: $text = "sunny da ...
- project euler 19: Counting Sundays
import datetime count = 0 for y in range(1901,2001): for m in range(1,13): if datetime.datetime(y,m, ...
- scp和pscp
在linux中,我们常用scp命令传输文件: 如以下实例,我们想把当前服务器文件abc.sql传输到192.168.1.1服务器上,我们可以执行以下命令: scp /home/person/hww/a ...
- WPF中获取控件之间的相对位置
1,获取元素相对于父控件的位置 使用Vector VisualTreeHelper.GetOffset(Visual visual)方法,其会返回visual在其父控件中的偏移量,然后你再将返回值的V ...
- css案例学习之按钮超链接
效果 css实现 <html> <head> <title>按钮超链接</title> <style> a{ /* 统一设置所有样式 */ ...
- cf471B MUH and Important Things
B. MUH and Important Things time limit per test 1 second memory limit per test 256 megabytes input s ...
- 云脉提供表单识别API接口自助接入
如今随着信息化.数字化时代的到来,利用纯人工进行数据录入已经不能满足海量信息数字化的需求.这时候有OCR表单识别技术,一切问题都能够迎刃而解了.云脉表单识别SDK采用成熟的OCR技术,通过创建票据的模 ...
- 很少人知道的office专用卸载工具
Microsoft Office是微软公司开发的一套基于 Windows 操作系统的办公软件套装.常用组件有 Word.Excel.Powerpoint等.当我们不需要再用了或者想安装旧版本的话,首先 ...
- Unity 使用实体类
故事的由来: 正在开发打飞机的游戏,遇到这样的数据结构,游戏有很多关卡-> 每个关卡有几波怪物->每一波里面有怪物和数量 [] 关卡 { []波{ {怪物,数量},{怪物,数量},{怪物, ...