
原来你是这样的BERT,i了i了! —— 超详细BERT介绍(一)BERT主模型的结构及其组件
原来你是这样的BERT,i了i了! —— 超详细BERT介绍(一)BERT主模型的结构及其组件
BERT(Bidirectional Encoder Representations from Transformers)是谷歌在2018年10月推出的深度语言表示模型。
一经推出便席卷整个NLP领域,带来了革命性的进步。
从此,无数英雄好汉竞相投身于这场追剧(芝麻街)运动。
只听得这边G家110亿,那边M家又1750亿,真是好不热闹!
然而大家真的了解BERT的具体构造,以及使用细节吗?
本文就带大家来细品一下。
前言
本系列文章分成三篇介绍BERT,本文主要介绍BERT主模型(BertModel)的结构及其组件相关知识,另有两篇分别介绍BERT预训练相关和如何将BERT应用到不同的下游任务。
文章中的一些缩写:NLP(natural language processing)自然语言处理;CV(computer vision)计算机视觉;DL(deep learning)深度学习;NLP&DL 自然语言处理和深度学习的交叉领域;CV&DL 计算机视觉和深度学习的交叉领域。
文章公式中的向量均为行向量,矩阵或张量的形状均按照PyTorch的方式描述。
向量、矩阵或张量后的括号表示其形状。
本系列文章的代码均是基于transformers库(v2.11.0)的代码(基于Python语言、PyTorch框架)。
为便于理解,简化了原代码中不必要的部分,并保持主要功能等价。
在代码最开始的地方,需要导入以下包:
代码
from math import inf, sqrt

import torch as tc

from torch import nn

from torch.nn import functional as F

from transformers import PreTrainedModel
阅读本系列文章需要一些背景知识,包括Word2Vec、LSTM、Transformer-Base、ELMo、GPT等,由于本文不想过于冗长(其实是懒),以及相信来看本文的读者们也都是冲着BERT来的,所以这部分内容还请读者们自行学习。
本文假设读者们均已有相关背景知识。
目录
1、主模型
BERT的主模型是BERT中最重要组件,BERT通过预训练(pre-training),具体来说,就是在主模型后再接个专门的模块计算预训练的损失(loss),预训练后就得到了主模型的参数(parameter),当应用到下游任务时,就在主模型后接个跟下游任务配套的模块,然后主模型赋上预训练的参数,下游任务模块随机初始化,然后微调(fine-tuning)就可以了(注意:微调的时候,主模型和下游任务模块两部分的参数一般都要调整,也可以冻结一部分,调整另一部分)。
主模型由三部分构成:嵌入层、编码器、池化层。
如图:
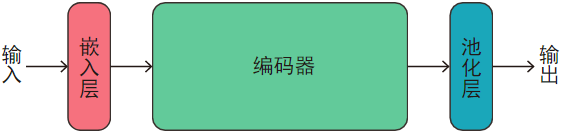
其中
- 输入:一个个小批(mini-batch),小批里是
batch_size个序列(句子或句子对),每个序列由若干个离散编码向量组成。 - 嵌入层:将输入的序列转换成连续分布式表示(distributed representation),即词嵌入(word embedding)或词向量(word vector)。
- 编码器:对每个序列进行非线性表示。
- 池化层:取出
[CLS]标记(token)的表示(representation)作为整个序列的表示。 - 输出:编码器最后一层输出的表示(序列中每个标记的表示)和池化层输出的表示(序列整体的表示)。
下面具体介绍这些部分。
1.1、输入
一般来说,输入BERT的可以是一句话:
I'm repairing immortals.
也可以是两句话:
I'm repairing immortals. ||| Me too.
其中|||是分隔两个句子的分隔符。
BERT先用专门的标记器(tokenizer)来标记(tokenize)序列,双句标记后如下(单句类似):
I ' m repair ##ing immortal ##s . ||| Me too .
标记器其实就是先对句子进行基于规则的标记化(tokenization),这一步可以把'm以及句号.等分割开,再进行子词分割(subword segmentation),示例中带##的就是被子词分割开的部分。
子词分割有很多好处,比如压缩词汇表、表示未登录词(out of vocabulary words, OOV words)、表示单词内部结构信息等,以后有时间专门写一篇介绍这个。
数据集中的句子长度不一定相等,BERT采用固定输入序列(长则截断,短则填充)的方式来解决这个问题。
首先需要设定一个seq_length超参数(hyperparameter),然后判断整个序列长度是否超出,如果超出:单句截掉最后超出的部分,双句则先删掉较长的那句话的末尾标记,如果两句话长度相等,则轮流删掉两句话末尾的标记,直到总长度达到要求(即等长的两句话删掉的标记数量尽量相等);如果序列长度过小,则在句子最后添加[PAD]标记,使长度达到要求。
然后在序列最开始添加[CLS]标记,以及在每句话末尾添加[SEP]标记。
单句话添加一个[CLS]和一个[SEP],双句话添加一个[CLS]和两个[SEP]。
[CLS]标记对应的表示作为整个序列的表示,[SEP]标记是专门用来分隔句子的。
注意:处理长度时需要考虑添加的[CLS]和[SEP]标记,使得最终总的长度=seq_length;[PAD]标记在整个序列的最末尾。
例如seq_length=12,则单句变为:
[CLS] I ' m repair ##ing immortal ##s . [SEP] [PAD] [PAD]
如果seq_length=10,则双句变为:
[CLS] I ' m repair [SEP] Me too . [SEP]
分割完后,每一个空格分割的子字符串(substring)都看成一个标记(token),标记器通过查表将这些标记映射成整数编码。
单句如下:
[101, 146, 112, 182, 6949, 1158, 15642, 1116, 119, 102, 0, 0]
最后整个序列由四种类型的编码向量表示,单句如下:
标记编码:[101, 146, 112, 182, 6949, 1158, 15642, 1116, 119, 102, 0, 0]

位置编码:[0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]

句子位置编码:[0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]

注意力掩码:[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 0]
其中,标记编码就是上面的序列中每个标记转成编码后得到的向量;位置编码记录每个标记的位置;句子位置编码记录每个标记属于哪句话,0是第一句话,1是第二句话(注意:[CLS]标记对应的是0);注意力掩码记录某个标记是否是填充的,1表示非填充,0表示填充。
双句如下:
标记编码:[101, 146, 112, 182, 6949, 102, 2508, 1315, 119, 102]

位置编码:[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

句子位置编码:[0, 0, 0, 0, 0, 0, 1, 1, 1, 1]

注意力掩码:[1, 1, 1, 1, 1, 1, 1, 1, 1, 1]
上面的是英文的情况,中文的话BERT直接用汉字级别表示,即
我在修仙( ̄︶ ̄)
这样的句子分割成
我 在 修 仙 (  ̄ ︶  ̄ )
然后每个汉字(包括中文标点)看成一个标记,应用上述操作即可。
1.2、嵌入层
嵌入层的作用是将序列的离散编码表示转换成连续分布式表示。
离散编码只能表示A和B相等或不等,但是如果将其表示成连续分布式表示(即连续的N维空间向量),就可以计算\(A\)与\(B\)之间的相似度或距离了,从而表达更多信息。
这个是词嵌入或词向量的知识,可以参考Word2Vec相关内容,本文不再赘述了。
嵌入层包含三种组件:嵌入变换(embedding)、层标准化(layer normalization)、随机失活(dropout)。
如图:
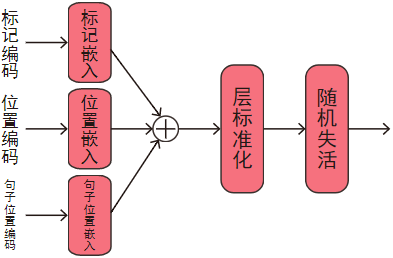
1.2.1、嵌入变换
嵌入变换实际上就是一个线性变换(linear transformation)。
传统上,离散标记往往表示成一个独热码(one-hot)向量,也叫标准基向量,即一个长度为\(V\)的向量,其中只有一位为\(1\),其他都为\(0\)。
在NLP&DL领域,\(V\)一般是词汇表的大小。
但是这种向量往往维数很高(词汇表往往比较大)而且很稀疏(每个向量只有一位不为\(0\)),不好处理。
所以可以通过一个线性变换将这个向量转换成低维稠密的向量。
假设\(v\)(\(V\))是标记\(t\)的独热码向量,\(W\)(\(V \times H\))是一个\(V\)行\(H\)列的矩阵,则\(t\)的嵌入\(e\)为:
\]
实际上\(W\)中每一行都可以看成一个词嵌入,而这个矩阵乘就是把\(v\)中等于\(1\)的那个位置对应的\(W\)中的词嵌入取出来。
在工程实践中,由于独热码向量比较占内存,而且矩阵乘效率也不高,所以往往用一个整数编码来代替独热码向量,然后直接用查表的方式取出对应的词嵌入。
所以假设\(n\)是\(t\)的编码,一般是在词汇表中的编号,那么上面的公式就可以改成:
\]
其中下标表示取出对应的行。
那么一个标记化后的序列就可以表示成一个编码向量。
假设序列\(T\)的编码向量为\(s\)(\(L\)),\(L\)为序列的长度,即\(T\)中有\(L\)个标记。
如果词嵌入长度为\(H\),那么经过嵌入变换,得到\(T\)的隐状态(hidden state)\(h\)(\(L \times H\))。
1.2.2、层标准化
层标准化类似于批标准化(batch normalization),可以加速模型训练,但其实现方式和批标准化不一样,层标准化是沿着词嵌入(通道)维进行标准化的,不需要在训练时存储统计量来估计整体数据集的均值和方差,训练(training)和评估(evaluation)或推理(inference)阶段的操作是相同的。
另外批标准化对小批大小有限制,而层标准化则没有限制。
假设输入的一个词嵌入为\(e = [x_0, x_1, ..., x_{H-1}]\),\(x_k\)是\(e\)第\(k = 0, 1, ..., (H-1)\) 维的分量,\(H\)是词嵌入长度。
那么层标准化就是
\]
其中,\(y_{k}\)是输出,\(\mu\)和\(\sigma^2\)分别是均值和方差:
\sigma^2 = \frac{1}{H} \sum_{k=0}^{H-1} (x_{k}-\mu)^2 \\
\]
\(\alpha_k\)和\(\beta_k\)是学习得到的参数,用于防止模型表示能力退化。
注意:\(\mu\)和\(\sigma^2\)是针对每个样本每个位置的词嵌入分别计算的,而\(\alpha_k\)和\(\beta_k\)对所有的词嵌入都是共用的;\(\sigma^2\)的计算没有使用贝塞尔校正(Bessel's correction)。
1.2.3、随机失活
随机失活是DL领域非常著名且常用的正则化(regularization)方法(然而被谷歌注册专利了),用来防止模型过拟合(overfitting)。
具体来说,先设置一个超参数\(P \in [0, 1]\),表示按照概率\(P\)随机将值置\(0\)。
然后假设词嵌入中某一维分量是\(x\),按照均匀随机分布产生一个随机数\(r \in [0, 1]\),然后输出值\(y\)为:
\begin{aligned}
& \frac{x}{1-P} &, & r > P \\
& 0 &, & r \le P \\
\end{aligned}
\right. \]
由于按照概率\(P\)置\(0\),相当于输出值的期望变成原来的\((1-P)\)倍,所以再对输出值除以\((1-P)\),就可以保持期望不变。
以上操作针对训练阶段,在评估阶段,输出值等于输入值:
\]
嵌入层代码如下:
代码
# BERT之嵌入层

class BertEmb(nn.Module):

	def __init__(self, config):

		super().__init__()

		# 标记嵌入,padding_idx=0:编码为0的嵌入始终为零向量

		self.tok_emb = nn.Embedding(config.vocab_size, config.hidden_size, padding_idx=0)

		# 位置嵌入

		self.pos_emb = nn.Embedding(config.max_position_embeddings, config.hidden_size)

		# 句子位置嵌入

		self.sent_pos_emb = nn.Embedding(config.type_vocab_size, config.hidden_size)

		# 层标准化

		self.layer_norm = nn.LayerNorm(config.hidden_size, eps=config.layer_norm_eps)

		# 随机失活

		self.dropout = nn.Dropout(config.hidden_dropout_prob)

	def forward(self,

			tok_ids,  # 标记编码(batch_size * seq_length)

			pos_ids=None,  # 位置编码(batch_size * seq_length)

			sent_pos_ids=None,  # 句子位置编码(batch_size * seq_length)

	):

		device = tok_ids.device  # 设备(CPU或CUDA)

		shape = tok_ids.shape  # 形状(batch_size * seq_length)

		seq_length = shape[1]

		# 默认:[0, 1, ..., seq_length-1]

		if pos_ids is None:

			pos_ids = tc.arange(seq_length, dtype=tc.int64, device=device)

			pos_ids = pos_ids.unsqueeze(0).expand(shape)

		# 默认:[0, 0, ..., 0],即所有标记都属于第一个句子

		if sent_pos_ids is None:

			sent_pos_ids = tc.zeros(shape, dtype=tc.int64, device=device)

		# 三种嵌入(batch_size * seq_length * hidden_size)

		tok_embs = self.tok_emb(tok_ids)

		pos_embs = self.pos_emb(pos_ids)

		sent_pos_embs = self.sent_pos_emb(sent_pos_ids)

		# 三种嵌入相加

		embs = tok_embs + pos_embs + sent_pos_embs

		# 层标准化嵌入

		embs = self.layer_norm(embs)

		# 随机失活嵌入

		embs = self.dropout(embs)

		return embs  # 嵌入(batch_size * seq_length * hidden_size)
其中,
config是BERT的配置文件对象,里面记录了各种预先设定的超参数;
vocab_size是词汇表大小;
hidden_size是词嵌入长度,默认是768(bert-base-*)或1024(bert-large-*);
max_position_embeddings是允许的最大标记位置,默认是512;
type_vocab_size是允许的最大句子位置,即最多能输入的句子数量,默认是2;
layer_norm_eps是一个>0并很接近0的小数\(\epsilon\),用来防止计算时发生除0等异常操作;
hidden_dropout_prob是随机失活概率,默认是0.1;
batch_size是小批的大小,即一个小批里的样本个数;
seq_length是输入的编码向量的长度。
1.3、编码器
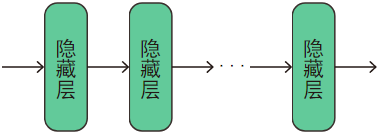
编码器的作用是对嵌入层输出的隐状态进行非线性表示,提取出其中的特征(feature),它是由num_hidden_layers个结构相同(超参数相同)但参数不同(不共享参数)的隐藏层串连构成的。
如图:
1.3.1、隐藏层
隐藏层包括线性变换、激活函数(activation function)、多头自注意力(multi-head self-attention)、跳跃连接(skip connection),以及上面介绍过的层标准化和随机失活。
如图:
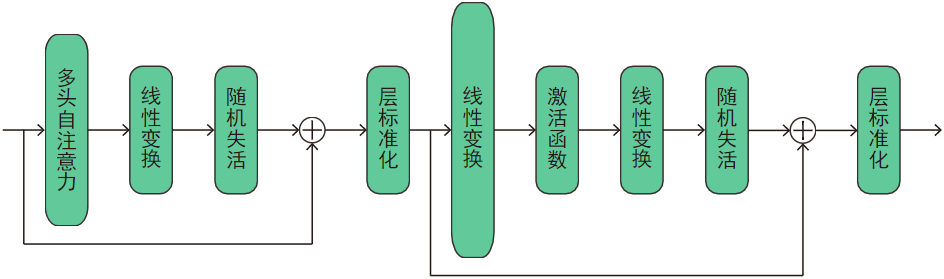
其中,激活函数默认是GELU,线性变换均是逐位置线性变换,即对不同样本不同位置的词嵌入应用相同的线性变换(类似于CV&DL领域的\(1 \times 1\)卷积)。
1.3.1.1、线性变换
线性变换在CV&DL领域也叫全连接层(fully connected layer),即
\]
其中,\(x\)(\(A\))是输入向量,\(y\)(\(B\))是输出向量,\(W\)(\(B \times A\))是权重(weight)矩阵,\(b\)(\(B\))是偏置(bias)向量;\(W\)和\(b\)是学习得到的参数。
另外,严格来说,当\(b = \vec 0\)时,上式为线性变换;当\(b \ne \vec 0\)时,上式为仿射变换(affine transformation)。
但是在DL中,人们往往并不那么抠字眼,对于这两种变换,一般都简单地称为线性变换。
1.3.1.2、激活函数
激活函数在DL中非常关键!
因为如果要提高一个神经网络(neural network)的表示能力,往往需要加深网络的深度。
然而如果只叠加多个线性变换的话,这等价于一个线性变换(大家可以推推看)!
所以只有在线性变换后接一个非线性变换(nonlinear transformation),即激活函数,才能逐渐加深网络并提高表示能力。
激活函数有很多,常见的包括sigmoid、tanh、softmax、ReLU、GELU、Swish、Mish等。
本文只讲和BERT相关的激活函数:tanh、softmax、GELU。
1.3.1.2.1、tanh
激活函数的一个功能是调整输入值的取值范围。
tanh即双曲正切函数,可以将\((-\infty, +\infty)\)的数映射到\((-1, 1)\),并且严格单调。
函数图像如图:

tanh在NLP&DL领域用得比较多。
1.3.1.2.2、softmax
softmax顾名思义,它可以对输入的一组数值根据其大小给出每个数值的概率,数值越大,概率越高,且概率求和为\(1\)。
假设输入\(x_k\),\(k = 0, 1, ..., (N-1)\),则输出值\(y_k\)为:
\]
实际上,对于任意一个对数几率(logit)\(x \in (-\infty, +\infty)\),\(x\)越大,表示某个事件发生的可能性越大,softmax可以将其转化为概率,即将取值范围映射到\((0, 1)\)。
1.3.1.2.3、GELU
GELU(Gaussian Error Linear Units)是2016年6月提出的一个激活函数。
GELU相比ReLU曲线更为光滑,允许梯度更好地传播。
GELU的想法类似于随机失活,随机失活是按照0-1分布,又叫两点分布,也叫伯努利分布(Bernoulli distribution),随机通过输入值;而GELU则是将这个概率分布改成正态分布(Normal distribution),也叫高斯分布(Gaussian distribution),然后输出期望。
假设输入值是\(x\),输出值是\(y\),那么GELU就是:
\]
其中,\(X \sim \mathcal{N}(0, 1)\),\(P\)为概率。
GELU的函数图像如图:
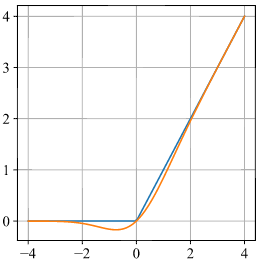
其中蓝线为ReLU函数图像,橙线为GELU函数图像。
1.3.1.3、多头自注意力
多头自注意力是Transformer的一大特色。
多头自注意力的名字可以分成三个词:多头、自、注意力:
- 注意力:是DL领域近年来最重要的创新之一!可以使模型以不同的方式对待不同的输入(即分配不同的权重),而无视空间(即输入向量排成线形、面形、树形、图形等拓扑结构)的形状、大小、距离。
- 自:是在普通的注意力基础上修改而来的,可以表示输入与自身的依赖关系。
- 多头:是对注意力中涉及的向量分别拆分计算,从而提高表示能力。
对于一般的多头注意力,假设计算\(x\)(\(H\))对\(y_i\)(\(H\)),\(i = 0, 1, ..., (L-1)\),的多头注意力,则首先计算\(q\)(H)、\(k_i\)(H)、\(v_i\)(H):
k_i = y_i W_k^T + b_k \\
v_i = y_i W_v^T + b_v \\
\]
其中,\(W_z\)(\(H \times H\))和\(b_z\)(\(H\))分别为权重矩阵和偏置向量,\(z \in \{ q, k, v \}\)。
然后将这三种向量等长度拆分成\(S\)个向量,称为头向量:
k_{ij} = [k_{i0}; k_{i1}; ...; k_{i, S-1}] \\
v_{ij} = [v_{i0}; v_{i1}; ...; v_{i, S-1}] \\
\]
上式中的分号为串连操作,即把多个向量拼接起来组成一个更长的向量。
其中,每个头向量长度都为\(D\),且\(S \times D = H\)。
然后计算\(q_j\)对\(k_{ij}\)的注意力分数\(s_{ij}\):
\]
之后可以添加注意力掩码(也可以不加),即令\(s_{mj} = -\infty\),\(m\)是需要添加掩码的位置。
然后通过softmax计算注意力概率\(p_{ij}\):
\]
之后对注意力概率进行随机失活:
\]
再之后计算输出向量\(r_j\)(\(D\)):
\]
最终的输出向量是把每一头的输出向量串连起来:
\]
其中\(r\)(\(H\))为最终的输出向量。
如果令\(x = y_n\),\(n \in \{ 0, 1, ..., L-1 \}\),即\(x\)是\(y_i\)中的某一个向量,那么多头注意力就变为多头自注意力。
代码如下:
代码
# BERT之多头自注意力

class BertMultiHeadSelfAtt(nn.Module):

	def __init__(self, config):

		super().__init__()

		# 注意力头数

		self.num_heads = config.num_attention_heads

		# 注意力头向量长度

		self.head_size = config.hidden_size // config.num_attention_heads

		self.query = nn.Linear(config.hidden_size, config.hidden_size)

		self.key = nn.Linear(config.hidden_size, config.hidden_size)

		self.value = nn.Linear(config.hidden_size, config.hidden_size)

		self.dropout = nn.Dropout(config.attention_probs_dropout_prob)

	# 输入(batch_size * seq_length * hidden_size)

	# 输出(batch_size * num_heads * seq_length * head_size)

	def shape(self, x):

		shape = (*x.shape[:2], self.num_heads, self.head_size)

		return x.view(*shape).transpose(1, 2)

	# 输入(batch_size * num_heads * seq_length * head_size)

	# 输出(batch_size * seq_length * hidden_size)

	def unshape(self, x):

		x = x.transpose(1, 2).contiguous()

		return x.view(*x.shape[:2], -1)

	def forward(self,

			inputs,  # 输入(batch_size * seq_length * hidden_size)

			att_masks=None,  # 注意力掩码(batch_size * seq_length * hidden_size)

	):

		mixed_querys = self.query(inputs)

		mixed_keys = self.key(inputs)

		mixed_values = self.value(inputs)

		querys = self.shape(mixed_querys)

		keys = self.shape(mixed_keys)

		values = self.shape(mixed_values)

		# 注意力分数(batch_size * num_heads * seq_length * seq_length)

		att_scores = querys.matmul(keys.transpose(2, 3))

		# 缩放注意力分数

		att_scores = att_scores / sqrt(self.head_size)

		# 添加注意力掩码

		if att_masks is not None:

			att_scores = att_scores + att_masks

		# 注意力概率(batch_size * num_heads * seq_length * seq_length)

		att_probs = att_scores.softmax(dim=-1)

		# 随机失活注意力概率

		att_probs = self.dropout(att_probs)

		# 输出(batch_size * num_heads * seq_length * head_size)

		outputs = att_probs.matmul(values)

		outputs = self.unshape(outputs)

		return outputs  # 输出(batch_size * seq_length * hidden_size)
其中,
num_attention_heads是注意力头数,默认是12(bert-base-*)或16(bert-large-*);
attention_probs_dropout_prob是注意力概率的随机失活概率,默认是0.1。
1.3.1.4、跳跃连接
跳跃连接也是DL领域近年来最重要的创新之一!
跳跃连接也叫残差连接(residual connection)。
一般来说,传统的神经网络往往是一层接一层串连而成,前一层输出作为后一层输入。
而跳跃连接则是某一层的输出,跳过若干层,直接输入某个更深的层。
例如BERT的每个隐藏层中有两个跳跃连接。
跳跃连接的作用是防止神经网络梯度消失或梯度爆炸,使损失曲面(loss surface)更平滑,从而使模型更容易训练,使神经网络可以设置得更深。
按我个人的理解,一般来说,线性变换是最能保持输入信息的,而非线性变换则往往会损失一部分信息,但是为了网络的表示能力不得不线性变换与非线性变换多次堆叠,这样网络深层接收到的信息与最初输入的信息比可能已经面目全非,而跳跃连接则可以让输入信息原汁原味地传播得更深。
隐藏层代码如下:
代码
# BERT之隐藏层

class BertLayer(nn.Module):

	# noinspection PyUnresolvedReferences

	def __init__(self, config):

		super().__init__()

		# 多头自注意力

		self.multi_head_self_att = BertMultiHeadSelfAtt(config)

		self.linear = nn.Linear(config.hidden_size, config.hidden_size)

		self.dropout = nn.Dropout(config.hidden_dropout_prob)

		self.layer_norm = nn.LayerNorm(config.hidden_size, eps=config.layer_norm_eps)

		# 升维线性变换

		self.linear_1 = nn.Linear(config.hidden_size, config.intermediate_size)

		# 激活函数,默认:GELU

		self.act_fct = F.gelu

		# 降维线性变换,使向量大小保持不变

		self.linear_2 = nn.Linear(config.intermediate_size, config.hidden_size)

		self.dropout_1 = nn.Dropout(config.hidden_dropout_prob)

		self.layer_norm_1 = nn.LayerNorm(config.hidden_size, eps=config.layer_norm_eps)

	def forward(self,

			inputs,  # 输入(batch_size * seq_length * hidden_size)

			att_masks=None,  # 注意力掩码(batch_size * seq_length * hidden_size)

	):

		outputs = self.multi_head_self_att(inputs, att_masks=att_masks)

		outputs = self.linear(outputs)

		outputs = self.dropout(outputs)

		att_outputs = self.layer_norm(outputs + inputs)  # 跳跃连接

		outputs = self.linear_1(att_outputs)

		outputs = self.act_fct(outputs)

		outputs = self.linear_2(outputs)

		outputs = self.dropout_1(outputs)

		outputs = self.layer_norm_1(outputs + att_outputs)  # 跳跃连接

		return outputs  # 输出(batch_size * seq_length * hidden_size)
其中,
intermediate_size是中间一个升维线性变换升维后的长度,默认是3072(bert-base-*)或4096(bert-large-*)。
编码器代码如下:
代码
# BERT之编码器

class BertEnc(nn.Module):

	def __init__(self, config):

		super().__init__()

		# num_hidden_layers个隐藏层

		self.layers = nn.ModuleList([BertLayer(config)

			for _ in range(config.num_hidden_layers)])

	# noinspection PyTypeChecker

	def forward(self,

			inputs,  # 输入(batch_size * seq_length * hidden_size)

			att_masks=None,  # 注意力掩码(batch_size * seq_length)

	):

		# 调整注意力掩码的值和形状

		if att_masks is not None:

			device = inputs.device  # 设备(CPU或CUDA)

			dtype = inputs.dtype  # 数据类型(float16、float32或float64)

			shape = att_masks.shape  # 形状(batch_size * seq_length)

			t = tc.zeros(shape, dtype=dtype, device=device)

			t[att_masks<=0] = -inf  # exp(-inf) = 0

			t = t[:, None, None, :]

			att_masks = t

		outputs = inputs

		for layer in self.layers:

			outputs = layer(outputs, att_masks=att_masks)

		return outputs  # 输出(batch_size * seq_length * hidden_size)
其中,
num_hidden_layers是隐藏层数量,默认是12(bert-base-*)或24(bert-large-*)。
1.4、池化层
池化层是将[CLS]标记对应的表示取出来,并做一定的变换,作为整个序列的表示并返回,以及原封不动地返回所有的标记表示。
如图:
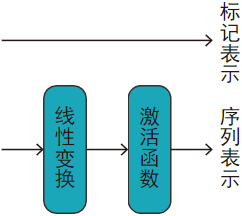
其中,激活函数默认是tanh。
池化层代码如下:
代码
# BERT之池化层

class BertPool(nn.Module):

	def __init__(self, config):

		super().__init__()

		self.linear = nn.Linear(config.hidden_size, config.hidden_size)

		self.act_fct = F.tanh

	def forward(self,

			inputs,  # 输入(batch_size * seq_length * hidden_size)

	):

		# 取[CLS]标记的表示

		outputs = inputs[:, 0]

		outputs = self.linear(outputs)

		outputs = self.act_fct(outputs)

		return outputs  # 输出(batch_size * hidden_size)
1.5、输出
主模型最后输出所有的标记表示和整体的序列表示,分别用于针对每个标记的预测任务和针对整个序列的预测任务。
主模型代码如下:
代码
# BERT之预训练模型抽象基类

class BertPreTrainedModel(PreTrainedModel):

	from transformers import BertConfig

	from transformers import BERT_PRETRAINED_MODEL_ARCHIVE_MAP

	from transformers import load_tf_weights_in_bert

	config_class = BertConfig

	pretrained_model_archive_map = BERT_PRETRAINED_MODEL_ARCHIVE_MAP

	load_tf_weights = load_tf_weights_in_bert

	base_model_prefix = 'bert'

	# 注意力头剪枝

	def _prune_heads(self, heads_to_prune):

		pass

	# 参数初始化

	def _init_weights(self, module):

		config = self.config

		f = lambda x: x is not None and x.requires_grad

		if isinstance(module, nn.Embedding):

			if f(module.weight):

				# 正态分布随机初始化

				module.weight.data.normal_(mean=0.0, std=config.initializer_range)

		elif isinstance(module, nn.Linear):

			if f(module.weight):

				# 正态分布随机初始化

				module.weight.data.normal_(mean=0.0, std=config.initializer_range)

			if f(module.bias):

				# 初始为0

				module.bias.data.zero_()

		elif isinstance(module, nn.LayerNorm):

			if f(module.weight):

				# 初始为1

				module.weight.data.fill_(1.0)

			if f(module.bias):

				# 初始为0

				module.bias.data.zero_()

# BERT之主模型

class BertModel(BertPreTrainedModel):

	def __init__(self, config):

		super().__init__(config)

		self.config = config

		# 嵌入层

		self.emb = BertEmb(config)

		# 编码器

		self.enc = BertEnc(config)

		# 池化层

		self.pool = BertPool(config)

		# 参数初始化

		self.init_weights()

	# noinspection PyUnresolvedReferences

	def get_input_embeddings(self):

		return self.emb.tok_emb

	def set_input_embeddings(self, embs):

		self.emb.tok_emb = embs

	def forward(self,

			tok_ids,  # 标记编码(batch_size * seq_length)

			pos_ids=None,  # 位置编码(batch_size * seq_length)

			sent_pos_ids=None,  # 句子位置编码(batch_size * seq_length)

			att_masks=None,  # 注意力掩码(batch_size * seq_length)

	):

		outputs = self.emb(tok_ids, pos_ids=pos_ids, sent_pos_ids=sent_pos_ids)

		outputs = self.enc(outputs, att_masks=att_masks)

		pooled_outputs = self.pool(outputs)

		return (

			outputs,  # 输出(batch_size * seq_length * hidden_size)

			pooled_outputs,  # 池化输出(batch_size * hidden_size)

		)
其中,
BertPreTrainedModel是预训练模型抽象基类,用于完成一些初始化工作。
后记
本文详细地介绍了BERT主模型的结构及其组件,了解它的构造以及代码实现对于理解以及应用BERT有非常大的帮助。
后续两篇文章会分别介绍BERT预训练和下游任务相关。
从BERT主模型的结构中,我们可以发现,BERT抛弃了RNN架构,而只用注意力机制来抽取长距离依赖(这个其实是Transformer架构的特点)。
由于注意力可以并行计算,而RNN必须串行计算,这就使得模型计算效率大大提升,于是BERT这类模型也能够堆得很深。
BERT为了能够同时做单句和双句的序列和标记的预测任务,设计了[CLS]和[SEP]等特殊标记分别作为序列表示以及标记不同的句子边界,整体采用了桶状的模型结构,即输入时隐状态的形状与输出时隐状态的形状相等(只是在每个隐藏层有升维与降维操作,整体上词嵌入长度保持不变)。
由于注意力机制对距离不敏感,所以BERT额外添加了位置特征。
原来你是这样的BERT,i了i了! —— 超详细BERT介绍(一)BERT主模型的结构及其组件的更多相关文章
- Bert文本分类实践(二):魔改Bert,融合TextCNN的新思路
写在前面 文本分类是nlp中一个非常重要的任务,也是非常适合入坑nlp的第一个完整项目.虽然文本分类看似简单,但里面的门道好多好多,博主水平有限,只能将平时用到的方法和trick在此做个记录和分享 ...
- nlp任务中的传统分词器和Bert系列伴生的新分词器tokenizers介绍
layout: blog title: Bert系列伴生的新分词器 date: 2020-04-29 09:31:52 tags: 5 categories: nlp mathjax: true ty ...
- 用NVIDIA-NGC对BERT进行训练和微调
用NVIDIA-NGC对BERT进行训练和微调 Training and Fine-tuning BERT Using NVIDIA NGC 想象一下一个比人类更能理解语言的人工智能程序.想象一下为定 ...
- 从Word Embedding到Bert模型—自然语言处理中的预训练技术发展史(转载)
转载 https://zhuanlan.zhihu.com/p/49271699 首发于深度学习前沿笔记 写文章 从Word Embedding到Bert模型—自然语言处理中的预训练技术发展史 张 ...
- 文本分类实战(十)—— BERT 预训练模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- 【译】为什么BERT有3个嵌入层,它们都是如何实现的
目录 引言 概览 Token Embeddings 作用 实现 Segment Embeddings 作用 实现 Position Embeddings 作用 实现 合成表示 结论 参考文献 本文翻译 ...
- 图解BERT(NLP中的迁移学习)
目录 一.例子:句子分类 二.模型架构 模型的输入 模型的输出 三.与卷积网络并行 四.嵌入表示的新时代 回顾一下词嵌入 ELMo: 语境的重要性 五.ULM-FiT:搞懂NLP中的迁移学习 六.Tr ...
- 深入理解BERT Transformer ,不仅仅是注意力机制
来源商业新知网,原标题:深入理解BERT Transformer ,不仅仅是注意力机制 BERT是google最近提出的一个自然语言处理模型,它在许多任务 检测上表现非常好. 如:问答.自然语言推断和 ...
- 采用Google预训bert实现中文NER任务
本博文介绍用Google pre-training的bert(Bidirectional Encoder Representational from Transformers)做中文NER(Name ...
随机推荐
- 阿里P9精心编写高并发设计手册,来看大厂是如何进行系统设计
在看这篇文章的应该都是IT圈的朋友吧,不知道你们有没有考虑过这样几件事: 淘宝双11的剁手狂欢为什么天猫没崩掉? 为什么滴滴打车高峰如何滴滴依旧可以平稳运行? 为什么疫情期间,钉钉能支撑那么多人同时上 ...
- [ES6系列-01]Class:面向对象的“新仇旧恨”
[原创]CoderPower 大家好,这里是码路工人有力量,我是码路工人,你们是力量. 这是公众号(码路工人有力量)开通后的第二篇,写得还是有待改进吧.这次准备写一个关于ES6基础的短文系列,努力尽快 ...
- Java的字节流,字符流和缓冲流对比探究
目录 一.前言 二.字节操作和字符操作 三.两种方式的效率测试 3.1 测试代码 3.2 测试结果 3.3 结果分析 四.字节顺序endian 五.综合对比 六.总结 一.前言 所谓IO,也就是Inp ...
- debug PHP程序(xdebug、IntelliJ IDEA)
之前写PHP程序的都是echo调试,今天感觉太麻烦了就想起研究一下IntelliJ IDEA如何调试PHP程序. 从网上查找了很多资料,大部分都提到在IDE里开启服务,一下就懵了,怎么启这么多服务呢. ...
- 50个SQL语句(MySQL版) 问题十二
--------------------------表结构-------------------------- student(StuId,StuName,StuAge,StuSex) 学生表 tea ...
- Spring-boot01
本文记录Spring-Boot学习途中的点点滴滴. 其实Spring-Boot出来好长时间了,但是一直没去关注过.之前在我的印象里Spring-Boot好就好在减去了很多XML配置,加入了很多自动配置 ...
- Java实现 LeetCode 587 安装栅栏(图算法转换成数学问题)
587. 安装栅栏 在一个二维的花园中,有一些用 (x, y) 坐标表示的树.由于安装费用十分昂贵,你的任务是先用最短的绳子围起所有的树.只有当所有的树都被绳子包围时,花园才能围好栅栏.你需要找到正好 ...
- Java实现欧拉筛与花里胡哨求质数高级大法的对比
我也不清楚这是什么高级算法,欧拉筛是昨天有位大佬,半夜无意间告诉我的 欧拉筛: 主要的含义就是我把这个数的所有倍数都弄出来,然后下次循环的时候直接就可以跳过了 import java.text.Sim ...
- Java实现 蓝桥杯VIP 算法提高 打水问题
算法提高 打水问题 时间限制:1.0s 内存限制:512.0MB 问题描述 N个人要打水,有M个水龙头,第i个人打水所需时间为Ti,请安排一个合理的方案使得所有人的等待时间之和尽量小. 输入格式 第一 ...
- Java实现 蓝桥杯VIP 算法提高 change
算法提高 change 时间限制:1.0s 内存限制:256.0MB 问题描述 数组A中共有n个元素,初始全为0.你可以对数组进行两种操作:1.将数组中的一个元素加1:2.将数组中所有元素乘2.求将数 ...