
scikit-learn 学习笔记-- Generalized Linear Models (二)
Lasso regression
今天介绍另外一种带正则项的线性回归, ridge regression 的正则项是二范数,还有另外一种是一范数的,也就是lasso 回归,lasso 回归的正则项是系数的绝对值之和,这种正则项会让系数最后变得稀疏:
其中,N" role="presentation" style="position: relative;">NN 是样本的个数。
Elastic Net
Elastic Net 这种线性回归将二范数和一范数的正则都考虑进去了,两种正则项以某种权重的方式组合在一起,所以类似一种弹性的模型,这大概也是其名称的由来吧,elastic net 的目标函数为:
elastic net 模型可以让模型像 lasso regression 一样具有一定的稀疏性,同时又保持 ridge regression 的稳定性
import numpy as np

import matplotlib.pyplot as plt

from sklearn.metrics import r2_score

np.random.seed(42)

n_samples, n_features = 100, 100

X = np.random.randn(n_samples, n_features)

coef = 3 * np.random.randn(n_features)

inds = np.arange(n_features)

np.random.shuffle(inds)

coef[inds[10:]] = 0  # sparsify coef

y = np.dot(X, coef)

# add noise

y += 0.01 * np.random.normal(size=n_samples)

# Split data in train set and test set

n_samples = X.shape[0]

X_train, y_train = X[:n_samples // 2], y[:n_samples // 2]

X_test, y_test = X[n_samples // 2:], y[n_samples // 2:]

# #############################################################################

# Lasso

from sklearn.linear_model import Lasso

alpha = 0.1

lasso = Lasso(alpha=alpha)

y_pred_lasso = lasso.fit(X_train, y_train).predict(X_test)

r2_score_lasso = r2_score(y_test, y_pred_lasso)

print(lasso)

print("r^2 on test data : %f" % r2_score_lasso)

# #############################################################################

# ElasticNet

from sklearn.linear_model import ElasticNet

enet = ElasticNet(alpha=alpha, l1_ratio=0.7)

y_pred_enet = enet.fit(X_train, y_train).predict(X_test)

r2_score_enet = r2_score(y_test, y_pred_enet)

print(enet)

print("r^2 on test data : %f" % r2_score_enet)

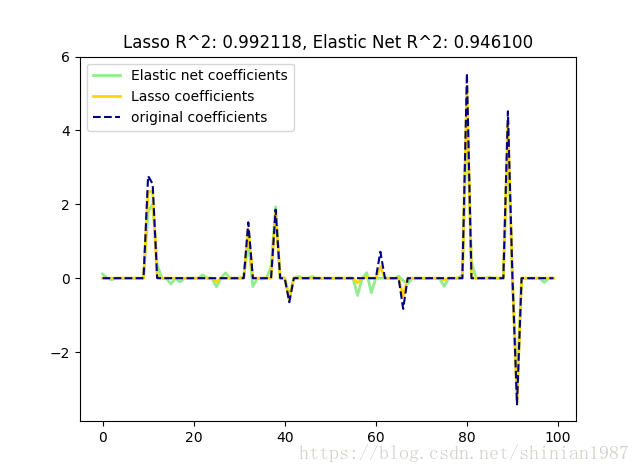
plt.plot(enet.coef_, color='lightgreen', linewidth=2,

         label='Elastic net coefficients')

plt.plot(lasso.coef_, color='gold', linewidth=2,

         label='Lasso coefficients')

plt.plot(coef, '--', color='navy', label='original coefficients')

plt.legend(loc='best')

plt.title("Lasso R^2: %f, Elastic Net R^2: %f"

          % (r2_score_lasso, r2_score_enet))

plt.show()

#########################

**output**:

Lasso(alpha=0.1, copy_X=True, fit_intercept=True, max_iter=1000,

   normalize=False, positive=False, precompute=False, random_state=None,

   selection='cyclic', tol=0.0001, warm_start=False)

r^2 on test data : 0.992118

ElasticNet(alpha=0.1, copy_X=True, fit_intercept=True, l1_ratio=0.7,

      max_iter=1000, normalize=False, positive=False, precompute=False,

      random_state=None, selection='cyclic', tol=0.0001, warm_start=False)

r^2 on test data : 0.946100

#########################
scikit-learn 学习笔记-- Generalized Linear Models (二)的更多相关文章
- scikit-learn 学习笔记-- Generalized Linear Models (一)
scikit-learn 是非常优秀的一个有关机器学习的 Python Lib,包含了除深度学习之外的传统机器学习的绝大多数算法,对于了解传统机器学习是一个很不错的平台.每个算法都有相应的例子,既可以 ...
- scikit-learn 学习笔记-- Generalized Linear Models (三)
Bayesian regression 前面介绍的线性模型都是从最小二乘,均方误差的角度去建立的,从最简单的最小二乘到带正则项的 lasso,ridge 等.而 Bayesian regression ...
- Andrew Ng机器学习公开课笔记 -- Generalized Linear Models
网易公开课,第4课 notes,http://cs229.stanford.edu/notes/cs229-notes1.pdf 前面介绍一个线性回归问题,符合高斯分布 一个分类问题,logstic回 ...
- 机器学习-scikit learn学习笔记
scikit-learn官网:http://scikit-learn.org/stable/ 通常情况下,一个学习问题会包含一组学习样本数据,计算机通过对样本数据的学习,尝试对未知数据进行预测. 学习 ...
- [Scikit-learn] 1.1 Generalized Linear Models - from Linear Regression to L1&L2
Introduction 一.Scikit-learning 广义线性模型 From: http://sklearn.lzjqsdd.com/modules/linear_model.html#ord ...
- [Scikit-learn] 1.5 Generalized Linear Models - SGD for Regression
梯度下降 一.亲手实现“梯度下降” 以下内容其实就是<手动实现简单的梯度下降>. 神经网络的实践笔记,主要包括: Logistic分类函数 反向传播相关内容 Link: http://pe ...
- [Scikit-learn] 1.5 Generalized Linear Models - SGD for Classification
NB: 因为softmax,NN看上去是分类,其实是拟合(回归),拟合最大似然. 多分类参见:[Scikit-learn] 1.1 Generalized Linear Models - Logist ...
- [Scikit-learn] 1.1 Generalized Linear Models - Logistic regression & Softmax
二分类:Logistic regression 多分类:Softmax分类函数 对于损失函数,我们求其最小值, 对于似然函数,我们求其最大值. Logistic是loss function,即: 在逻 ...
- 广义线性模型(Generalized Linear Models)
前面的文章已经介绍了一个回归和一个分类的例子.在逻辑回归模型中我们假设: 在分类问题中我们假设: 他们都是广义线性模型中的一个例子,在理解广义线性模型之前需要先理解指数分布族. 指数分布族(The E ...
随机推荐
- 嵌入式linux内核制作、根文件系统制作
嵌入式系统构成: 主要由bootloader.kernel.以及根文件系统三部分组成. 内核制作步骤: 制作嵌入式平台使用的linux内核制作方法与pc平台上的linux内核基本一致 1.清除原有配置 ...
- Hadoop HDFS的Shell操作实例
本文发表于本人博客. 我们知道HDFS是Hadoop的分布式文件系统,那既然是文件系统那最起码会有管理文件.文件夹之类的功能吧,这个类似我们的Windows操作系统一样的吧,创建.修改.删除.移动.复 ...
- 手把手教你学node之搭建node.js开发环境
搭建node.js开发环境 本文只针对在Linux或者Mac下面.至于使用 Windows 并坚持玩新技术的同学,我坚信他们一定有着过人的.甚至是不可告人的兼容性 bug 处理能力,所以这部分同学麻烦 ...
- .Ignite是什么
Ignite是什么 Apache Ignite内存数据组织是高性能的.集成化的以及分布式的内存平台,他可以实时地在大数据集中执行事务和计算,和传统的基于磁盘或者闪存的技术相比,性能有数量级的提升. ...
- Underscore-逐行分析
标签: // Underscore.js 1.8.3// http://underscorejs.org// (c) 2009-2015 Jeremy Ashkenas, DocumentCloud ...
- 根据Excel文件中的内容,修改指定文件夹下的文件名称
问题:根据Excel文件中内容,把文件名称由第2列,改为第1列.比如:把文件“123.jpg”修改为“1.jpg”.
- vw 、vh、vmin 、vmax
转自:https://blog.csdn.net/romantic_love/article/details/80868909 vw.vh.vmin.vmax是一种视窗单位,也是相对单位. 它相对的不 ...
- Log4js 工作原理及代码简析
本文地址 http://www.cnblogs.com/jasonxuli/p/6518650.html log4js 版本 0.6.16, 最新版1.1.1 大体类似. 使用 log4j ...
- linux第七章读书笔记
Vim编辑器 Vim 仅仅通过键盘来在插入和执行命令等多种模式之间切换.这使得Vim可以不用进行菜单或者鼠标操作,并且最小化组合键的操作,对文字录入员或者程序员可以大大增强速度和效率. CHAPTER ...
- java实验五20145204
java实验 Tcp传输 实验内容 运行代码一人服务器,一人客户端. 下载加解密代码,先编译运行代码,一人加密一人解密,适当修改代码. 集成代码,一人加密后通过TCP发送,加密使用AES或DES,AE ...