
07、RDD持久化
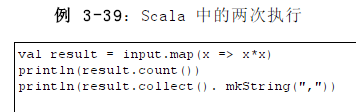
|
持久化级别 |
|
|
MEMORY_ONLY |
以非序列化的Java对象的方式持久化在JVM内存中。如果内存无法完全存储RDD所有的partition,那么那些没有持久化的partition就会在下一次需要使用它的时候,重新被计算 |
|
MEMORY_AND_DISK |
同上,但是当某些partition无法存储在内存中时,会持久化到磁盘中。下次需要使用这些partition时,需要从磁盘上读取 |
|
MEMORY_ONLY_SER |
同MEMORY_ONLY,但是会使用Java序列化方式,将Java对象序列化后进行持久化。可以减少内存开销,但是需要进行反序列化,因此会加大CPU开销 |
|
MEMORY_AND_DSK_SER |
同MEMORY_AND_DSK。但是使用序列化方式持久化Java对象 |
|
DISK_ONLY |
使用非序列化Java对象的方式持久化,完全存储到磁盘上 |
|
MEMORY_ONLY_2 MEMORY_AND_DISK_2 等等 |
如果是尾部加了2的持久化级别,表示会将持久化数据复用一份,保存到其他节点,从而在数据丢失时,不需要再次计算,只需要使用备份数据即可 |
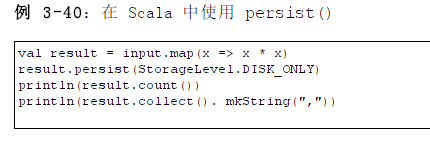
}
07、RDD持久化的更多相关文章
- Spark RDD概念学习系列之rdd持久化、广播、累加器(十八)
1.rdd持久化 2.广播 3.累加器 1.rdd持久化 通过spark-shell,可以快速的验证我们的想法和操作! 启动hdfs集群 spark@SparkSingleNode:/usr/loca ...
- Spark RDD持久化、广播变量和累加器
Spark RDD持久化 RDD持久化工作原理 Spark非常重要的一个功能特性就是可以将RDD持久化在内存中.当对RDD执行持久化操作时,每个节点都会将自己操作的RDD的partition持久化到内 ...
- 【Spark调优】:RDD持久化策略
[场景] Spark对RDD执行一系列算子操作时,都会重新从头到尾计算一遍.如果中间结果RDD后续需要被被调用多次,可以显式调用 cache()和 persist(),以告知 Spark,临时保存之前 ...
- spark rdd持久化的简单对比
未使用rdd持久化 使用后 通过对比可以发现,未使用RDD持久化时,第一次计算比使用RDD持久化要快,但之后的计算显然要慢的多,差不多10倍的样子 代码 public class PersistRDD ...
- 8、RDD持久化
一.RDD持久化 1.不使用RDD持久化的问题 2.RDD持久化原理 Spark非常重要的一个功能特性就是可以将RDD持久化在内存中.当对RDD执行持久化操作时,每个节点都会将自己操作的RDD的par ...
- Spark练习之创建RDD(集合、本地文件),RDD持久化及RDD持久化策略
Spark练习之创建RDD(集合.本地文件) 一.创建RDD 二.并行化集合创建RDD 2.1 Java并行创建RDD--计算1-10的累加和 2.2 Scala并行创建RDD--计算1-10的累加和 ...
- 五、RDD持久化
Spark最重要的一个功能是它可以通过各种操作(operations)持久化(或者缓存)一个集合到内存中.当你持久化一个RDD的时候,每一个节点都将参与计算的所有分区数据存储到内存中,并且这些数据可以 ...
- spark复习笔记(6):RDD持久化
在spark中最重要的功能之一是跨操作在内存中持久化数据集.当你持久化一个RDD的时候,每个节点都存放了一个它在内存中计算的一个分区,并在该数据集的其他操作中进行重用,持久化一个RDD的时候,节点上的 ...
- Spark性能调优篇二之重构RDD架构及RDD持久化
如果一个RDD在两个地方用到,就持久化他.不然第二次用到他时,会再次计算. 直接调用cache()或者presist()方法对指定的RDD进行缓存(持久化)操作,同时在方法中指定缓存的策略. 原文:h ...
随机推荐
- Python 实现红绿灯
一.通过Event来实现两个或多个线程间的交互,下面是一个红绿灯的例子,即起动一个线程做交通指挥信号灯,一个线程做车辆,车辆行驶按红灯停,绿灯行的规则. #!/usr/bin/python # -*- ...
- BZOJ1799 self 同类分布 数位dp
BZOJ1799self 同类分布 去博客园看该题解 题意 给出a,b,求出[a,b]中各位数字之和能整除原数的数的个数. [约束条件]1 ≤ a ≤ b ≤ 10^18 题解 1.所有的位数之和&l ...
- Java中文字符所占的字节数
Java语言中,中文字符所占的字节数取决于字符的编码方式,一般情况下,采用ISO8859-1编码方式时,一个中文字符与一个英文字符一样只占1个字节:采用GB2312或GBK编码方式时,一个中文字符占2 ...
- union和union all的区别(面试常考)
Union:对两个结果集进行并集操作,不包括重复行,同时进行默认规则的排序: Union All:对两个结果集进行并集操作,包括重复行,不进行排序: Union因为要进行重复值扫描,所以效率低.如果合 ...
- LeetCode竞赛题:笨阶乘(我们设计了一个笨阶乘 clumsy:在整数的递减序列中,我们以一个固定顺序的操作符序列来依次替换原有的乘法操作符:乘法(*),除法(/),加法(+)和减法(-)。)
通常,正整数 n 的阶乘是所有小于或等于 n 的正整数的乘积.例如,factorial(10) = 10 * 9 * 8 * 7 * 6 * 5 * 4 * 3 * 2 * 1.相反,我们设计了一个笨 ...
- 01++ Bookshelf 2
http://poj.org/problem?id=3628 就是比原题多了一个要求,输出>=m的最小值 kisang~独立做出来的都开心<( ̄︶ ̄)> #include<cs ...
- HDU 1010 Tempter of the Bone (DFS+可行性奇偶剪枝)
<题目链接> 题目大意:一个迷宫,给定一个起点和终点,以及一些障碍物,所有的点走过一次后就不能再走(该点会下陷).现在问你,是否能从起点在时间恰好为t的时候走到终点. 解题分析:本题恰好要 ...
- POJ 3579 Median 【二分答案】
<题目链接> 题目大意: 给出 N个数,对于存有每两个数的差值的序列求中位数,如果这个序列长度为偶数个元素,就取中间偏小的作为中位数. 解题分析: 由于本题n达到了1e5,所以将这些数之间 ...
- Django之setting文件
Django之setting文件 转载:https://www.jb51.net/article/128678.htm 目录 设置语言.时区 app路径 数据库配置 静态文件配置 中间件 sessio ...
- 对于长沙互联网发展,一个外来两年Java程序员的所见所感所愿
惟楚有材,于斯为盛 本文有感于2019长沙互联网求职招聘大会,内容比较多,但都是我自己的一些所见.所感和所愿. 2019年3月的最后一天,参加2019长沙互联网求职招聘大会,看到了很多的招聘企业,也看 ...