
[MapReduce_4] MapTask 并发数的决定机制
0. 说明
介绍 && Map 个数 & Reduce 个数指定 && Map 切片计算
1. 介绍
一个 job 的 Map 阶段并行度由客户端在提交 job 时决定
客户端对 Map 阶段并行度的规划基本逻辑为:
1. 将待处理的文件进行逻辑切片(根据切片大小,逻辑上划分多个 split ),然后每一个 split 分配一个 MapTask 并行处理实例
2. 具体切片规划是由 FileInputFormat 实现类的 getSplits()方法 完成
2. Map 个数 & Reduce 个数指定
Map个数指定:
- 根据文件个数指定
- 根据压缩文件可切割性
Reduce个数指定:
job.setNumReduceTasks(3);
3. Map 切片计算
【3.1 通过文件类型判断是否可切片】
判断文件类型(是否可切割),通过文件名后缀的反转来进行编解码器的判断
- 无压缩编解码器 // 可切割
- 可切割的压缩编解码器 // 可切割
- 不可切割的压缩编解码器 // 不可切割,切片大小即文件大小
SequenceFile
可切割,无论用什么压缩方式,或压缩编解码器
【3.2 切片计算】
最大切片值(MaxValue): Long.MAX_VALUE
最小切片值(MinValue): 1
块大小(BlockSize ): 32M(本地模式) 128M(分布式)
切片计算
Math.max(MinValue , Math.min(MaxValue,BlockSize));
通过设置最大切片值和最小切片值确定切片大小
// 设置最大切片大小

FileInputFormat.setMaxInputSplitSize(job,100);

// 设置最小切片大小

FileInputFormat.setMinInputSplitSize(job,100);
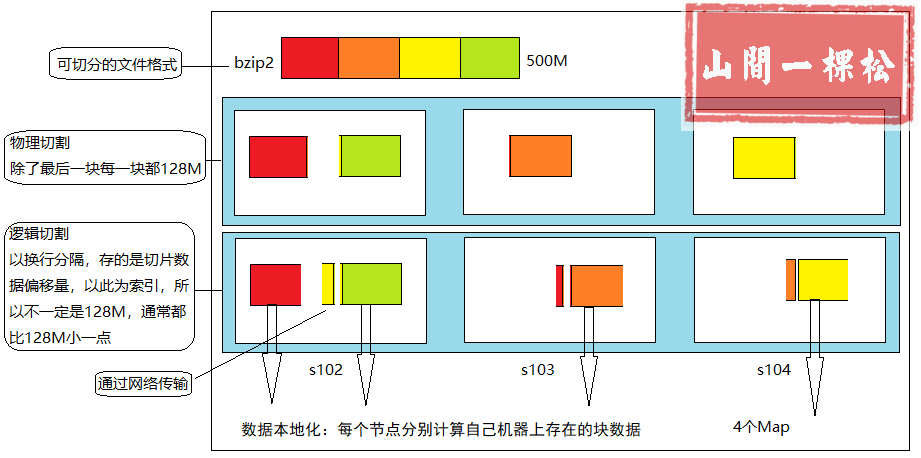
【3.3 总结逻辑切割】
1、先进行数据切片,切片结果保留在 temp 下,job.split,里面存有切片数据偏移量索引
2、每个 Map 通过此索引来计算属于自己的切片数据
[MapReduce_4] MapTask 并发数的决定机制的更多相关文章
- 并发读写缓存实现机制(一):为什么ConcurrentHashMap可以这么快?
大家都知道ConcurrentHashMap的并发读写速度很快,但为什么它会这么快?这主要归功于其内部数据结构和独特的hash运算以及分离锁的机制.做游戏性能很重要,为了提高数据的读写速度,方法之一就 ...
- 探索 ConcurrentHashMap 高并发性的实现机制--转
ConcurrentHashMap 是 Java concurrent 包的重要成员.本文将结合 Java 内存模型,来分析 ConcurrentHashMap 的 JDK 源代码.通过本文,读者将了 ...
- 不到50行代码实现一个能对请求并发数做限制的通用RequestDecorator
使用场景 在开发中,我们可能会遇到一些对异步请求数做并发量限制的场景,比如说微信小程序的request并发最多为5个,又或者我们需要做一些批量处理的工作,可是我们又不想同时对服务器发出太多请求(可能会 ...
- 对请求并发数做限制的通用RequestDecorator
使用场景 在开发中,我们可能会遇到一些对异步请求数做并发量限制的场景,比如说微信小程序的request并发最多为5个,又或者我们需要做一些批量处理的工作,可是我们又不想同时对服务器发出太多请求(可能会 ...
- 【转】探索 ConcurrentHashMap 高并发性的实现机制
原文链接:https://www.ibm.com/developerworks/cn/java/java-lo-concurrenthashmap/ <探索 ConcurrentHashMap ...
- MySQL事务、并发问题、锁机制
MySQL事务,并发问题,锁机制 1.什么是事务 事务是一条或多条数据库操作语句的组合,具备ACID,4个特点. 原子性:要不全部成功,要不全部撤销 隔离性:事务之间相互独立,互不干扰 一致性:数据库 ...
- 【Java 并发】Executor框架机制与线程池配置使用
[Java 并发]Executor框架机制与线程池配置使用 一,Executor框架Executor框架便是Java 5中引入的,其内部使用了线程池机制,在java.util.cocurrent 包下 ...
- PV 与 并发数 之间的故事
PV: Page View UV: Unique Visitor 在一些已经上线的项目中,运营会统计每日的PV,UV,IP 等数据 而根据PV量,可以推算出一个相对较科学的并发数,来作为负载测试的一个 ...
- mmysql-最大链接数和最大并发数的区别
关于连接数和并发数的设置(针对Innodb引擎) 对于机器本身来说,进程数是说机器正在运行的进程数量,调出任务管理器就可以看到.连接数是指进程接收和发送数据的连接ip的数量.并发数是指进程同时发送数据 ...
随机推荐
- HBase入门教程ppt
HBase – Hadoop Database,是一个高可靠性.高性能.面向列.可伸缩的分布式存储系统,利用HBase技术可在廉价PC Server上搭建起大规模结构化存储集群.HBase利用Hado ...
- 从零开始学 Web 之 DOM(三)innerText与innerHTML、自定义属性
大家好,这里是「 Daotin的梦呓 」从零开始学 Web 系列教程.此文首发于「 Daotin的梦呓 」公众号,欢迎大家订阅关注.在这里我会从 Web 前端零基础开始,一步步学习 Web 相关的知识 ...
- 从零开始学 Web 之 移动Web(七)Bootstrap
大家好,这里是「 从零开始学 Web 系列教程 」,并在下列地址同步更新...... github:https://github.com/Daotin/Web 微信公众号:Web前端之巅 博客园:ht ...
- Maven的assembly插件实现自定义打包部署(包含依赖jar包)
微服务必备 优点: 1.可以直接导入依赖jar包 2.可以添加插件启动 .sh 文件 3.插件的配置以及微服务的统一打包方式 1.首先我们需要在pom.xml中配置maven的assembly插件 & ...
- 深入理解L1、L2正则化
过节福利,我们来深入理解下L1与L2正则化. 1 正则化的概念 正则化(Regularization) 是机器学习中对原始损失函数引入额外信息,以便防止过拟合和提高模型泛化性能的一类方法的统称.也就是 ...
- [译]ABP vNext微服务演示,项目状态和路线图
译注: ABP的主要负责人hikalkan最近又发布了一篇博客, 说明了ABP vNext的微服务演示,项目状态和路线图.其中特意对ABP的中文社区进行了感谢! 本文翻译自该博客文章(https:// ...
- [转]微擎人人商城m()函数调用model方法
本文转自:http://yangjunwei.com/a/3177.html 微擎人人商城p()函数可内部调用任意插件的函数 http://yangjunwei.com/a/3216.html
- LinQ是什么?
•LINQ(发音:Link)是语言级集成查询(Language INtegrated Query) •LINQ是一种用来进行数据访问的编程模型,使得.NET语言可以直接支持数据查询 •LINQ的目标是 ...
- Hive案例05-学生成绩表综合案例
1. 数据说明 (1) student表 hive> select * from student; # 学生ID 学生姓名 性别 年龄 所在系 # sid sname sex age dept ...
- mysql 8小时超时设置
1.打开MySQL配置文件 2.添加 interactive_timeout=31536000wait_timeout=31536000 3.重新启动服务 打开MySQL命令行界面查看设置是否成功