
浅析requests库响应对象的text和content属性
在做爬虫时请求网页的requests库是必不可少的,我们常常会用到 res = resquests.get(url) 方法,在获取网页的html代码时常常使用res的text属性: html = res.text,在下载图片或文件时常常使用res的content属性:
with open(filename, 'wb') as fp:

  fp.write(res.content)
下面我们来看看 'text' 和 'content' 的不同之处:
输出本博客的响应对象的 text
import requests

url = 'https://www.cnblogs.com/huwt/'

res = requests.get(url, timeout = 6)

print(res.text)
(只截取到<title>标签)
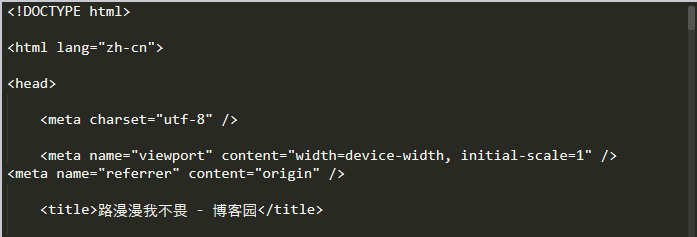
输出本博客的响应对象的 content
import requests

url = 'https://www.cnblogs.com/huwt/'

res = requests.get(url, timeout = 6)

print(res.content)
(只截取到<title>标签)

通过<title>标签我们可以看出 res.text 直接输出了汉字,而 res.content 好像是以十六进制的形式来表示汉字
为了让进一步了解text 和 content 我们来看看它们的类型:
import requests

url = 'https://www.cnblogs.com/huwt/'

res = requests.get(url, timeout = 6)

print(type(res.text))

print(type(res.content))

我们可以看到res.text是字符串类型,而res.content是二进制类型
为了进一步验证我们使用bytes类型的decode()方法对content进行‘utf-8’编码再显示
import requests

url = 'https://www.cnblogs.com/huwt/'

res = requests.get(url, timeout = 6)

print(res.content.decode('utf-8'))
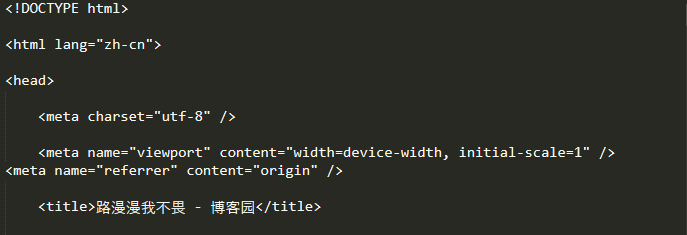
发现和res.text显示的内容完全一样
因此我们可以得出结论:
resp.text返回的是Unicode型的数据。

resp.content返回的是bytes型也就是二进制的数据。、

获取文本一般使用res.text, 获取图片或文件一般使用res.conten
再做几点补充:
text是content经过编码之后的字符串,那编码方式是什么呢?

在返回text时requests会基于 HTTP 头部对响应的编码作出有根据的推测,但不一定准确,有可能出现乱码,

而我们可以手动指定一种编码方式:res.encoding = '需要的编码方式'

或让requests根据body进行猜测:res.encoding = res.apparent_encoding
参考学习:
https://zhidao.baidu.com/question/941417472703558372.html
https://www.cnblogs.com/loveyouyou616/p/8135678.html
https://www.cnblogs.com/chownjy/p/6625299.html
https://www.jianshu.com/p/0e0336b370f3
浅析requests库响应对象的text和content属性的更多相关文章
- requests库响应消息体的四种格式
1.r.text 文本响应内容,返回字符串类型,获取网页html时用: 2.r.content 字节响应内容,返回字节类型,下载图片或者文件时用: 3.r.json json解码响应内容,返回字典 ...
- Requests库的文档高级用法
高级用法 本篇文档涵盖了 Requests 的一些高级特性. 会话对象 会话对象让你能够跨请求保持某些参数.它也会在同一个 Session 实例发出的所有请求之间保持 cookie, 期间使用 url ...
- requests库学习案例
requests库使用流程 使用流程/编码流程 1.指定url 2.基于requests模块发起请求 3.获取响应对象中的数据值 4.持久化存储 分析案例 需求:爬取搜狗首页的页面数据 # 爬取搜狗首 ...
- Python爬虫 requests库基础
requests库简介 requests是使用Apache2 licensed 许可证的HTTP库. 用python编写. 比urllib2模块更简洁. Request支持HTTP连接保持和连接池,支 ...
- express-6 请求和响应对象(1)
URL的组成部分 协议: 协议确定如何传输请求.我们主要是处理http和https.其他常见的协议还有file和ftp. 主机名: 主机名标识服务器.运行在本地计算机(localhost)和本地网络的 ...
- Node+Express中请求和响应对象
在用 Express 构建 Web 服务器时,大部分工作都是从请求对象开始,到响应对象终止. url的组成: 协议协议确定如何传输请求.我们主要是处理 http 和 https.其他常见的协议还有 f ...
- 【转载】requests库的7个主要方法、13个关键字参数以及响应对象的5种属性
Python爬虫常用模块:requests库的7个主要方法.13个关键字参数以及响应对象的5种属性 原文链接: https://zhuanlan.zhihu.com/p/67489739
- 4.爬虫 requests库讲解 GET请求 POST请求 响应
requests库相比于urllib库更好用!!! 0.各种请求方式 import requests requests.post('http://httpbin.org/post') requests ...
- 使用Python的requests库进行接口测试——session对象的妙用
from:http://blog.csdn.net/liuchunming033/article/details/48131051 在进行接口测试的时候,我们会调用多个接口发出多个请求,在这些请求中有 ...
随机推荐
- 当noncopyable遇见singleton
在实现单例类时,通常要把构造相关的几个函数访问权限设为private或protected(最好是private).但假设一个大型系统中,有数十个单例类(这很正常,单例类其实是外观模式的一种最常用设计) ...
- MVC+EF CODE FIRST的使用
1创建标准MVC项目 2通过NuGet安装EF 3在Models文件夹中编写实体类 4创建EFDB上下文类 5在webconfig中创建连接字符串,其中name=EFDB上下文类名 6通过管理控制台执 ...
- 自动化测试 selenium 环境搭建
做 web 项目,测试是无法避免的.对于某些特定功能,采用单元测试就行.但如果想对网站进行整体测试,人工点击测试可行但有点累,如果能借助自动化测试工具就更好了.selenium 就是一款能满足这样要求 ...
- HDU 6044--Limited Permutation(搜索+组合数+逆元)
题目链接 Problem Description As to a permutation p1,p2,⋯,pn from 1 to n, it is uncomplicated for each 1≤ ...
- Jquery 动态追加控件并获取值
先展示通过动态添加控件的结果: 实现步骤: 1.引用js文件 <script src="Script/jquery-1.5.1.min.js" type="text ...
- 使用 Portainer UI 管理 Docker 主机
Docker 使用命令行的方式来管理有时候并没有那么直观,可以使用 Portainer 的 UI 来管理 Docker 主机和 Docker Swarm 集群. 安装 Portainer 环境:cen ...
- mysql 开发进阶篇系列 33 工具篇(mysqlbinlog日志管理工具)
一.概述 由于服务器生成的二进制日志文件以二进制格式保存,所以如果要想检查这些文件的文本格式,就会用到mysqlbinlog日志管理工具. mysqlbinlog的语法如下: mysqlbinlog ...
- 安装和配置jBPM4,并举个hello.w
至于网上很复杂,但又不懂的插件,我们先不鸟他. myeclipse8\dropins这里就是给我们放插件的,类似SVN之类的.所以小生也修改了下,共享了下.只有放在目录下,打开应该可以的.下面是链接. ...
- Code Complete-13/7/29
Measure Twice,Cut Once! 漫步到第三章: just is about upstream prerequisites. 在构建活动开始之前,准备工作要做的周全. Upstream ...
- Kafka项目实战-用户日志上报实时统计之分析与设计
1.概述 本课程的视频教程地址:<Kafka实战项目之分析与设计> 本课程我通过一个用户实时上报日志案例作为基础,带着大家去分析Kafka这样一个项目的各个环节,从而对项目的整体设计做比 ...