表结构设计之 高表 与 宽表 选择
HBase 中的表可以设计为高表(tall-narrow table) 和 宽表(flat-wide table)。
高表 : 列少而行多。
宽表 : 行少而列多。
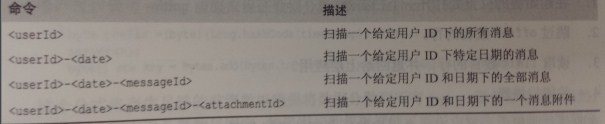
根据之前介绍的 KeyValue 信息的筛选粒度信息,用户应当尽量将需要查询的维度或信息存储在行键中,因为他的筛选数据的效率最高。此外,HBase只能按行分片,因此高表更有优势。设想用户将一个电子邮件都存储在一行中。这在大部分情况下都是合适的,但是也有人的收件箱中有大量的邮件。 大到一行数据就超过了最大 HFile 的限制,此时这个 HFile 无法拆分,同时也导致 region无法再合适的位置进行拆分。解决此问题的最好办法是把一个用户的每个电子邮件都存在单独的一行中,而行键可以是用户 userId 和消息 mesageId 的组合。
邮件系统。 用 userid + messageId(uuid) 因为 HBase 的行级原子性 可以根据用户是否批量修改 VALUE 内容
如果一个首检想中的数据现在分布在多行中,所以高表不可能在一次简单的操作中修改一个收件箱的全局属性, 如果用户不需要一次修改整个收件箱中所有邮件的消息,高表设计就非常合适。 如果用户有这种修改全局的需求,宽表将更加适合。因为HBase 能保证数据操作的行级原子性。
表结构设计之 数据块大小 选择( 65535 )
数据块小—索引大—占用更大的内存。 (同时加载进内存的数据块越小,随机查找性能就更好)
相反如果需要更好的序列扫描性能,那么一次性加载更多的HFile数据进入内存更为合理。这意味着应该讲数据块设置为更大的值。相应的,索引变小,将在随机读性能上付出更多的代价。
HFile 数据块大小可以在列族层次设置。这个数据块不同于之前谈到的HDFS数据块,默认值是65535字节,或65KB。数据块索引存储每个HFile数据块的起始键。数据块大小的设置影响数据块索引的大小。
hbase(main):> create 'mytable',{NAME => 'colfaml',BLOCKSIZE => '65535'}
表结构设计之 数据块缓存 ( OPEN )
把数据放入缓存,并不是一定能够提升性能。如果一个表的列族只被顺序化扫描访问 或 很少被访问,则get scan操作花费时间长是可以接受的。 这种情况下可以选择关闭列族的缓存。
如果执行多次顺序化扫描(多次使用缓存)并且可能会滥用魂村, 从而把应该放进缓存获得性能提升的数据给排挤出去。如果关闭缓存,可以避免上述情况,而且可以让出更多缓存给其他表和同一表的其他列族使用。
数据块缓存默认是打开的。可以新建或更改表时关闭数据块缓存属性:
hbase(main):> create 'mytable', {NAME => 'colfam1', BLOCKCACHE => 'false' }
IN_MEMORY 参数的默认值是 false ,该值表示 HBase 除了在数据块缓存中保存这个列族相比其他列族更激进之外,并不提供其他额外保证。该参数在实际应用中设置为 true,此时访问性能不会变化太大。 设置IN_MEMORY:
hbase(main):> create 'mytable', {NAME => 'colfam1', IN_MEMORY => 'true'}
表结构设计之 布隆过滤器(NONE)
布隆过滤器可以应用在块上,检查行键,也可以应用在行内的单元格上,当访问某列表示服时先使用同样的反向检测
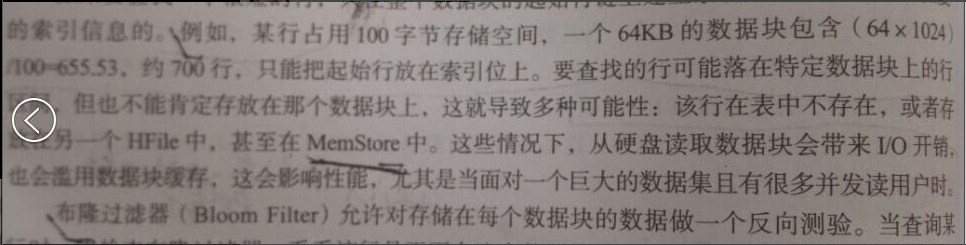
布隆过滤器允许对存储在每个数据块的数据做一个反向检测。查询行时,先查询布隆过滤器。(Bloom Filter)。看看该行是否不存在这个数据块, 要么返回该行不存在。要么返回不知道。
如果想要判断一个元素是不是在一个集合里,一般想到的是将所有元素保存起来,然后通过比较确定。
链表,树等等数据结构都是这种思路. 但是随着集合中元素的增加,我们需要的存储空间越来越大,检索速度也越来越慢(O(n),O(logn))。不过世界上还有一种叫作散列表(又叫
哈希表,Hash table)的数据结构。它可以通过一个
Hash函数将一个元素映射成一个位阵列(Bit array)中的一个点。这样一来,我们只要看看这个点是不是1就可以知道集合中有没有它了。这就是布隆过滤器的基本思想。
Hash面临的问题就是冲突。假设Hash函数是良好的,如果我们的位阵列长度为m个点,那么如果我们想将冲突率降低到例如 1%, 这个散列表就只能容纳m / 100个元素。显然这就不叫空间效率了(Space-efficient)了。解决方法也简单,就是使用多个Hash,如果它们有一个说元素不在集合中,那肯定就不在。如果它们都说在,虽然也有一定可能性它们在说谎,不过直觉上判断这种事情的
概率是比较低的。
存储这个额外的索引层需要占用额外的空间,占用的大小随着索引对象数据增长而增长。所以行级布隆过滤器比列标识符级布隆过滤器占用空间要小。当空间不是问题时,他们可以压榨整个系统的性能潜力
可以在列族上打布隆过滤器,代码:
hbase(main) > create 'mytable' , {NAME=>'colfam1', BLOOMFILTER => 'ROWCOL' }
NONE 布隆过滤器默认参数 。
ROW 表示 行级布隆过滤器(检查rowkey存不存在);
ROWCOL表示 列标识符级布隆过滤器(检查 rowkey 和 列限定符存不存在)。
· 为什么用布隆过滤器。 以及数据未被刷入HFile时在MemStore中。
表结构设计之 数据压缩(NONE)
数据压缩有助于节省磁盘空间,但是读写数据时压缩和解压缩会提高CPU使用率。除非确定压缩不会提升系统的性能,否则推荐打开表的压缩。
只有在数据不能被压缩,或者因为某些原因服务器的 CPU 利用率有限制的情况下,有可能需要关闭压缩特性。
HBase使用的压缩编码: SNAPPY拥有 BSD(BSD-licensed)许可,所以它更容易和 Hadoop 及 HBase 发行版捆绑在一起。 LZO 和 SNAPPY 的压缩比例和压缩 / 解压速度差不多。
创建表时可以在列族上打开压缩:
hbase(main)> create 'mytable' , {NAME => 'colfaml' , COMPRESSION => 'SNAPPY'}
数据只在硬盘上是压缩的,在内存中(MemStore 或 BlockCache)或在网络传输时是没有压缩的。
数据的压缩编码不能经常改变,如果需要改变某个列族的压缩编码,直接更改表定义,设定新的压缩编码,当Region合并时,生成的 HFile 全部会采用新的编码压缩。这个过程不需要创建新的表和复制数据。
表结构设计之 单元时间版本( 3 Version ) .生存空间(Time To Live) TTL默认68年值
如果只需要一个版本,在创建表时可以直接将 VERSION 的参数设置为1。时间版本也是列族级的。
hbase(main) > create 'mytable' , { NAME => 'colfaml', VERSION => 1}
可以在同一个建表语句中为列族设置版本 和 生命周期
hbase(main) > create 'mytable' , { NAME => 'colfaml' , VERSION => 1, TTL => '18000'} // TTL 值默认是永久保存,(2147483647)单位是秒。 此数校验为 68 年
可以指定列族存储的最少时间版本数。
hbase(main) > create 'mytable' , { NAME => 'colfaml' , VERSION => 5, MIN_VERSION => '1' }
TTL 生存时间,用于设置单元格的生存周期。 如果单元格过期,则会将其删除。
早于指定时间的数据会在下一次大合并时将其删除。
God has given me a gift. Only one. I am the most complete fighter in the world. My whole life, I have trained. I must prove I am worthy of someting. rocky_24
- HBase表结构设计--练习篇
一.表结构操作 1.建立一个表scores,有两个列族grad和course [hadoop@weekend01 ~]$ hbase shell hbase(main):006:0> creat ...
- hbase表结构设计
非常好的一个ppt HBase Schema design: http://www.slideshare.net/cloudera/5-h-base-schemahbasecon2012
- Hbase入门(四)——表结构设计-RowKey
Hbase的表结构设计与关系型数据库有很多不同,主要是Hbase有Rowkey和列族.timestamp这几个全新的概念,如何设计表结构就非常的重要. 创建 Hbase就是通过 表 Rowkey 列族 ...
- HBase(八): 表结构设计优化
在 HBase(六): HBase体系结构剖析(上) 介绍过,Hbase创建表时,只需指定表名和至少一个列族,基于HBase表结构的设计优化主要是基于列族级别的属性配置,如下图: 目录: BLOOMF ...
- MySQL基于左右值编码的树形数据库表结构设计
MySQL基于左右值编码的树形数据库表结构设计 在关系型数据库中设计树形的数据结构一直是一个十分考验开发者能力的,最常用的方案有主从表方案和继承关系(parent_id)方案.主从表方案的最大缺点 ...
- mysql 用户表结构设计,第三方登录
说起用户表,大概是每个应用/网站立项动工(码农们)考虑的第一件事情.用户表结构的设计,算是整个后台架构的基石.如果基石不稳,待到后面需求跟进了发现不能应付,回过头来反复修改用户表,要大大小小作改动的地 ...
- 数据库表结构设计方法及原则(li)
数据库设计的三大范式:为了建立冗余较小.结构合理的数据库,设计数据库时必须遵循一定的规则.在关系型数据库中这种规则就称为范式.范式是符合某一种设计要求的总结.要想设计一个结构合理的关系型数据库,必须满 ...
- 数据分页处理系列之二:HBase表数据分页处理
HBase是Hadoop大数据生态技术圈中的一项关键技术,是一种用于分布式存储大数据的列式数据库,关于HBase更加详细的介绍和技术细节,朋友们可以在网络上进行搜寻,笔者本人在接下来的日子里也会写 ...
- Laravel教程 七:表单验证 Validation
Laravel教程 七:表单验证 Validation 此文章为原创文章,未经同意,禁止转载. Laravel Form 终于要更新这个Laravel系列教程的第七篇了,期间去写了一点其他的东西. 就 ...
随机推荐
- 3dmax实例教程-使用3ds Max 创建一个完整的场景
本篇教程讲述了利用3ds max创建一个完整的场景. 灵感来源:当我在遇到一些事情睡不着觉的时候我便在努力想象一些别的事情,于是我便想到了这个场景,其实对于我的这个角色我即没有参考图也没有草稿图,有的 ...
- [HAOI2016]找相同字符(SAM+DP)
感觉很水. 因为SAM上一个点的子树大小代表这个点所表示子串的出现次数. 建出广义后缀自动机之后.在\(parent\)树上跑\(DP\),维护\(size[i][1]\),和\(size[i][0] ...
- Innodb中的事务隔离级别和锁的关系(转载)
nodb中的事务隔离级别和锁的关系 原文:https://tech.meituan.com/innodb-lock.html ameng ·2014-08-20 15:50 前言: 我们都知道事务的几 ...
- 使用yum配置lnmp环境(CentOS7.6)
一.安装版本详情 Server: MariaDB Server version: 5.5.60-MariaDB MariaDB Server [root@ln-125 ~]# cat /etc/red ...
- Springboot+swagger2的接口文档开发
一.创建一个SpringBoot项目 1. 2. 3. 4. 把web里的web选中,SQL里选择自己需要的,点击next 二.创建各项所需的controller,configure等 1. 项目布局 ...
- 紫书 习题 11-17 UVa 1670 (图论构造)
一开始要符合题目条件, 那么肯定没有任何一个点是孤立的, 也就是说没有点的度数是1 所以我就想让度数是1的叶子节点相互连起来.然后WA 然后看这哥们的博客 https://blog.csdn.net/ ...
- OCUI界面设计:滚动视图与分页控件初探
滚动视图(UIScrollView) 简单介绍 1.UIScrollView滚动视图能够排列并显示超出自身显示范围的内容. 2.UIScrollView内部整合了多种手势来达到丰富的界面展示效果. 3 ...
- [MST] Create an Entry Form to Add Models to the State Tree
It is time to add new entries to the wishlist. We will achieve this by reusing forms and models we'v ...
- 代理server poll version
poll和select一样,管理多个描写叙述符也是进行轮询,依据描写叙述符的状态进行处理,可是poll没有最大文件描写叙述符数量的限制,select is 1024/2048 #include &qu ...
- Atitit.html解析器的选型 jsoup nsoup ,java c# .net 版本号
Atitit.html解析器的选型 jsoup nsoup ,java c# .net 版本号 1. 框架选型的要求 1 1.1. 文档多 1 1.2. 跨平台 1 2. html解析器特性: 1 2 ...