
GO学习-(32) Go实现日志收集系统1
Go实现日志收集系统1
项目背景
- 每个系统都有日志,当系统出现问题时,需要通过日志解决问题
- 当系统机器比较少时,登陆到服务器上查看即可满足
- 当系统机器规模巨大,登陆到机器上查看几乎不现实
当然即使是机器规模不大,一个系统通常也会涉及到多种语言的开发,拿我们公司来说,底层是通过c++开发的,而也业务应用层是通过Python开发的,并且即使是C++也分了很多级别应用,python这边同样也是有多个应用,那么问题来了,每次系统出问题了,如何能够迅速查问题? 好一点的情况可能是python应用层查日志发现是系统底层处理异常了,于是又叫C++同事来查,如果C++这边能够迅速定位出错误告知python层这边还好,如果错误好排查,可能就是各个开发层的都在一起查到底是哪里引起的。当然可能这样说比较笼统,但是却引发了一个问题:
- 当系统出现问题后,如何根据日志迅速的定位问题出在一个应用层?
- 在平常的工作中如何根据日志分析出一个请求到系统主要在那个应用层耗时较大?
- 在平常的工作中如何获取一个请求到达系统后在各个层测日志汇总?
针对以上问题,我们想要实现的一个解决方案是:
- 把机器上的日志实时收集,统一的存储到中心系统
- 然后再对这些日志建立索引,通过搜索即可以找到对应日志
- 通过提供界面友好的web界面,通过web即可以完成日志搜索
关于实现这个系统时可能会面临的问题:
- 实时日志量非常大,每天几十亿条(虽然现在我们公司的系统还没达到这个级别)
- 日志准实时收集,延迟控制在分钟级别
- 能够水平可扩展
关于日志收集系统,业界的解决方案是ELK

ELK的解决方案是通用的一套解决方案,所以不免就会产生以下的几个问题:
- 运维成本高,每增加一个日志收集,都需要手动修改配置
- 监控缺失,无法准确获取logstash的状态
- 无法做定制化开发以及维护
针对这种情况,其实我们想要的系统是agent可以动态的获取某个服务器我们需要监控哪些日志
以及那些日志我们需要收集,并且当我们需要收集日志的服务器下线了,我们可以动态的停止收集
当然这些实现的效果最终也是通过web界面呈现。
日志收集系统设计
主要的架构图为
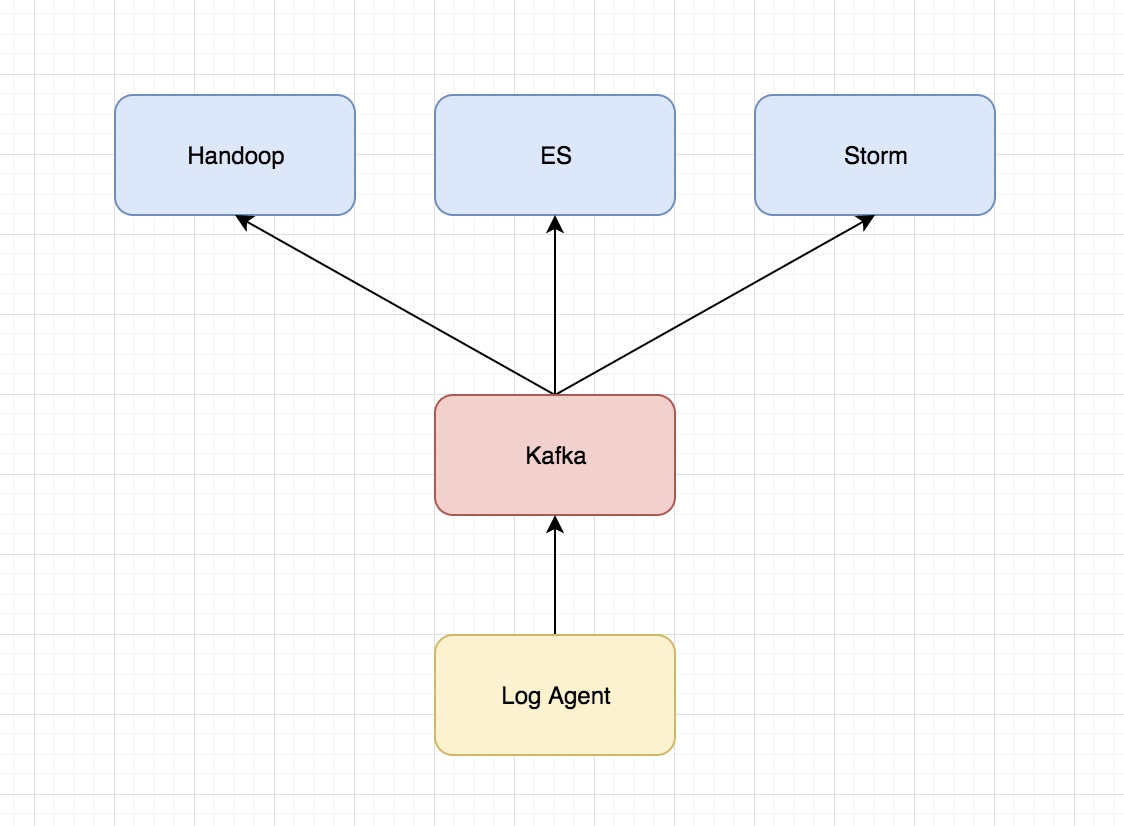
关于各个组件的说明:
- Log Agent,日志收集客户端,用来收集服务器上的日志
- Kafka,高吞吐量的分布式队列,linkin开发,apache顶级开源项目
- ES,elasticsearch,开源的搜索引擎,提供基于http restful的web接口
- Hadoop,分布式计算框架,能够对大量数据进行分布式处理的平台
关于Kakfa的介绍
Apache Kafka是一个分布式发布 - 订阅消息系统和一个强大的队列,可以处理大量的数据,并使您能够将消息从一个端点传递到另一个端点。 Kafka适合离线和在线消息消费。 Kafka消息保留在磁盘上,并在群集内复制以防止数据丢失。 Kafka构建在ZooKeeper同步服务之上。 它与Apache Storm和Spark非常好地集成,用于实时流式数据分析。
注:这里关于Kafka并不会介绍太多,只是对基本的内容和应用场景的说明,毕竟展开来说,这里的知识也是费非常多的
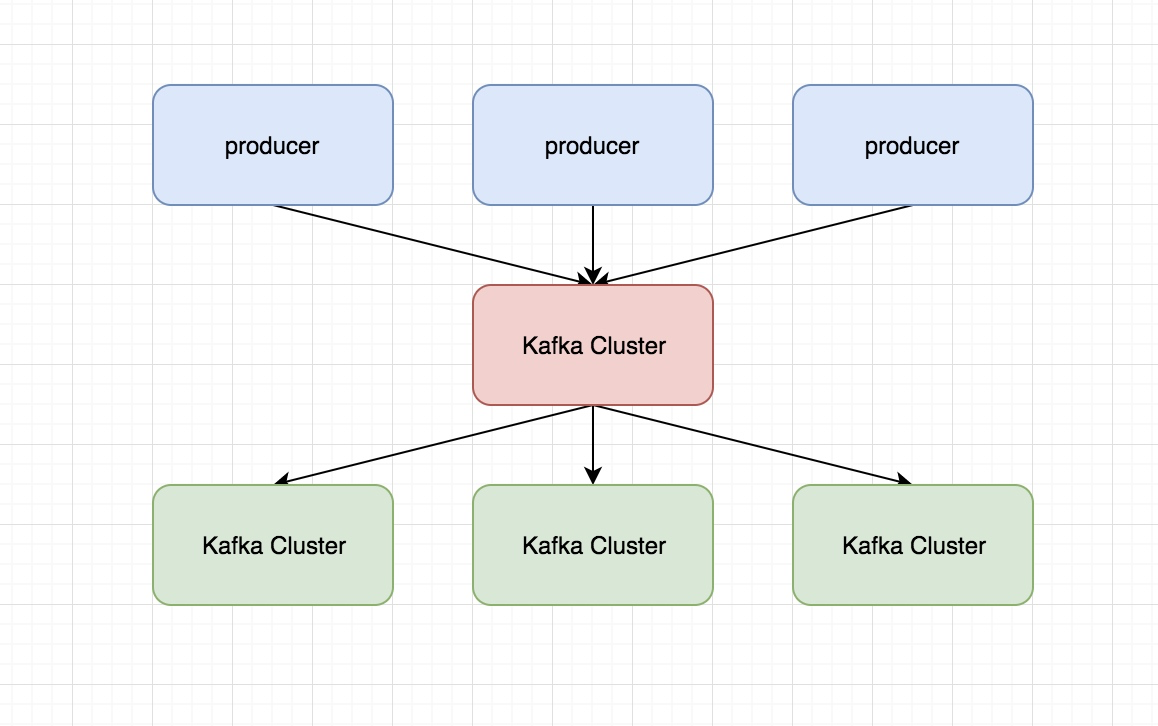
Kafka中有几个基本的消息术语需要了解:
- Kafka将消息以topic为单位进行归纳。
- 将向Kafka topic发布消息的程序成为producers.
- 将预订topics并消费消息的程序成为consumer.
- Kafka以集群的方式运行,可以由一个或多个服务组成,每个服务叫做一个broker.
Kafka的优点:
- 可靠性 - Kafka是分布式,分区,复制和容错的。
- 可扩展性 - Kafka消息传递系统轻松缩放,无需停机。
- 耐用性 - Kafka使用分布式提交日志,这意味着消息会尽可能快地保留在磁盘上,因此它是持久的。
- 性能 - Kafka对于发布和订阅消息都具有高吞吐量。 即使存储了许多TB的消息,它也保持稳定的性能。
Kafka非常快,并保证零停机和零数据丢失。
Kafka的应用场景:
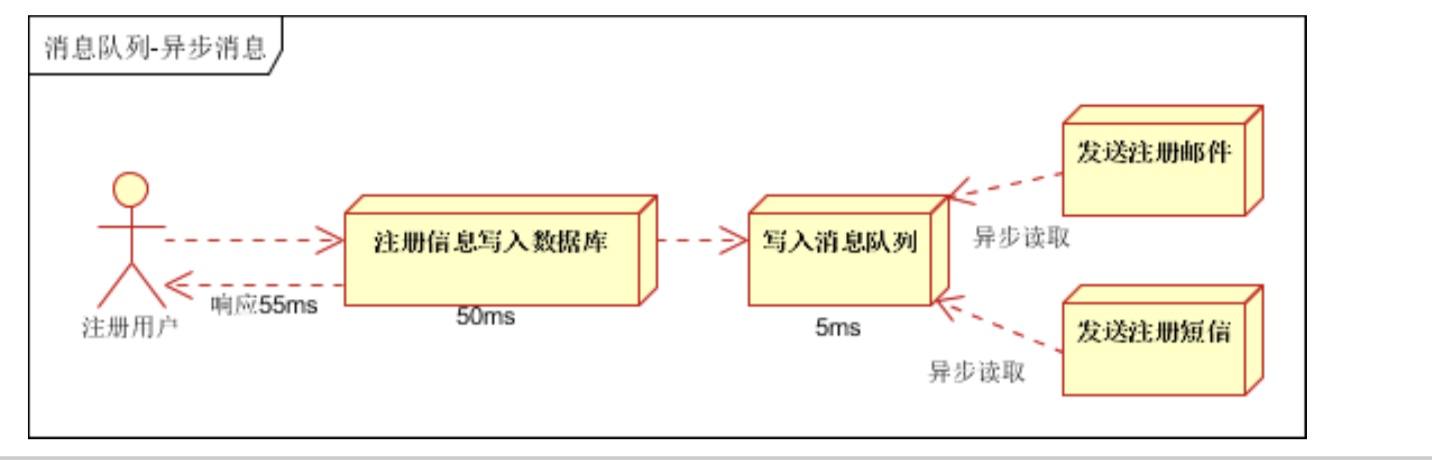
- 异步处理, 把非关键流程异步化,提高系统的响应时间和健壮性

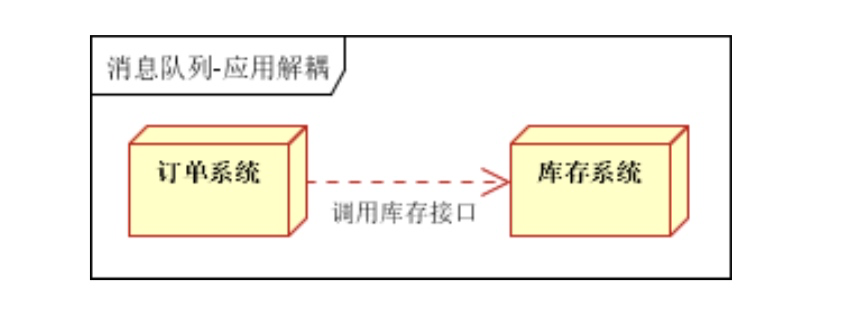
- 应用解耦,通过消息队列

- 流量削峰
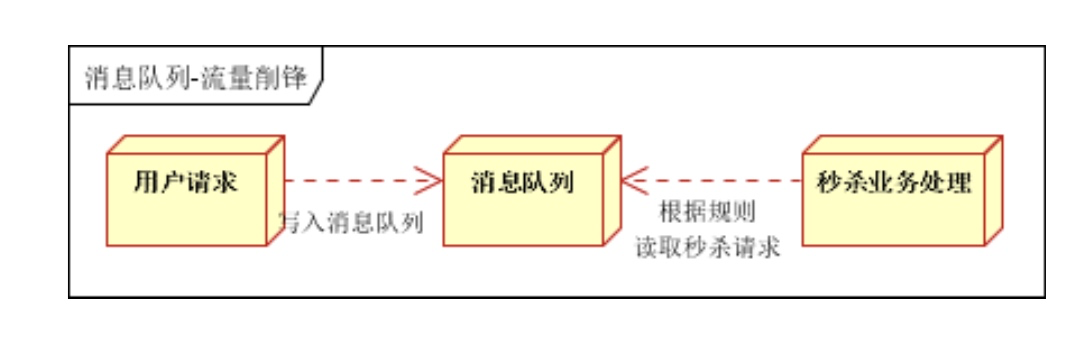
关于ZooKeeper介绍
ZooKeeper是一种分布式协调服务,用于管理大型主机。在分布式环境中协调和管理服务是一个复杂的过程。ZooKeeper通过其简单的架构和API解决了这个问题。ZooKeeper允许开发人员专注于核心应用程序逻辑,而不必担心应用程序的分布式特性。
Apache ZooKeeper是由集群(节点组)使用的一种服务,用于在自身之间协调,并通过稳健的同步技术维护共享数据。ZooKeeper本身是一个分布式应用程序,为写入分布式应用程序提供服务。
ZooKeeper主要包含几下几个组件:
- Client(客户端):我们的分布式应用集群中的一个节点,从服务器访问信息。对于特定的时间间隔,每个客户端向服务器发送消息以使服务器知道客户端是活跃的。类似地,当客户端连接时,服务器发送确认码。如果连接的服务器没有响应,客户端会自动将消息重定向到另一个服务器。
- Server(服务器):服务器,我们的ZooKeeper总体中的一个节点,为客户端提供所有的服务。向客户端发送确认码以告知服务器是活跃的。
- Ensemble:ZooKeeper服务器组。形成ensemble所需的最小节点数为3。
- Leader: 服务器节点,如果任何连接的节点失败,则执行自动恢复。Leader在服务启动时被选举。
- Follower:跟随leader指令的服务器节点。
ZooKeeper的应用场景:
- 服务注册&服务发现

- 配置中心
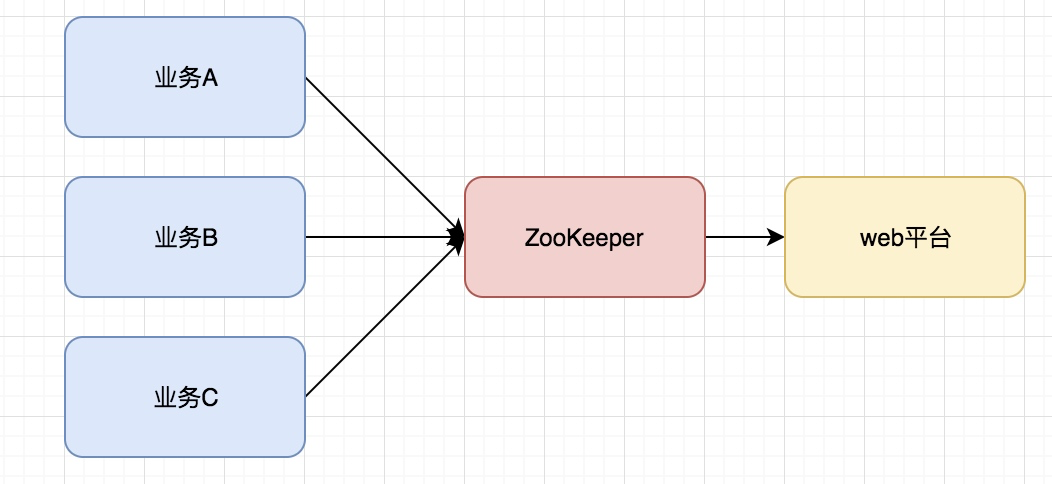
- 分布式锁
Zookeeper是强一致的多个客户端同时在Zookeeper上创建相同znode,只有一个创建成功
关于Log Agent
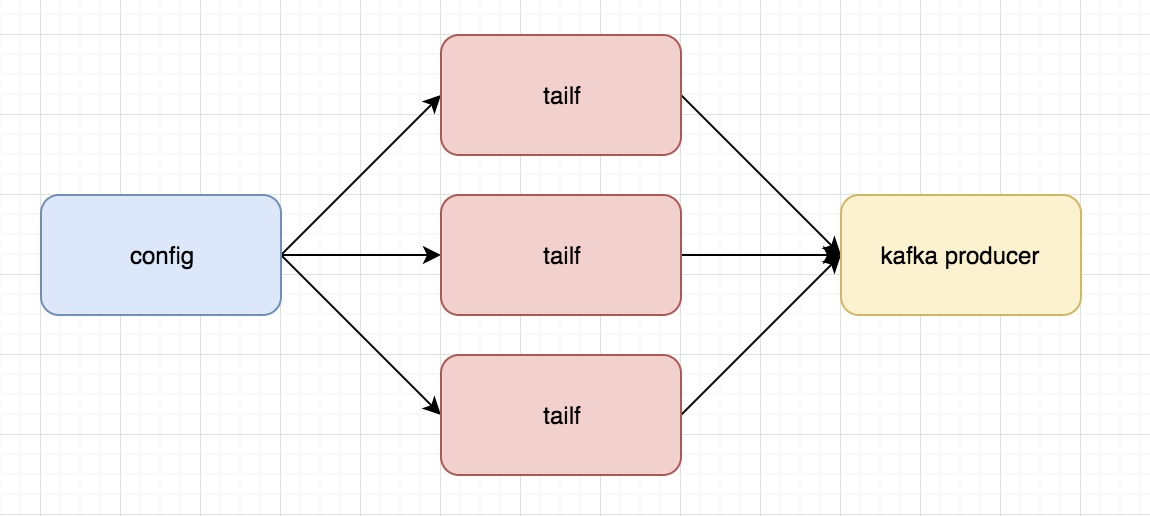
这个就是我们后面要通过代码实现的一步分内容,主要实现的功能是:
类似于我们在linux下通过tail的方法读日志文件,讲读取的内容发给Kafka
这里需要知道的是,我们这里的tailf是可以动态变化的,当配置文件发生变化是,可以通知我们程序自动增加需要增加的tailf去获取相应的日志并发给kafka producer
主要由一下几部目录组成:
- Kafka
- tailf
- configlog
GO学习-(32) Go实现日志收集系统1的更多相关文章
- GO学习-(35) Go实现日志收集系统4
Go实现日志收集系统4 到这一步,我的收集系统就已经完成很大一部分工作,我们重新看一下我们之前画的图: 我们已经完成前面的部分,剩下是要完成后半部分,将kafka中的数据扔到ElasticSear ...
- GO学习-(34) Go实现日志收集系统3
Go实现日志收集系统3 再次整理了一下这个日志收集系统的框,如下图 这次要实现的代码的整体逻辑为: 完整代码地址为: etcd介绍 高可用的分布式key-value存储,可以用于配置共享和服务发现 ...
- GO学习-(33) Go实现日志收集系统2
Go实现日志收集系统2 一篇文章主要是关于整体架构以及用到的软件的一些介绍,这一篇文章是对各个软件的使用介绍,当然这里主要是关于架构中我们agent的实现用到的内容 关于zookeeper+kaf ...
- Go语言学习之11 日志收集系统kafka库实战
本节主要内容: 1. 日志收集系统设计2. 日志客户端开发 1. 项目背景 a. 每个系统都有日志,当系统出现问题时,需要通过日志解决问题 b. 当系统机器比较少时,登陆到服务器上查看即可 ...
- ELK+kafka构建日志收集系统
ELK+kafka构建日志收集系统 原文 http://lx.wxqrcode.com/index.php/post/101.html 背景: 最近线上上了ELK,但是只用了一台Redis在 ...
- [转载] 一共81个,开源大数据处理工具汇总(下),包括日志收集系统/集群管理/RPC等
原文: http://www.36dsj.com/archives/25042 接上一部分:一共81个,开源大数据处理工具汇总(上),第二部分主要收集整理的内容主要有日志收集系统.消息系统.分布式服务 ...
- Apache Flume日志收集系统简介
Apache Flume是一个分布式.可靠.可用的系统,用于从大量不同的源有效地收集.聚合.移动大量日志数据进行集中式数据存储. Flume简介 Flume的核心是Agent,Agent中包含Sour ...
- 一共81个,开源大数据处理工具汇总(下),包括日志收集系统/集群管理/RPC等
作者:大数据女神-诺蓝(微信公号:dashujunvshen).本文是36大数据专稿,转载必须标明来源36大数据. 接上一部分:一共81个,开源大数据处理工具汇总(上),第二部分主要收集整理的内容主要 ...
- 容器云平台No.9~kubernetes日志收集系统EFK
EFK介绍 EFK,全称Elasticsearch Fluentd Kibana ,是kubernetes中比较常用的日志收集方案,也是官方比较推荐的方案. 通过EFK,可以把集群的所有日志收集到El ...
随机推荐
- .NET6 平台系列2 .NET Framework框架详解
系列目录 [已更新最新开发文章,点击查看详细] 什么是 .NET Framework? .NET Framework 是 Windows 的托管执行环境,可为其运行的应用提供各种服务. 它包括 ...
- kubernetes集群证书更新
kubeadm 默认证书为一年,一年过期后,会导致api service不可用,使用过程中会出现:x509: certificate has expired or is not yet valid. ...
- 5- MySQL数据库SELECT查询操作
复习: 数据类型: 数值型:整数(int,tinyint,smallint,bigint,mediumint) 浮点型(float ,double,decimal) 字符型:char(固定长度) ,v ...
- IE 兼容问题笔记
IE 兼容问题笔记 解决IE11兼容HTML5 设置 document.body的一些用法以及js中的常见问题 flex布局浏览器兼容处理 ie8, ie9 css3 media媒体查询器用法总结 c ...
- 【Scrapy(四)】scrapy 分页爬取以及xapth使用小技巧
scrapy 分页爬取以及xapth使用小技巧 这里以爬取www.javaquan.com为例: 1.构建出下一页的url: 很显然通过dom树,可以发现下一页所在的a标签 2.使用scrapy的 ...
- Think5之ajax批量删除数据功能
//批量删除学员信息 public function deleteMany() { $id = input('post.'); //判断id是数组还是一个数值 if(is_array($id)){ f ...
- 【ORM】Mybatis与JPA的区别
Mybatis与JPA的区别: 1.ORM映射不同: Mybatis是半自动的ORM框架,提供数据库与结果集的映射: JPA(Hibernate)是全自动的ORM框架,提供对象与数据库的映射: 2.可 ...
- 【原创】ansible常用模块整理
一.Ansible模块帮助 ansible-doc -l # 列出 Ansible 支持的模块 ansible-doc ping # 查看该模块帮助信息 二.远程命令模块 2.1command com ...
- DVWA之Brute Force(暴力破解)
目录 Low Medium High Impossible 暴力破解是指使用穷举法,举出所有的可能的结果,然后逐一验证是否正确! Low 源代码: <?php if( isset( $_GET[ ...
- CVE-2010-3333:Microsoft RTF 栈溢出漏洞调试分析
0x01 前言 CVE-2010-3333 漏洞是一个栈溢出漏洞,该漏洞是由于 Microsoft文档在处理 RTF 数据的对数据解析处理错误,在进行内存操作时没有对操作的数据进行长度限制,导致存在内 ...