
【Scrapy(四)】scrapy 分页爬取以及xapth使用小技巧
scrapy 分页爬取以及xapth使用小技巧
这里以爬取www.javaquan.com为例:
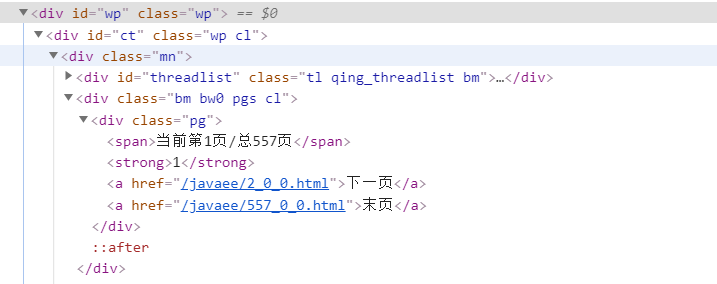
1.构建出下一页的url:
很显然通过dom树,可以发现下一页所在的a标签
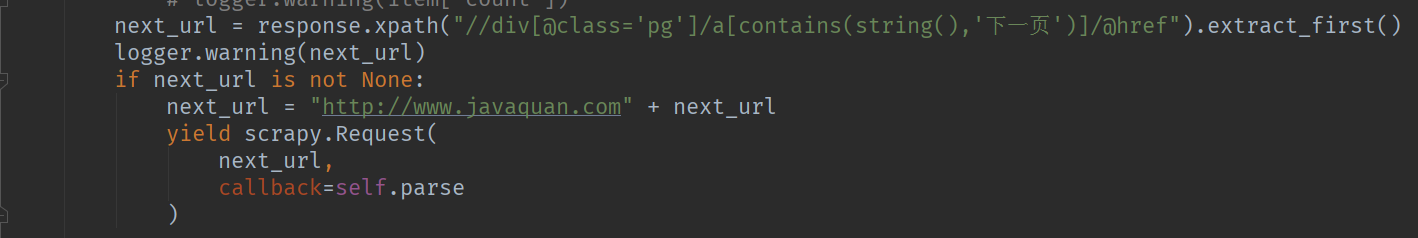
2.使用scrapy的yield scrapy.Reqeust(next_url,callback=self.parse) 构造下一页爬取的请求
Tips:使用xpath解析dom的常用处理方法:
1.查询页面上所有的div元素 : //div
2.查询页面上指定的元素 :
-通过class属性定位 例如: div[@class='xxxx']
-通过其他属性去定位 例如 div[@size='xxxxx']
-通过元素包含的文本去定位 例如: a[contains(string(),'下一页')]
3.获取标签中的文本: 例如: /a/text() 获取a标签中得到文本
4.获取标签中的属性值: 例如/a/@href
5.extract_first() 与 extract() 区别
extract_first() 解析标签的值,取第一个
extract() 解析标签的值,取所有值
6.url返回的dom结构,可能与页面显示的dom结构不一致,chrome调试时需要注意,例如tbody的问题
7.获取某个标签下的所有子标签可以使用列表 例如 response.xpath("//tbody[@id='normalthread_14']/tr")[0:-1]
【Scrapy(四)】scrapy 分页爬取以及xapth使用小技巧的更多相关文章
- 基于scrapy框架输入关键字爬取有关贴吧帖子
基于scrapy框架输入关键字爬取有关贴吧帖子 站点分析 首先进入一个贴吧,要想达到输入关键词爬取爬取指定贴吧,必然需要利用搜索引擎 点进看到有四种搜索方式,分别试一次,观察url变化 我们得知: 搜 ...
- Scrapy爬虫框架之爬取校花网图片
Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓取 )所设 ...
- scrapy之360图片爬取
#今日目标 **scrapy之360图片爬取** 今天要爬取的是360美女图片,首先分析页面得知网页是动态加载,故需要先找到网页链接规律, 然后调用ImagesPipeline类实现图片爬取 *代码实 ...
- 如何分页爬取数据--beautisoup
'''本次爬取讲历史网站'''#!usr/bin/env python#-*- coding:utf-8 _*-"""@author:Hurrican@file: 分页爬 ...
- 爬虫(十七):Scrapy框架(四) 对接selenium爬取京东商品数据
1. Scrapy对接Selenium Scrapy抓取页面的方式和requests库类似,都是直接模拟HTTP请求,而Scrapy也不能抓取JavaScript动态谊染的页面.在前面的博客中抓取Ja ...
- scrapy 的分页爬取 CrawlSpider
1.创建scrapy工程:scrapy startproject projectName 2.创建爬虫文件:scrapy genspider -t crawl spiderName www.xxx.c ...
- 爬虫系列---scrapy全栈数据爬取框架(Crawlspider)
一 简介 crawlspider 是Spider的一个子类,除了继承spider的功能特性外,还派生了自己更加强大的功能. LinkExtractors链接提取器,Rule规则解析器. 二 强大的链接 ...
- Scrapy-redis改造scrapy实现分布式多进程爬取
一.基本原理: Scrapy-Redis则是一个基于Redis的Scrapy分布式组件.它利用Redis对用于爬取的请求(Requests)进行存储和调度(Schedule),并对爬取产生的项目(it ...
- Scrapy中用xpath/css爬取豆瓣电影Top250:解决403HTTP status code is not handled or not allowed
好吧,我又开始折腾豆瓣电影top250了,只是想试试各种方法,看看哪一种的方法效率是最好的,一直进行到这一步才知道 scrapy的强大,尤其是和selector结合之后,速度飞起.... 下面我就采用 ...
随机推荐
- PUToast - 使用PopupWindow在Presentation上模拟Toast
PUToast Android10 (API 29) 之前 Toast 组件默认只能展示在主 Display 上,PUToast 通过构造一个 PopupWindoww 在 Presentation ...
- TestLink测试用例管理工具使用说明
TestLink使用说明 打开网页,登录账号:(这里的账号是已经注册过的,并且拥有admin权限,可以创建用户.当然也可以通过点击登录页面的"新用户注册"按钮进行注册,但是权限是g ...
- ijkplayer接入使用
1.ijkplayer简介 ijkplayer是一个基于FFmpeg的轻量级Android/iOS视频播放器.FFmpeg的是全球领先的多媒体框架,能够解码,编码, 转码,复用,解复用,流,过滤器和播 ...
- 读 Kafka 源码写优雅业务代码:配置类
这个 Kafka 的专题,我会从系统整体架构,设计到代码落地.和大家一起杠源码,学技巧,涨知识.希望大家持续关注一起见证成长! 我相信:技术的道路,十年如一日!十年磨一剑! 往期文章 Kafka 探险 ...
- GTID介绍
从MySQL5.6开始增加GTID这个特性,Global Transaction ID,全局事务ID,用来强化主从数据库的一致性,故障恢复,以及容错能力,来替代传统的人工的主从复制: 有了GTID,在 ...
- Java面向对象(一些问题)
2. Java 面向对象 2.1. 类和对象 2.1.1. 面向对象和面向过程的区别 面向过程 :面向过程性能比面向对象高. 因为类调用时需要实例化,开销比较大,比较消耗资源,所以当性能是最重要的考量 ...
- 远程文件管理系统(SpringBoot + Vue)
一.简介 可以实现对本地文件的 增.删.改.重命名等操作的监控,通过登录远程文件监控系统,获取一段时间内本地文件的变化情况. 系统功能图如下: 流程图如下: 二.本地文件监控程序的实现(C++) 调用 ...
- golang 三维向量相关操作
package vector import ( "math" "fmt" )// 三维向量:(x,y,z) type Vector3 struct { X fl ...
- Go语言中利用append巧妙的删除slice切片中的元素
package main import ( "fmt" ) //删除函数 func remove(s []string, i int) []string { return appe ...
- Elasticsearch中最重要的文档CRUD要牢记
Elasticsearch文档CRUD要牢记 转载参考:https://juejin.im/post/5ddbf298e51d4523053c42e7 在Elasticsearch中,文档(docum ...