
Apache Hudi集成Spark SQL抢先体验
Apache Hudi集成Spark SQL抢先体验
1. 摘要
社区小伙伴一直期待的Hudi整合Spark SQL的PR正在积极Review中并已经快接近尾声,Hudi集成Spark SQL预计会在下个版本正式发布,在集成Spark SQL后,会极大方便用户对Hudi表的DDL/DML操作,下面就来看看如何使用Spark SQL操作Hudi表。
2. 环境准备
首先需要将PR拉取到本地打包,生成SPARK_BUNDLE_JAR(hudi-spark-bundle_2.11-0.9.0-SNAPSHOT.jar)包
2.1 启动spark-sql
在配置完spark环境后可通过如下命令启动spark-sql
spark-sql --jars $PATH_TO_SPARK_BUNDLE_JAR --conf 'spark.serializer=org.apache.spark.serializer.KryoSerializer' --conf 'spark.sql.extensions=org.apache.spark.sql.hudi.HoodieSparkSessionExtension'
2.2 设置并发度
由于Hudi默认upsert/insert/delete的并发度是1500,对于演示的小规模数据集可设置更小的并发度。
set hoodie.upsert.shuffle.parallelism = 1;

set hoodie.insert.shuffle.parallelism = 1;

set hoodie.delete.shuffle.parallelism = 1;
同时设置不同步Hudi表元数据
set hoodie.datasource.meta.sync.enable=false;
3. Create Table
使用如下SQL创建表
create table test_hudi_table (

  id int,

  name string,

  price double,

  ts long,

  dt string

) using hudi

 partitioned by (dt)

 options (

  primaryKey = 'id',

  type = 'mor'

 )

 location 'file:///tmp/test_hudi_table'
说明:表类型为MOR,主键为id,分区字段为dt,合并字段默认为ts。
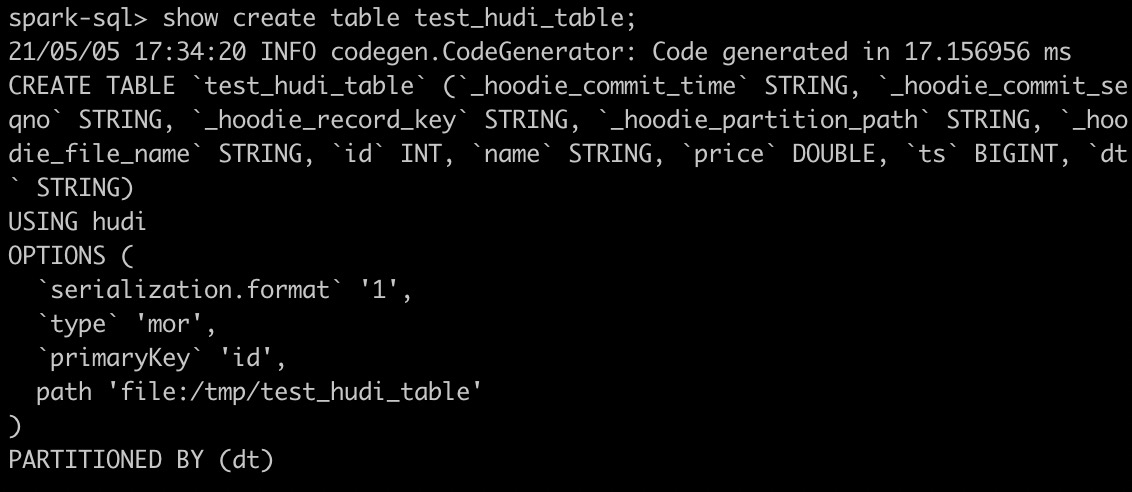
创建Hudi表后查看创建的Hudi表
show create table test_hudi_table
4. Insert Into
4.1 Insert
使用如下SQL插入一条记录
insert into test_hudi_table select 1 as id, 'hudi' as name, 10 as price, 1000 as ts, '2021-05-05' as dt
insert完成后查看Hudi表本地目录结构,生成的元数据、分区和数据与Spark Datasource写入均相同。

4.2 Select
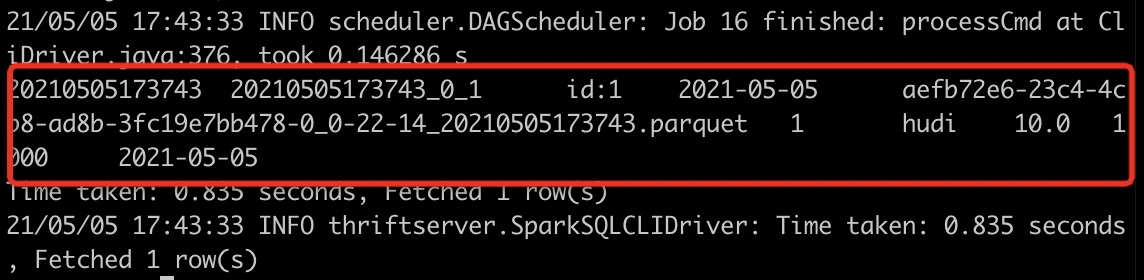
使用如下SQL查询Hudi表数据
select * from test_hudi_table
查询结果如下
5. Update
5.1 Update
使用如下SQL将id为1的price字段值变更为20
update test_hudi_table set price = 20.0 where id = 1
5.2 Select
再次查询Hudi表数据
select * from test_hudi_table
查询结果如下,可以看到price已经变成了20.0

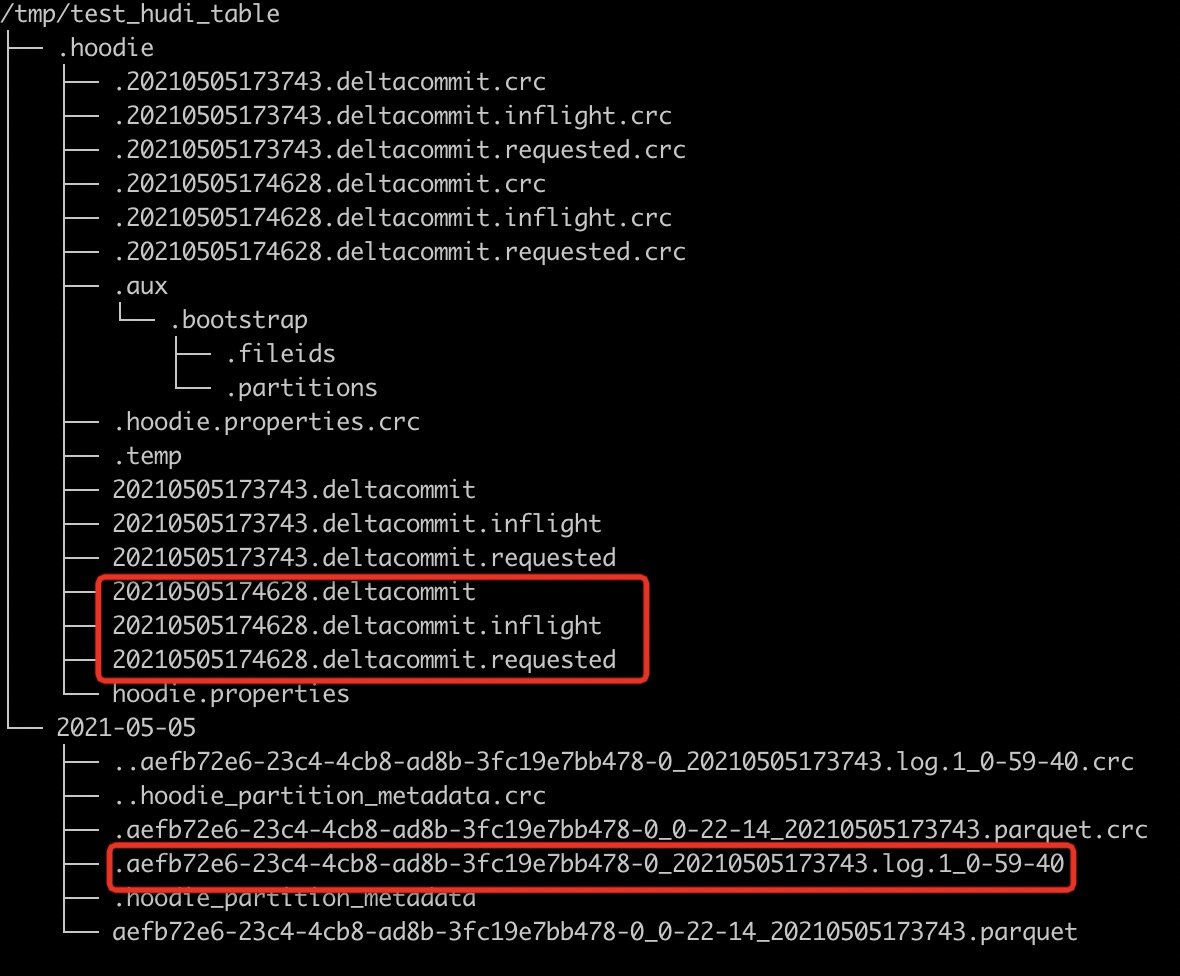
查看Hudi表的本地目录结构如下,可以看到在update之后又生成了一个deltacommit,同时生成了一个增量log文件。
6. Delete
6.1 Delete
使用如下SQL将id=1的记录删除
delete from test_hudi_table where id = 1
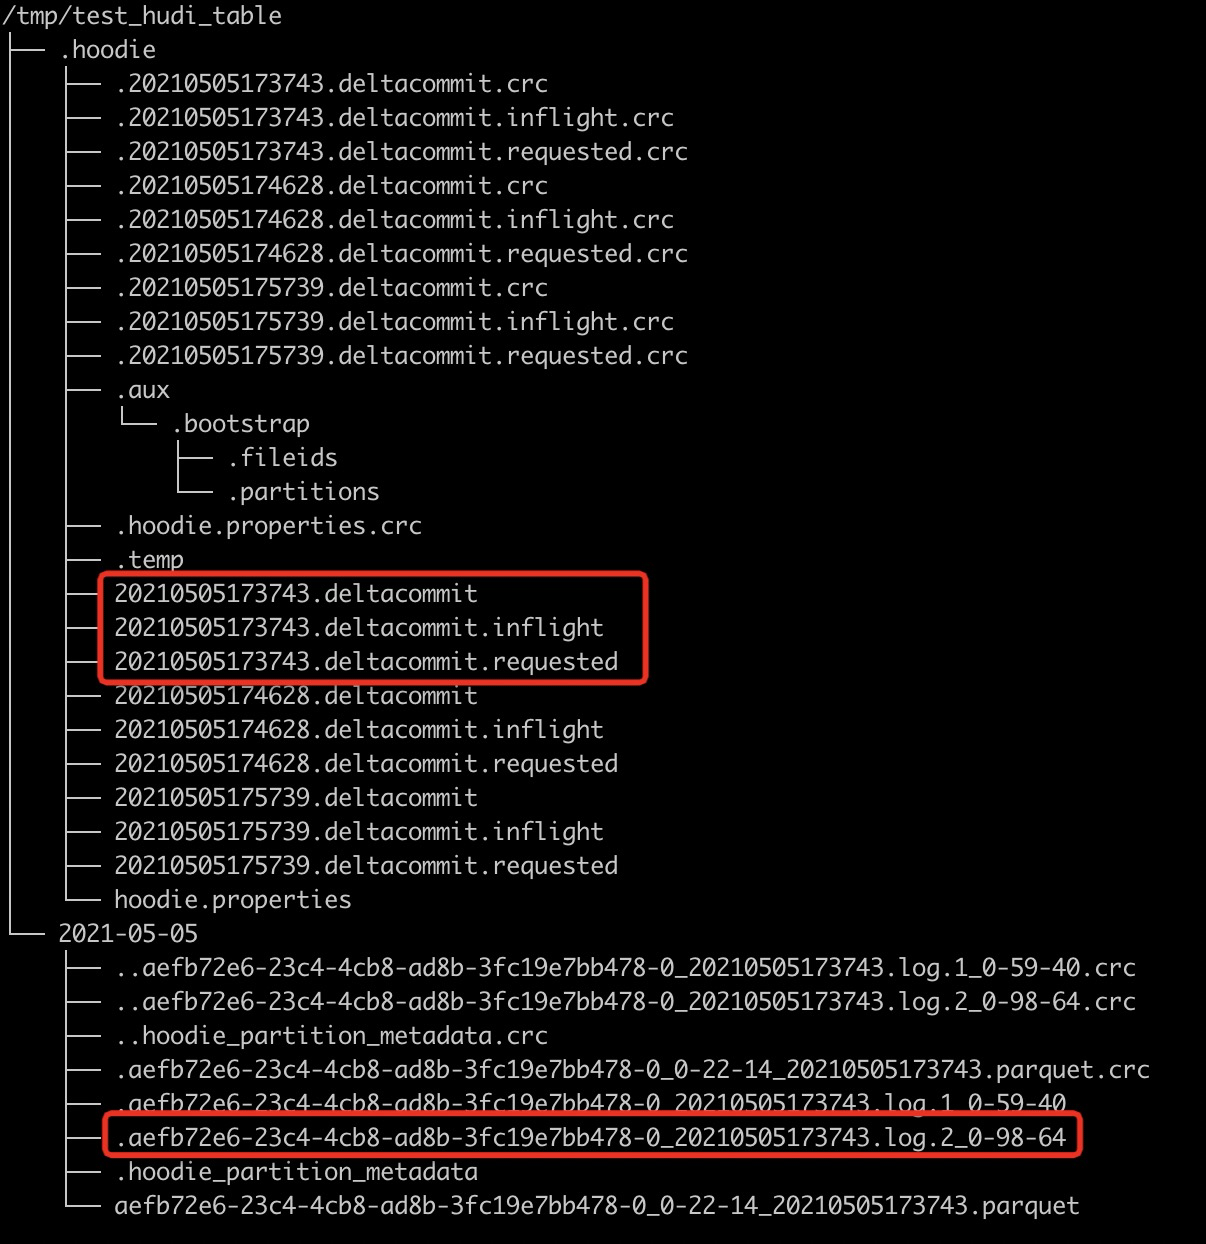
查看Hudi表的本地目录结构如下,可以看到delete之后又生成了一个deltacommit,同时生成了一个增量log文件。
6.2 Select
再次查询Hudi表
select * from test_hudi_table;
查询结果如下,可以看到已经查询不到任何数据了,表明Hudi表中已经不存在任何记录了。

7. Merge Into
7.1 Merge Into Insert
使用如下SQL向test_hudi_table插入数据
 merge into test_hudi_table as t0

 using (

  select 1 as id, 'a1' as name, 10 as price, 1000 as ts, '2021-03-21' as dt

 ) as s0

 on t0.id = s0.id

 when not matched and s0.id % 2 = 1 then insert *
7.2 Select
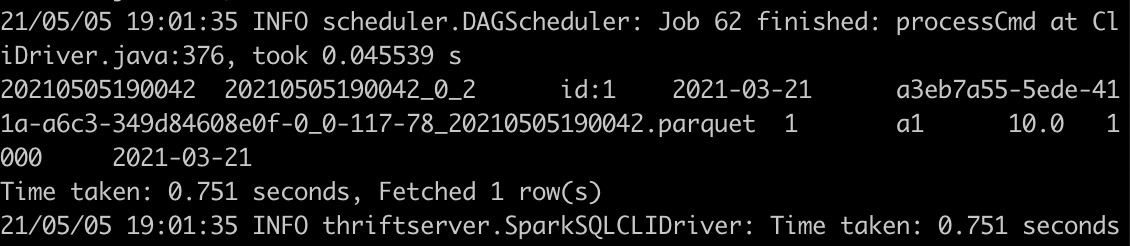
查询Hudi表数据
select * from test_hudi_table
查询结果如下,可以看到Hudi表中存在一条记录
7.4 Merge Into Update
使用如下SQL更新数据
 merge into test_hudi_table as t0

 using (

  select 1 as id, 'a1' as name, 12 as price, 1001 as ts, '2021-03-21' as dt

 ) as s0

 on t0.id = s0.id

 when matched and s0.id % 2 = 1 then update set *
7.5 Select
查询Hudi表
select * from test_hudi_table
查询结果如下,可以看到Hudi表中的分区已经更新了

7.6 Merge Into Delete
使用如下SQL删除数据
merge into test_hudi_table t0

 using (

  select 1 as s_id, 'a2' as s_name, 15 as s_price, 1001 as s_ts, '2021-03-21' as dt

 ) s0

 on t0.id = s0.s_id

 when matched and s_ts = 1001 then delete
查询结果如下,可以看到Hudi表中已经没有数据了

8. 删除表
使用如下命令删除Hudi表
drop table test_hudi_table;
使用show tables查看表是否存在
show tables;
可以看到已经没有表了

9. 总结
通过上面示例简单展示了通过Spark SQL Insert/Update/Delete Hudi表数据,通过SQL方式可以非常方便地操作Hudi表,降低了使用Hudi的门槛。另外Hudi集成Spark SQL工作将继续完善语法,尽量对标Snowflake和BigQuery的语法,如插入多张表(INSERT ALL WHEN condition1 INTO t1 WHEN condition2 into t2),变更Schema以及CALL Cleaner、CALL Clustering等Hudi表服务。
Apache Hudi集成Spark SQL抢先体验的更多相关文章
- Apache Hudi集成Apache Zeppelin实战
1. 简介 Apache Zeppelin 是一个提供交互数据分析且基于Web的笔记本.方便你做出可数据驱动的.可交互且可协作的精美文档,并且支持多种语言,包括 Scala(使用 Apache Spa ...
- 生态 | Apache Hudi集成Alluxio实践
原文链接:https://mp.weixin.qq.com/s/sT2-KK23tvPY2oziEH11Kw 1. 什么是Alluxio Alluxio为数据驱动型应用和存储系统构建了桥梁, 将数据从 ...
- Spark源码系列(九)Spark SQL初体验之解析过程详解
好久没更新博客了,之前学了一些R语言和机器学习的内容,做了一些笔记,之后也会放到博客上面来给大家共享.一个月前就打算更新Spark Sql的内容了,因为一些别的事情耽误了,今天就简单写点,Spark1 ...
- 重磅!Vertica集成Apache Hudi指南
1. 摘要 本文演示了使用外部表集成 Vertica 和 Apache Hudi. 在演示中我们使用 Spark 上的 Apache Hudi 将数据摄取到 S3 中,并使用 Vertica 外部表访 ...
- 恭喜!Apache Hudi社区新晋多位Committer
1. 介绍 经过Apache Hudi项目委员会讨论及投票,向Udit Mehrotra.Gary Li.Raymond Xu.Pratyaksh Sharma 4人发出Committer邀请,4人均 ...
- 详解 Apache Hudi Schema Evolution(模式演进)
Schema Evolution(模式演进)允许用户轻松更改 Hudi 表的当前模式,以适应随时间变化的数据. 从 0.11.0 版本开始,支持 Spark SQL(spark3.1.x 和 spar ...
- 使用 Apache Hudi 实现 SCD-2(渐变维度)
数据是当今分析世界的宝贵资产. 在向最终用户提供数据时,跟踪数据在一段时间内的变化非常重要. 渐变维度 (SCD) 是随时间推移存储和管理当前和历史数据的维度. 在 SCD 的类型中,我们将特别关注类 ...
- Spark SQL 之 Migration Guide
Spark SQL 之 Migration Guide 支持的Hive功能 转载请注明出处:http://www.cnblogs.com/BYRans/ Migration Guide 与Hive的兼 ...
- Spark SQL 官方文档-中文翻译
Spark SQL 官方文档-中文翻译 Spark版本:Spark 1.5.2 转载请注明出处:http://www.cnblogs.com/BYRans/ 1 概述(Overview) 2 Data ...
随机推荐
- MongoDB数据库的使用
MongoDB是一个基于分布式 文件存储的NoSQL数据库,适合存储JSON风格文件的形式. 三元素:数据库.集合和文档. 文档:对应着关系数据库中的行,就是一个对象,由键值对构成,是json的扩展B ...
- canvas绘制图像轮廓效果
在2d图形可视化开发中,经常要绘制对象的选中效果. 一般来说,表达对象选中可以使用边框,轮廓或者发光的效果. 发光的效果,可以使用canvas的阴影功能,比较容易实现,此处不在赘述. 绘制边框 绘制 ...
- Android 学习之活动的生命周期
•返回栈 Android 中的活动是可以叠层的: 我们每启动一个新的活动,就会覆盖在原活动之上: 然后点击 Back 键会销毁最上面的活动,下面一个活动就会重新显示出来: 其实 Android 是使用 ...
- 【JVM进阶之路】八:性能监控工具-命令行篇
定位问题的时候,知识.经验是关键基础,数据是依据,工具是运用知识处理数据的手段. 在实际的故障排查.性能监控中,常常是操作系统的工具和Java虚拟机的工具结合使用. 1.操作系统工具 1.1.top: ...
- PAT (Advanced Level) Practice 1031 Hello World for U (20 分) 凌宸1642
PAT (Advanced Level) Practice 1031 Hello World for U (20 分) 凌宸1642 题目描述: Given any string of N (≥5) ...
- Elasticsearch 集群优化-尽可能全面详细
Elasticsearch 集群优化-转载参考1 基本配置 基本配置,5台配置为 24C 125G 17T 的主机,每台主机上搭建了一个elasticsearch节点. 采用的elasticsearc ...
- rancher的ssl部署
前言 因为我司有多套k8s环境,管理起来过于麻烦,需要一个统一的管理平台,又因为没有预留时间自己开发,经过选择后,使用rancher来进行多k8s环境的统一管理平台. 部署 1.在阿里云上申请免费的证 ...
- AutoAssign源码分析
目录 AutoAssign源码分析 一. 简介 二. 论文理论 2.1 联合表示 2.2 正样本权重 2.3 负样本权重 2.4 总的loss 2.5 补充loss 三. 论文代码 四. 总结 五. ...
- (Collection, List, 泛型)JAVA集合框架一
Java集合框架部分细节总结一 Collection List 有序,有下标,元素可重复 Set 无序,无下标,元素不可重复 以上为Collection接口 以ArrayList为实现类实现遍历:增强 ...
- 如何建立一个足够安全的SSH连接?
1 概述 使用SSH连接服务器是一件很平常的事,但是,连接是否足够安全是一个令人担忧的问题.本文从如下几个方面介绍了如何建立一个足够安全的SSH连接: 端口 协议 用户 密码 密钥对 ssh-agen ...