
Apache Hudi集成Apache Zeppelin实战
1. 简介
Apache Zeppelin 是一个提供交互数据分析且基于Web的笔记本。方便你做出可数据驱动的、可交互且可协作的精美文档,并且支持多种语言,包括 Scala(使用 Apache Spark)、Python(Apache Spark)、SparkSQL、 Hive、 Markdown、Shell等等。当前Hive与SparkSQL已经支持查询Hudi的读优化视图和实时视图。所以理论上Zeppelin的notebook也应当拥有这样的查询能力。
2.实现效果
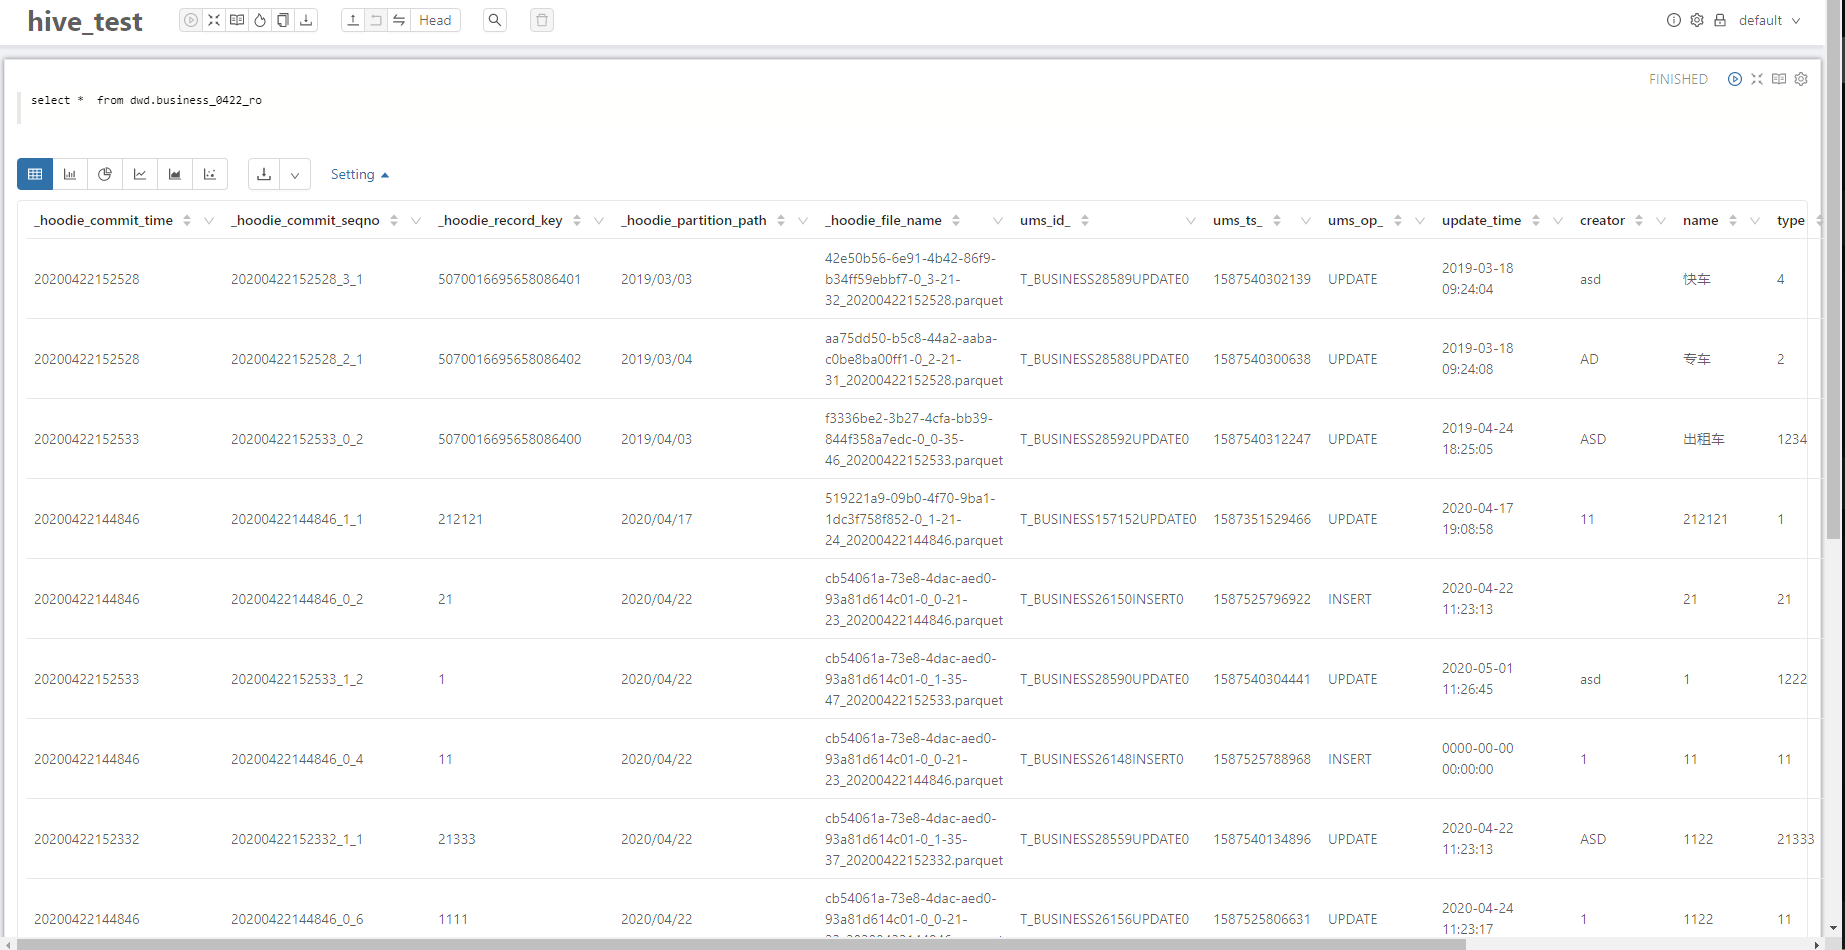
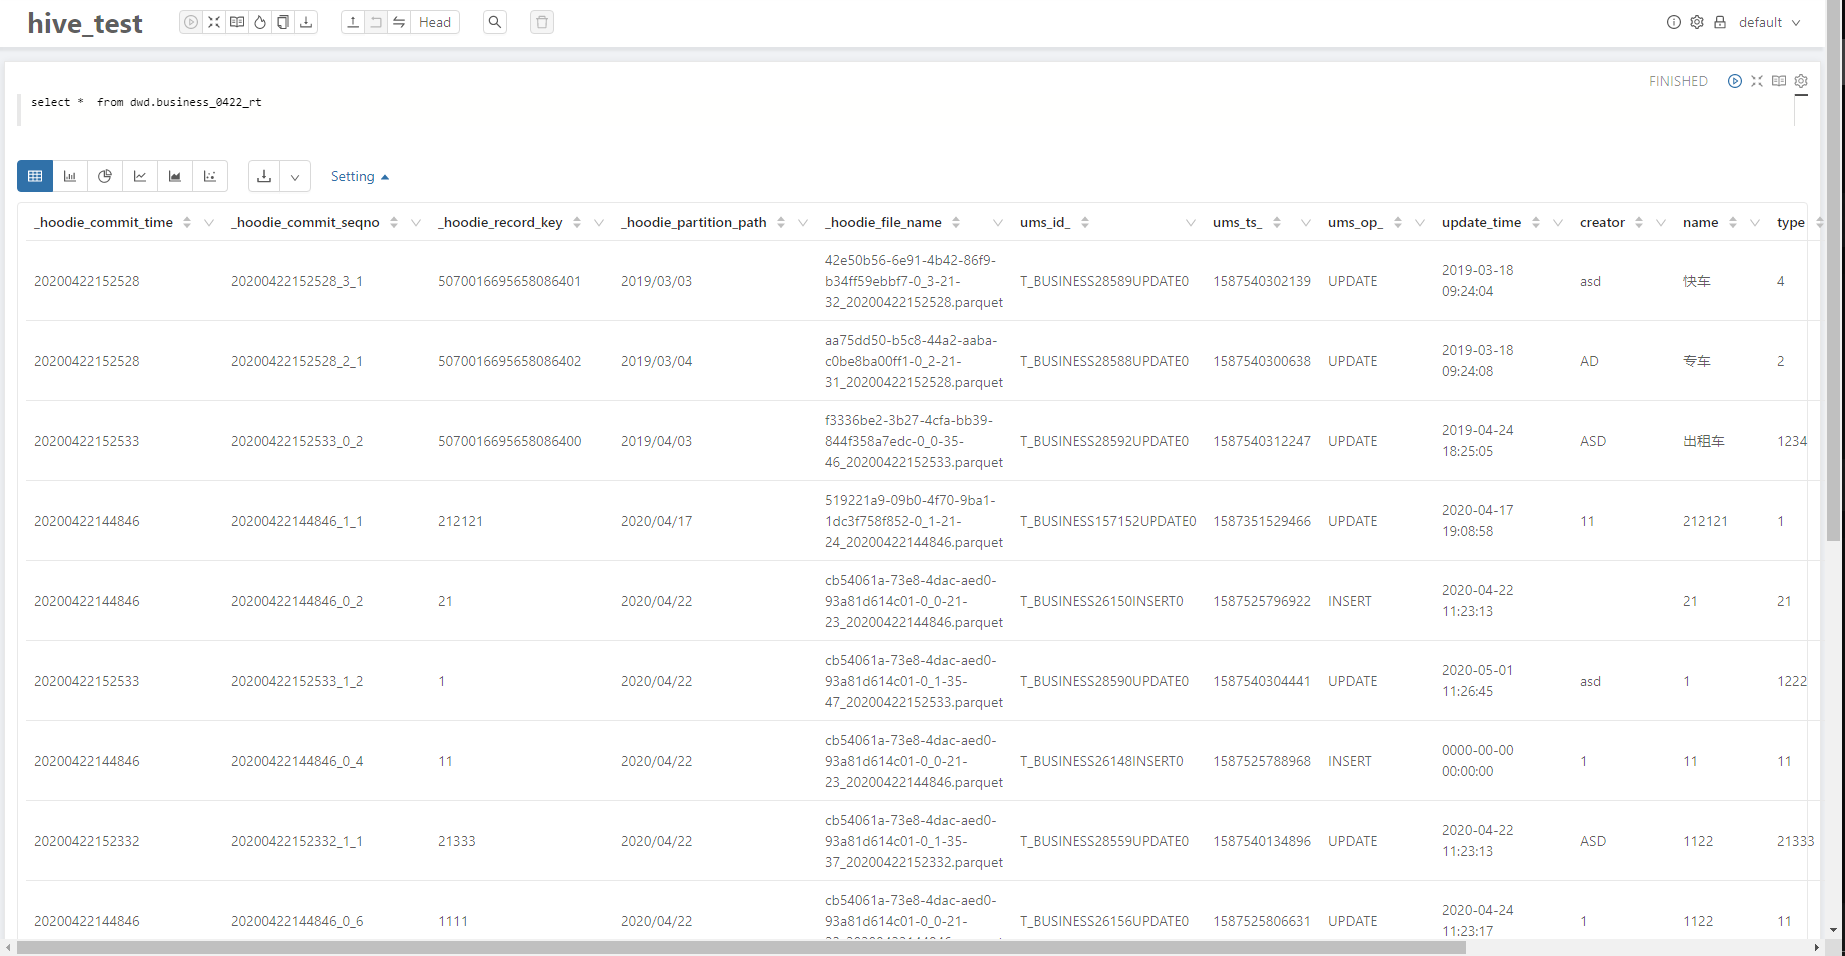
2.1 Hive
2.1.1 读优化视图
2.1.2 实时视图
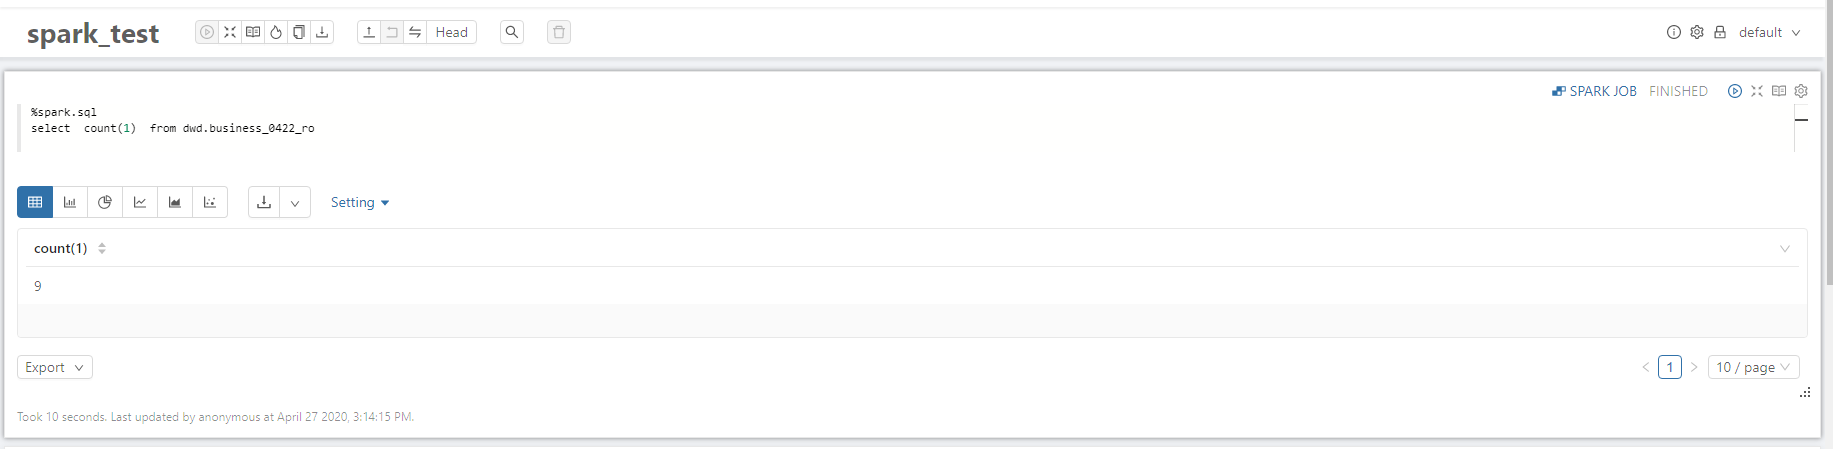
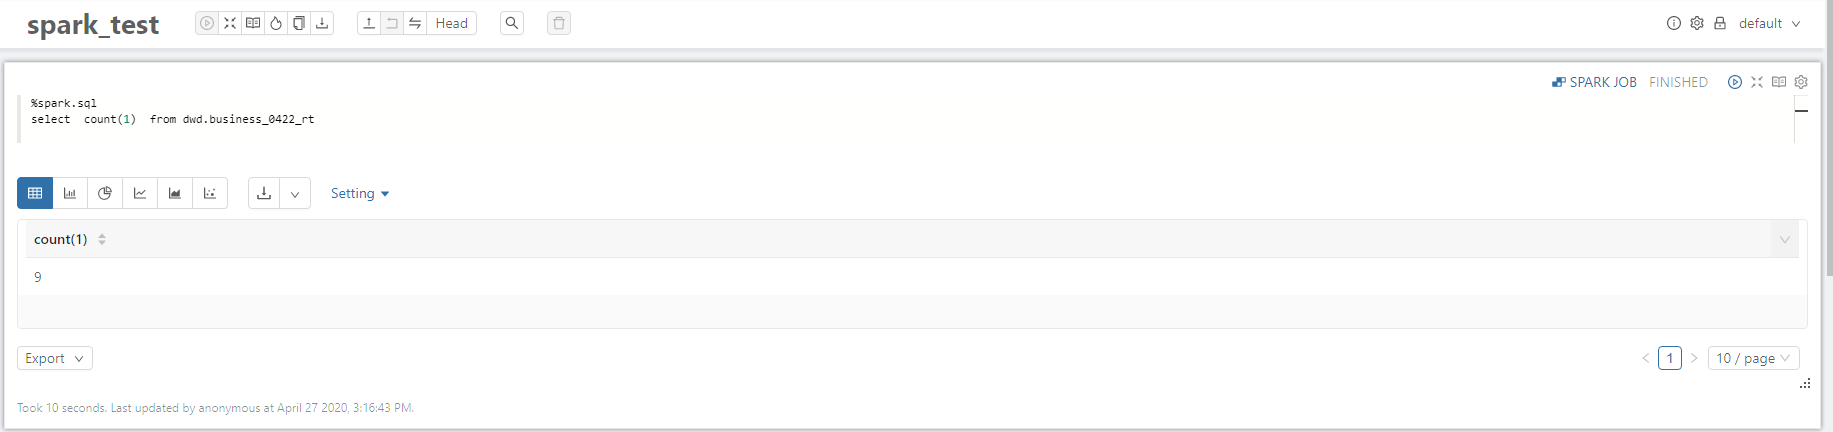
2.2 Spark SQL
2.2.1 读优化视图
2.2.2 实时视图
3.常见问题整理
3.1 Hudi包适配
cp hudi-hadoop-mr-bundle-0.5.2-SNAPSHOT.jar    zeppelin/lib

cp hudi-hive-bundle-0.5.2-SNAPSHOT.jar         zeppelin/lib

cp hudi-spark-bundle_2.11-0.5.2-SNAPSHOT.jar   zeppelin/lib
Zeppelin启动时会默认加载lib下的包,对于Hudi这类外部依赖,适合直接放在zeppelin/lib下以避免 Hive或Spark SQL在集群上找不到对应Hudi依赖。
3. 2 parquet jar包适配
Hudi包的parquet版本为1.10,当前CDH集群parquet版本为1.9,所以在执行Hudi表查询时,会报很多jar包冲突的错。
解决方法:在zepeelin所在节点的spark/jars目录下将parquet包升级成1.10。
副作用:zeppelin 以外的saprk job 分配到 parquet 1.10的集群节点的任务可能会失败。
建议:zeppelin 以外的客户端也会有jar包冲突的问题。所以建议将集群的spark jar 、parquet jar以及相关依赖的jar做全面升级,更好地适配Hudi的能力。
3.3 Spark Interpreter适配
相同sql在Zeppelin上使用Spark SQL查询会出现比hive查询记录条数多的现象。
问题原因:当向Hive metastore中读写Parquet表时,Spark SQL默认将使用Spark SQL自带的Parquet SerDe(SerDe:Serialize/Deserilize的简称,目的是用于序列化和反序列化),而不是用Hive的SerDe,因为Spark SQL自带的SerDe拥有更好的性能。
这样导致了Spark SQL只会查询Hudi的流水记录,而不是最终的合并结果。
解决方法:set spark.sql.hive.convertMetastoreParquet=false
方法一:直接在页面编辑属性

方法二:编辑 zeppelin/conf/interpreter.json添加
interpreter
"spark.sql.hive.convertMetastoreParquet": {

          "name": "spark.sql.hive.convertMetastoreParquet",

          "value": false,

          "type": "checkbox"

        },
4. Hudi增量视图
对于Hudi增量视图,目前只支持通过写Spark 代码的形式拉取。考虑到Zeppelin在notebook上有直接执行代码和shell 命令的能力,后面考虑封装这些notebook,以支持sql的方式查询Hudi增量视图。
Apache Hudi集成Apache Zeppelin实战的更多相关文章
- Apache Hudi集成Spark SQL抢先体验
Apache Hudi集成Spark SQL抢先体验 1. 摘要 社区小伙伴一直期待的Hudi整合Spark SQL的PR正在积极Review中并已经快接近尾声,Hudi集成Spark SQL预计会在 ...
- Apache Hudi与Apache Flink集成
感谢王祥虎@wangxianghu 投稿 Apache Hudi是由Uber开发并开源的数据湖框架,它于2019年1月进入Apache孵化器孵化,次年5月份顺利毕业晋升为Apache顶级项目.是当前最 ...
- 生态 | Apache Hudi集成Alluxio实践
原文链接:https://mp.weixin.qq.com/s/sT2-KK23tvPY2oziEH11Kw 1. 什么是Alluxio Alluxio为数据驱动型应用和存储系统构建了桥梁, 将数据从 ...
- Apache Hudi + AWS S3 + Athena实战
Apache Hudi在阿里巴巴集团.EMIS Health,LinkNovate,Tathastu.AI,腾讯,Uber内使用,并且由Amazon AWS EMR和Google云平台支持,最近Ama ...
- 重磅!Vertica集成Apache Hudi指南
1. 摘要 本文演示了使用外部表集成 Vertica 和 Apache Hudi. 在演示中我们使用 Spark 上的 Apache Hudi 将数据摄取到 S3 中,并使用 Vertica 外部表访 ...
- 基于 Apache Hudi 和DBT 构建开放的Lakehouse
本博客的重点展示如何利用增量数据处理和执行字段级更新来构建一个开放式 Lakehouse. 我们很高兴地宣布,用户现在可以使用 Apache Hudi + dbt 来构建开放Lakehouse. 在深 ...
- Apache Hudi重磅特性解读之存量表高效迁移机制
1. 摘要 随着Apache Hudi变得越来越流行,一个挑战就是用户如何将存量的历史表迁移到Apache Hudi,Apache Hudi维护了记录级别的元数据以便提供upserts和增量拉取的核心 ...
- 恭喜!Apache Hudi社区新晋多位Committer
1. 介绍 经过Apache Hudi项目委员会讨论及投票,向Udit Mehrotra.Gary Li.Raymond Xu.Pratyaksh Sharma 4人发出Committer邀请,4人均 ...
- Apache Hudi助力nClouds加速数据交付
1. 概述 在nClouds上,当客户的业务决策取决于对近实时数据的访问时,客户通常会向我们寻求有关数据和分析平台的解决方案.但随着每天创建和收集的数据量都在增加,这使得使用传统技术进行数据分析成为一 ...
随机推荐
- 【强烈推荐】适合Flutter初学者的完整项目
简介 Flutter Fly是什么?Flutter Fly是一款开源的Flutter 项目,非常适合初学者进行学习.App内集成了160+Flutter基础控件的详细介绍及用法,内容来源于:http: ...
- -bash: syntax error near unexpected token `newline'问题解决
原因:bash语法错误,例如, 仔细查看发现语句中不能有'<'和'>',删除这两个符号即可: 问题解决!
- JavaScript 异步、栈、事件循环、任务队列
概览 我们经常会听到引擎和runtime,它们的区别是什么呢? 引擎:解释并编译代码,让它变成能交给机器运行的代码(runnable commands). runtime:就是运行环境,它提供一些对外 ...
- A 修公路
时间限制 : - MS 空间限制 : 65536 KB 评测说明 : 时限1000ms 问题描述 某岛国有n个小岛构成(编号1到n),该国政府想要通过n-1条双向公路将这些小岛连接起来,使得任意 ...
- js生成一个指定范围内的随机整数
function __random(start=0, end=1) { return Math.floor(Math.random() * (end - start + 1) + start); } ...
- 玩转控件:对Dev的GridControl控件扩展
缘由 一切实现来源于需求,目的在于不盲目造轮子,有小伙伴儿在看了<玩转控件:对Dev中GridControl控件的封装和扩展>文章后,私信作者说,因公司业务逻辑比较复杂,展示字段比较多,尤 ...
- Shell:homework
1.判断/etc/inittab文件是否大于100行,如果大于,则显示”/etc/inittab is a big file.”否则显示”/etc/inittab is a small file.”# ...
- php设计模式总结
#1 使用设计模式(如建造者.外观.原型和模板模式)更快速.更有效地创建对象 #2 使用数据访问对象和代理设计模式分离体系结构 #3 使用委托.工厂和单元素设计模式改善代码流和控制 #4 在不修改对象 ...
- Jmeter压力测试笔记(5)问题原因
压测链路是jmeter=>slb=>nginx => php=>rds 报 Too Many Connections 的原因是前端同时保持了 16000 个连接,达到实例规格的 ...
- 《操作系统》课程笔记(Ch01-导论)
Ch01 - 导论 操作系统的功能 用户视角:在乎使用方便,不在乎资源利用 系统视角:资源分配器.控制程序 计算机系统的运行 启动:利用固件(Firmware)中的引导程序(Bootstrap Pro ...