
064 SparkStream与kafka的集成,主要是编程
这里面包含了如何在kafka+sparkStreaming集成后的开发,也包含了一部分的优化。
一:说明
1.官网
指导网址:http://spark.apache.org/docs/1.6.1/streaming-kafka-integration.html
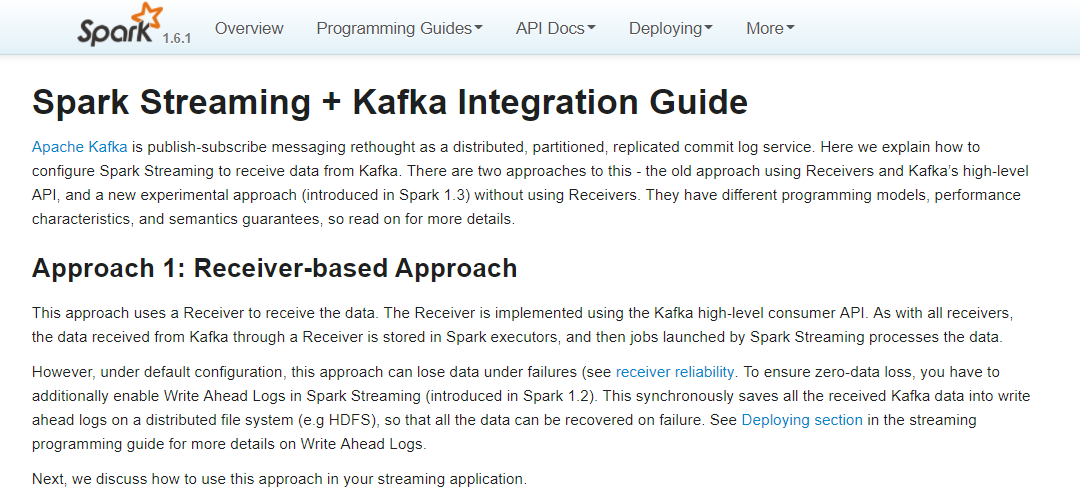
2.SparkStream+kafka
Use Receiver
内部使用kafka的high lenel consumer API
consumer offset 只能保持到zk/kafka中,只能通过配置进行offset的相关操作
Direct
内部使用的是kafka的simple consumer api
自定义对kafka的offset偏移量进行控制操作
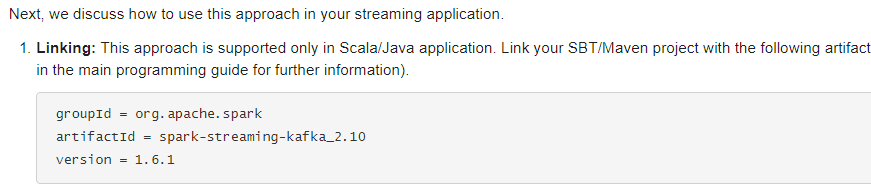
集成依赖pom配置:
二:单Receiver的程序
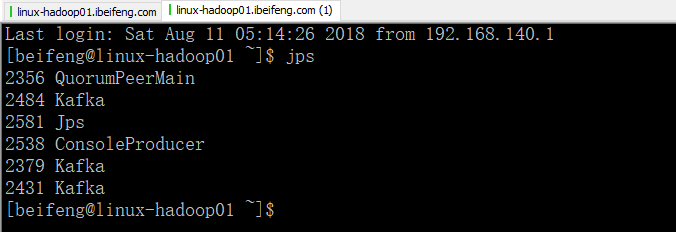
1.先启动服务
在这里需要启动kafka的生产者
2.程序
 package com.stream.it

 import kafka.serializer.StringDecoder

 import org.apache.spark.storage.StorageLevel

 import org.apache.spark.streaming.dstream.ReceiverInputDStream

 import org.apache.spark.streaming.kafka.KafkaUtils

 import org.apache.spark.streaming.{Seconds, StreamingContext}

 import org.apache.spark.{SparkConf, SparkContext}

 object KafkaWordcount {

   def main(args: Array[String]): Unit = {

     val conf=new SparkConf()

         .setAppName("spark-streaming-wordcount")

           .setMaster("local[*]")

     val sc=SparkContext.getOrCreate(conf)

     val ssc=new StreamingContext(sc,Seconds(15))

     /*

     def createStream[K: ClassTag, V: ClassTag, U <: Decoder[_]: ClassTag, T <: Decoder[_]: ClassTag](

       ssc: StreamingContext,

       kafkaParams: Map[String, String],

       topics: Map[String, Int],

       storageLevel: StorageLevel

     ): ReceiverInputDStream[(K, V)]

     */

     val kafkaParams=Map("group.id"->"stream-sparking-0",

           "zookeeper.connect"->"linux-hadoop01.ibeifeng.com:2181/kafka",

           "auto.offset.reset"->"smallest"

     )

     val topics=Map("beifeng"->1)

     val dStream=KafkaUtils.createStream[String,String,StringDecoder,StringDecoder](

       ssc,             //给定sparkStreaming的上下文

       kafkaParams,     //kafka的参数信息,通过kafka HightLevelComsumerApi连接

       topics,          //给定读取对应的topic的名称以及读取数据的线程数量

       StorageLevel.MEMORY_AND_DISK_2     //数据接收器接收到kafka的数据后的保存级别

     ).map(_._2)

     val resultWordcount=dStream

       .filter(line=>line.nonEmpty)

         .flatMap(line=>line.split(" ").map((_,1)))

         .reduceByKey(_+_)

     resultWordcount.foreachRDD(rdd=>{

       rdd.foreachPartition(iter=>iter.foreach(println))

     })

     //启动

     ssc.start()

     //等到

     ssc.awaitTermination()

   }

 }
3.效果
在kafka producer输入内容,将会在控制台上进行展示
三:多Receiver
1.说明
当当个reveiver接收的数据被限制的时候,可以使用多个receiver
2.程序
 package com.stream.it

 import kafka.serializer.StringDecoder

 import org.apache.spark.storage.StorageLevel

 import org.apache.spark.streaming.kafka.KafkaUtils

 import org.apache.spark.streaming.{Seconds, StreamingContext}

 import org.apache.spark.{SparkConf, SparkContext}

 object MulReceiverKafkaWordcount {

   def main(args: Array[String]): Unit = {

     val conf=new SparkConf()

         .setAppName("spark-streaming-wordcount2")

           .setMaster("local[*]")

     val sc=SparkContext.getOrCreate(conf)

     val ssc=new StreamingContext(sc,Seconds(15))

     /*

     def createStream[K: ClassTag, V: ClassTag, U <: Decoder[_]: ClassTag, T <: Decoder[_]: ClassTag](

       ssc: StreamingContext,

       kafkaParams: Map[String, String],

       topics: Map[String, Int],

       storageLevel: StorageLevel

     ): ReceiverInputDStream[(K, V)]

     */

     val kafkaParams=Map("group.id"->"stream-sparking-0",

           "zookeeper.connect"->"linux-hadoop01.ibeifeng.com:2181/kafka",

           "auto.offset.reset"->"smallest"

     )

     val topics=Map("beifeng"->4)

     val dStream1=KafkaUtils.createStream[String,String,StringDecoder,StringDecoder](

       ssc,             //给定sparkStreaming的上下文

       kafkaParams,     //kafka的参数信息,通过kafka HightLevelComsumerApi连接

       topics,          //给定读取对应的topic的名称以及读取数据的线程数量

       StorageLevel.MEMORY_AND_DISK_2     //数据接收器接收到kafka的数据后的保存级别

     ).map(_._2)

     val dStream2=KafkaUtils.createStream[String,String,StringDecoder,StringDecoder](

       ssc,             //给定sparkStreaming的上下文

       kafkaParams,     //kafka的参数信息,通过kafka HightLevelComsumerApi连接

       topics,          //给定读取对应的topic的名称以及读取数据的线程数量

       StorageLevel.MEMORY_AND_DISK_2     //数据接收器接收到kafka的数据后的保存级别

     ).map(_._2)

     //合并dstream

     val dStream=dStream1.union(dStream2)

     val resultWordcount=dStream

       .filter(line=>line.nonEmpty)

         .flatMap(line=>line.split(" ").map((_,1)))

         .reduceByKey(_+_)

     resultWordcount.foreachRDD(rdd=>{

       rdd.foreachPartition(iter=>iter.foreach(println))

     })

     //启动

     ssc.start()

     //等到

     ssc.awaitTermination()

   }

 }
3.效果
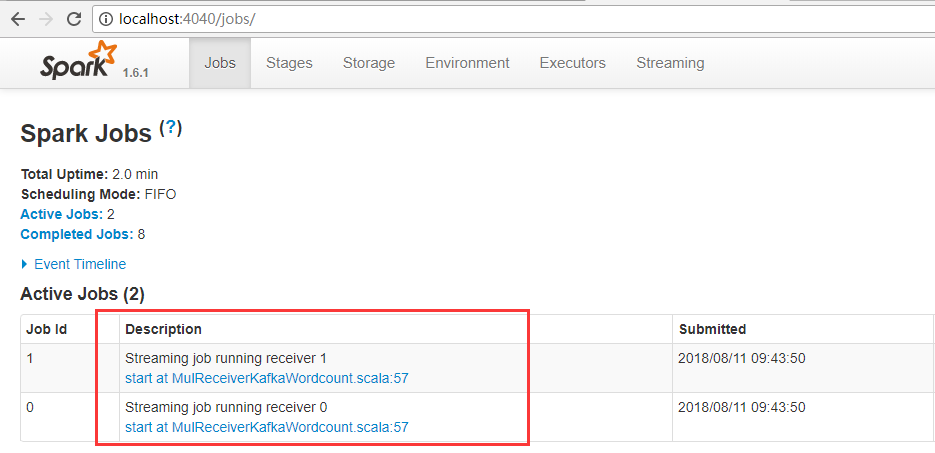
一条数据是一个event
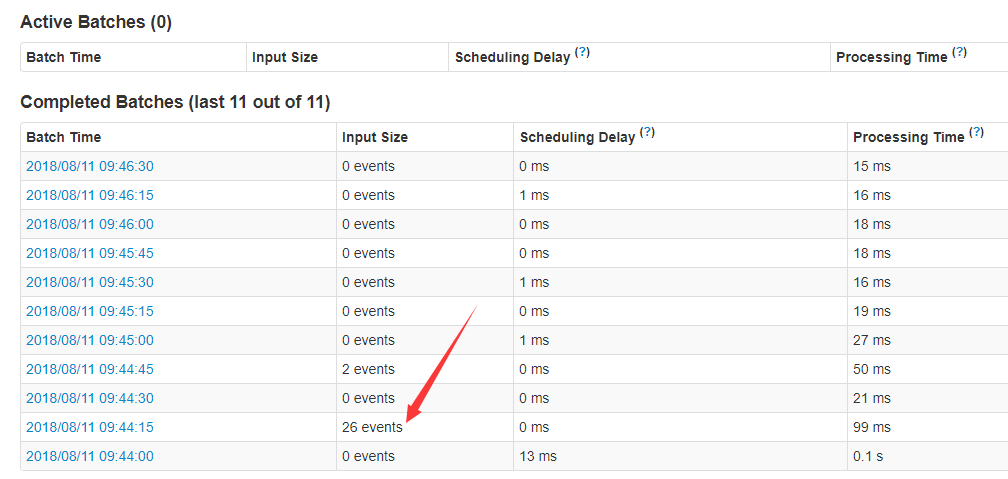
这里有两个receiver。
四:Direct
1.说明
直接读取,不存在receiver
不足,kafkaParams指定连接kafka的参数,内部使用的是kafka的SimpleConsumerAPI,所以,offset只能从头或者从尾开始读取,不能设置。
topics:topic的名称
2.程序
 package com.stream.it

 import kafka.serializer.StringDecoder

 import org.apache.spark.storage.StorageLevel

 import org.apache.spark.streaming.kafka.KafkaUtils

 import org.apache.spark.streaming.{Seconds, StreamingContext}

 import org.apache.spark.{SparkConf, SparkContext}

 object DirectKafkaWordcount {

   def main(args: Array[String]): Unit = {

     val conf=new SparkConf()

         .setAppName("spark-streaming-wordcount")

           .setMaster("local[*]")

     val sc=SparkContext.getOrCreate(conf)

     val ssc=new StreamingContext(sc,Seconds(15))

     val kafkaParams=Map(

           "metadata.broker.list"->"linux-hadoop01.ibeifeng.com:9092,linux-hadoop01.ibeifeng.com:9093,linux-hadoop01.ibeifeng.com:9094",

           "auto.offset.reset"->"smallest"

     )

     val topics=Set("beifeng")

     val dStream=KafkaUtils.createDirectStream[String,String,StringDecoder,StringDecoder](

       ssc,

       kafkaParams,

       topics).map(_._2)

     val resultWordcount=dStream

       .filter(line=>line.nonEmpty)

         .flatMap(line=>line.split(" ").map((_,1)))

         .reduceByKey(_+_)

     resultWordcount.foreachRDD(rdd=>{

       rdd.foreachPartition(iter=>iter.foreach(println))

     })

     //启动

     ssc.start()

     //等到

     ssc.awaitTermination()

   }

 }
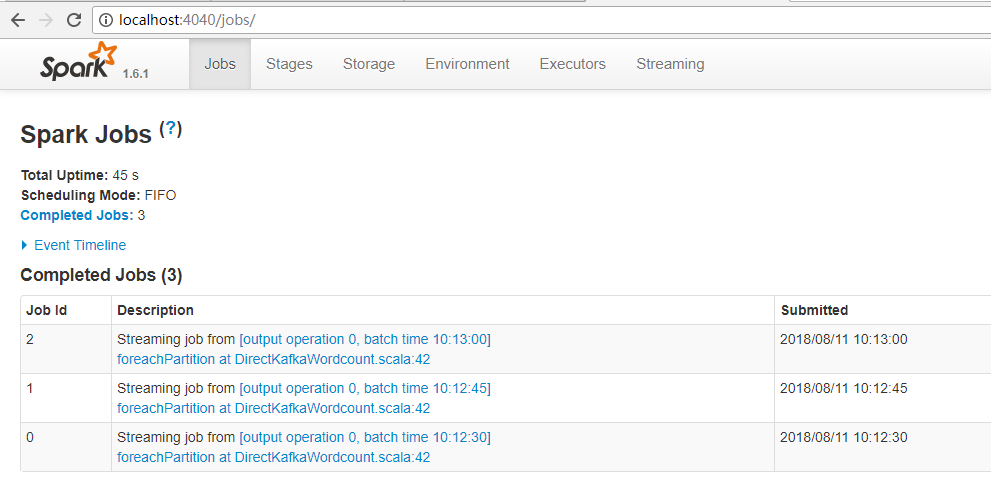
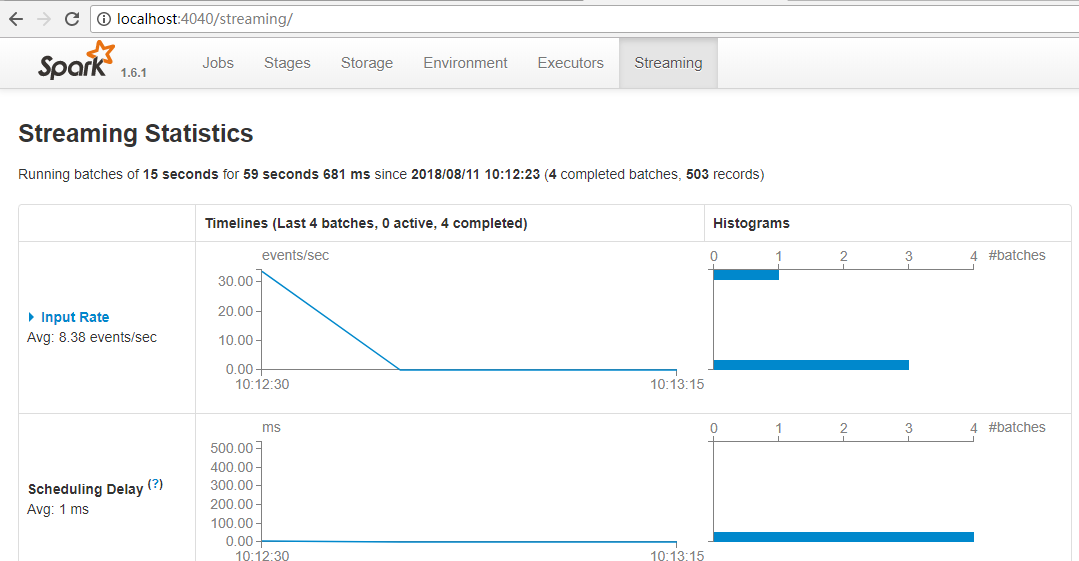
3.效果
没有receiver。
五:Direct实现是累加器管理offset偏移量
1.程序
kafkaParams 中只有这个参数下才能生效。
数据先进行保存或者打印,然后更新accumulable中的offset,然后下一批的dstream进行更新offset。
累加器需要在外面进行定义。
 package com.stream.it

 import scala.collection.mutable

 import kafka.common.TopicAndPartition

 import kafka.message.MessageAndMetadata

 import kafka.serializer.StringDecoder

 import org.apache.spark.storage.StorageLevel

 import org.apache.spark.streaming.kafka.KafkaUtils

 import org.apache.spark.streaming.{Seconds, StreamingContext}

 import org.apache.spark.{Accumulable, AccumulableParam, SparkConf, SparkContext}

 object AccumubaleKafkaWordcount {

   def main(args: Array[String]): Unit = {

     val conf=new SparkConf()

         .setAppName("spark-streaming-wordcount")

           .setMaster("local[*]")

     val sc=SparkContext.getOrCreate(conf)

     val ssc=new StreamingContext(sc,Seconds(15))

     val accumu = DroppedAccumulable.getInstance(sc)

     val kafkaParams = Map(

       "metadata.broker.list" -> "linux-hadoop01.ibeifeng.com:9092,linux-hadoop01.ibeifeng.com:9093,linux-hadoop01.ibeifeng.com:9094,linux-hadoop01.ibeifeng.com:9095"

     )

     // TODO: 从某一个存储offset的地方读取offset偏移量数据, redis\hbase\其他地方.....

     val fromOffsets = Map(

       TopicAndPartition("beifeng", 0) -> -1L, // 如果这里给定的偏移量是异常的,会直接从kafka中读取偏移量数据(largest)

       TopicAndPartition("beifeng", 1) -> 0L,

       TopicAndPartition("beifeng", 2) -> 0L,

       TopicAndPartition("beifeng", 3) -> 0L

     )

     val dstream = KafkaUtils.createDirectStream[String, String, kafka.serializer.StringDecoder, kafka.serializer.StringDecoder, String](

       ssc, // 上下文

       kafkaParams, // kafka连接

       fromOffsets,

       (message: MessageAndMetadata[String, String]) => {

         // 这一块在Executor上被执行

         // 更新偏移量offset

         val topic = message.topic

         val paritionID = message.partition

         val offset = message.offset

         accumu += (topic, paritionID) -> offset

         // 返回value的数据

         message.message()

       }

     )

     val resultWordCount = dstream

       .filter(line => line.nonEmpty)

       .flatMap(line => line.split(" ").map((_, 1)))

       .reduceByKey(_ + _)

     resultWordCount.foreachRDD(rdd => {

       // 在driver上执行

       try {

         rdd.foreachPartition(iter => {

           // 代码在executor上执行

           // TODO: 这里进行具体的数据保存操作

           iter.foreach(println)

         })

         // TODO: 在这里更新offset, 将数据写入到redis\hbase\其他地方.....

         accumu.value.foreach(println)

       } catch {

         case e: Exception => // nothings

       }

     })

     //启动

     ssc.start()

     //等到

     ssc.awaitTermination()

   }

 }

 object DroppedAccumulable {

   private var instance: Accumulable[mutable.Map[(String, Int), Long], ((String, Int), Long)] = null

   def getInstance(sc: SparkContext): Accumulable[mutable.Map[(String, Int), Long], ((String, Int), Long)] = {

     if (instance == null) {

       synchronized {

         if (instance == null) instance = sc.accumulable(mutable.Map[(String, Int), Long]())(param = new AccumulableParam[mutable.Map[(String, Int), Long], ((String, Int), Long)]() {

           /**

             * 将t添加到r中

             *

             * @param r

             * @param t

             * @return

             */

           override def addAccumulator(r: mutable.Map[(String, Int), Long], t: ((String, Int), Long)): mutable.Map[(String, Int), Long] = {

             val oldOffset = r.getOrElse(t._1, t._2)

             if (t._2 >= oldOffset) r += t

             else r

           }

           override def addInPlace(r1: mutable.Map[(String, Int), Long], r2: mutable.Map[(String, Int), Long]): mutable.Map[(String, Int), Long] = {

             r2.foldLeft(r1)((r, t) => {

               val oldOffset = r.getOrElse(t._1, t._2)

               if (t._2 >= oldOffset) r += t

               else r

             })

           }

           override def zero(initialValue: mutable.Map[(String, Int), Long]): mutable.Map[(String, Int), Long] = mutable.Map.empty[(String, Int), Long]

         })

       }

     }

     // 返回结果

     instance

   }

 }
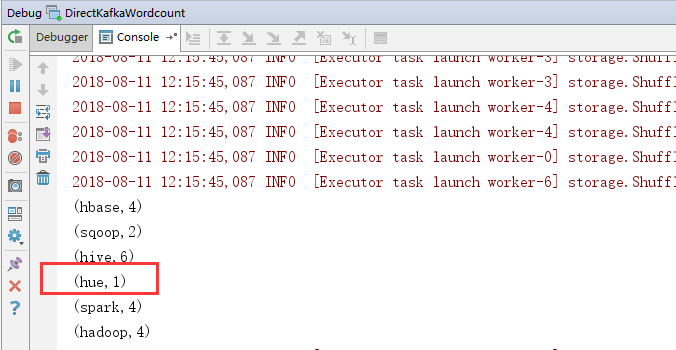
2.效果
可以将以前的信息打出来。

064 SparkStream与kafka的集成,主要是编程的更多相关文章
- Cassandra与Kafka的集成
Cassandra和Kafka经常一起用于微服务架构中.本文将介绍几种Cassandra和Kafka常见的集成模式. 简介 如果您的开发团队乐于接纳微服务架构的优点,那么您就会了解到,Kafk ...
- Kafka spring 集成
下载配置kafka参考该链接:http://www.cnblogs.com/super-d2/p/4534323.html pom.xml: <dependency> <groupI ...
- Structured Streaming教程(3) —— 与Kafka的集成
Structured Streaming最主要的生产环境应用场景就是配合kafka做实时处理,不过在Strucured Streaming中kafka的版本要求相对搞一些,只支持0.10及以上的版本. ...
- spark Streaming与kafka的集成消费
Spark 2.3.3 Kafka 2.11-1.0.2 Java jdk1.8.0_191 Hbase 1.2.11 from pyspark impo ...
- SpringBoot Kafka 整合集成 示例教程
1.使用IDEA新建工程,创建工程 springboot-kafka-producer 工程pom.xml文件添加如下依赖: <!-- 添加 kafka 依赖 --> <depend ...
- Spark-stream,kafka结合
先列参考文献: Spark Streaming + Kafka Integration Guide (Kafka broker version 0.10.0 or higher):http://spa ...
- Kafka集成SparkStreaming
Spark Streaming + Kafka集成指南 Kafka项目在版本0.8和0.10之间引入了一个新的消费者API,因此有两个独立的相应Spark Streaming包可用.请选择正确的包, ...
- Storm集成Kafka编程模型
原创文章,转载请注明: 转载自http://www.cnblogs.com/tovin/p/3974417.html 本文主要介绍如何在Storm编程实现与Kafka的集成 一.实现模型 数据流程: ...
- Spark Streaming之四:Spark Streaming 与 Kafka 集成分析
前言 Spark Streaming 诞生于2013年,成为Spark平台上流式处理的解决方案,同时也给大家提供除Storm 以外的另一个选择.这篇内容主要介绍Spark Streaming 数据接收 ...
随机推荐
- 如何保障Web应用安全性
通过加密算法对关键数据进行加密 通过过滤器防御跨站脚本攻击XSS.跨域请求伪造CRSF和SQL注入 通过安全框架( Shiro.Spring Security )进行认证和授权 设置IP黑白名单来进行 ...
- [C]C语言中的指针和内存泄漏几种情况
引言 原文地址:http://www.cnblogs.com/archimedes/p/c-point-memory-leak.html,转载请注明源地址. 对于任何使用C语言的人,如果问他们C语言的 ...
- 将list集合转json
public static class DataHelper { /// /// js 序列化器 /// static JavaScriptSerializer jss = new JavaScrip ...
- 2018年Android的保活方案效果统计
一.常见保活方案 1.监听广播:监听全局的静态广播,比如时间更新的广播.开机广播.解锁屏.网络状态.解锁加锁亮屏暗屏(3.1版本),高版本需要应用开机后运行一次才能监听这些系统广播,目前此方案失效.可 ...
- java 自动包装功能
基本类型直接存储在堆栈中 基本类型所具有的包装容器,使得可以在堆中创建一个非基本对象,用来表示对应的基本类型 基本类型与包装容器类对应如下:boolean Booleanbyte Byte short ...
- burpsuite使用教程和实战详解(一)
1.最近做渗透测试,其实使用一种方式很难全面的对一个web或者app等安全服务器做安全评估,所以要尽可能的对网络安全的渗透测试有一个较全面的认知.不光要熟悉前端和 后天的编程,还有掌握基于这两种编程的 ...
- 论文阅读笔记十五:Pyramid Scene Parsing Network(CVPR2016)
论文源址:https://arxiv.org/pdf/1612.01105.pdf tensorflow代码:https://github.com/hellochick/PSPNet-tensorfl ...
- Centos7搭建dhcp服务器
实验拓扑: 实验步骤如下: 1.挂载本地镜像,并安装dhcp组件. 2.更改配置文件,并重启服务. . 3.配置dhcp地址池范围 4.配置防火墙 结果:在客户端上,重启网卡,后查看ip
- python文件的分类
# 0.获取所有的文件名称列表import os import shutilos.chdir("files")file_list = os.listdir("./&quo ...
- 51 nod 1181 质数中的质数(质数筛法)
1181 质数中的质数(质数筛法) 如果一个质数,在质数列表中的编号也是质数,那么就称之为质数中的质数.例如:3 5分别是排第2和第3的质数,所以他们是质数中的质数.现在给出一个数N,求>=N的 ...