
RDD


scala> val rdd1=sc.parallelize(Array("coffe","coffe","hellp","hellp","pandas","mokey") )
rdd1: org.apache.spark.rdd.RDD[String] = ParallelCollectionRDD[8] at parallelize at <console>:24
scala> val rdd1=sc.parallelize(Array("coffe","coffe","hellp","hellp","pandas","mokey"))
rdd1: org.apache.spark.rdd.RDD[String] = ParallelCollectionRDD[9] at parallelize at <console>:24
scala> val rdd2=sc.parallelize(Array("coe","coe","help","help","pandas","mokey"))
rdd2: org.apache.spark.rdd.RDD[String] = ParallelCollectionRDD[10] at parallelize at <console>:24
scala> val rdd1_distinct=rdd1.distinct()
rdd1_distinct: org.apache.spark.rdd.RDD[String] = MapPartitionsRDD[13] at distinct at <console>:25
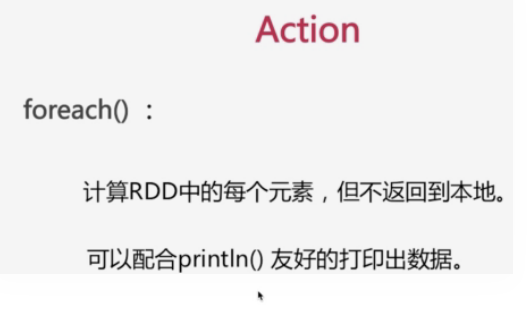
scala> rdd1_distinct.foreach(println)
hellp
mokey
pandas
coffe
scala> val rdd_union=rdd1.union(rdd2)
rdd_union: org.apache.spark.rdd.RDD[String] = UnionRDD[14] at union at <console>:27
scala> rdd1_union.foreach(println)
<console>:24: error: not found: value rdd1_union
rdd1_union.foreach(println)
^
scala> rdd_union.foreach(println)
pandas
mokey
coffe
hellp
coffe
hellp
pandas
mokey
coe
help
help
coe
scala> val rdd_intersection=rdd1.intersession(rdd2)
<console>:27: error: value intersession is not a member of org.apache.spark.rdd.RDD[String]
val rdd_intersection=rdd1.intersession(rdd2)
^
scala> val rdd_intersection=rdd1.intersection(rdd2)
rdd_intersection: org.apache.spark.rdd.RDD[String] = MapPartitionsRDD[20] at intersection at <console>:27
scala> rdd_intersection.foreach(println)
mokey
pandas
scala> val rdd_sub=rdd1.subtract(rdd2)
rdd_sub: org.apache.spark.rdd.RDD[String] = MapPartitionsRDD[24] at subtract at <console>:27
scala> rdd_sub.foreach(prinln)
<console>:26: error: not found: value prinln
rdd_sub.foreach(prinln)
^
scala> rdd_sub.foreach(println)
coffe
coffe
hellp
hellp
scala>
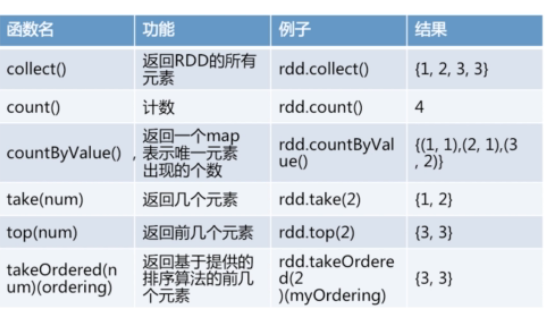

scala> val rdd=sc.parallelize(Array(1,2,2,3))
rdd: org.apache.spark.rdd.RDD[Int] = ParallelCollectionRDD[25] at parallelize at <console>:24
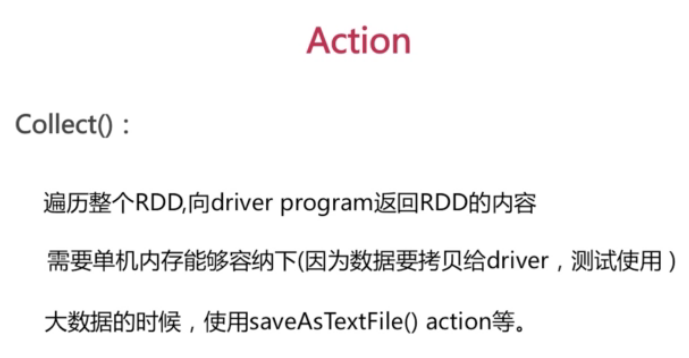
scala> rdd.collect()
res16: Array[Int] = Array(1, 2, 2, 3)
scala> rdd.reduce((x,y)=>x+y)
res18: Int = 8
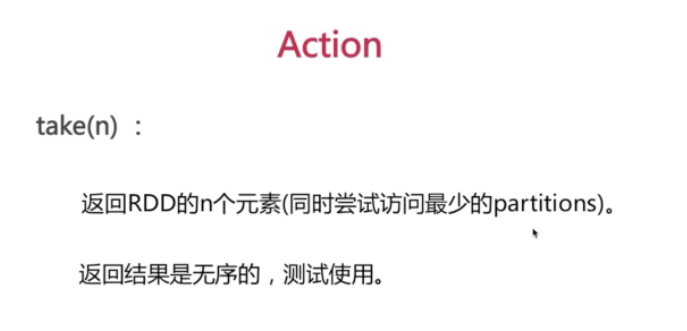
scala> rdd.take(2)
res19: Array[Int] = Array(1, 2)
scala> rdd.take(3)
res20: Array[Int] = Array(1, 2, 2)
scala>

scala> rdd.top(1)
res21: Array[Int] = Array(3)
scala> rdd.top(2)
res22: Array[Int] = Array(3, 2)
scala> rdd.top(3)
res23: Array[Int] = Array(3, 2, 2)
RDD的更多相关文章
- Spark RDD 核心总结
摘要: 1.RDD的五大属性 1.1 partitions(分区) 1.2 partitioner(分区方法) 1.3 dependencies(依赖关系) 1.4 compute(获取分区迭代列表) ...
- Spark笔记:复杂RDD的API的理解(下)
本篇接着谈谈那些稍微复杂的API. 1) flatMapValues:针对Pair RDD中的每个值应用一个返回迭代器的函数,然后对返回的每个元素都生成一个对应原键的键值对记录 这个方法我最开始接 ...
- Spark笔记:复杂RDD的API的理解(上)
本篇接着讲解RDD的API,讲解那些不是很容易理解的API,同时本篇文章还将展示如何将外部的函数引入到RDD的API里使用,最后通过对RDD的API深入学习,我们还讲讲一些和RDD开发相关的scala ...
- Spark笔记:RDD基本操作(下)
上一篇里我提到可以把RDD当作一个数组,这样我们在学习spark的API时候很多问题就能很好理解了.上篇文章里的API也都是基于RDD是数组的数据模型而进行操作的. Spark是一个计算框架,是对ma ...
- Spark笔记:RDD基本操作(上)
本文主要是讲解spark里RDD的基础操作.RDD是spark特有的数据模型,谈到RDD就会提到什么弹性分布式数据集,什么有向无环图,本文暂时不去展开这些高深概念,在阅读本文时候,大家可以就把RDD当 ...
- Spark核心——RDD
Spark中最核心的概念为RDD(Resilient Distributed DataSets)中文为:弹性分布式数据集,RDD为对分布式内存对象的 抽象它表示一个被分区不可变且能并行操作的数据集:R ...
- 【原】Learning Spark (Python版) 学习笔记(一)----RDD 基本概念与命令
<Learning Spark>这本书算是Spark入门的必读书了,中文版是<Spark快速大数据分析>,不过豆瓣书评很有意思的是,英文原版评分7.4,评论都说入门而已深入不足 ...
- Spark Rdd coalesce()方法和repartition()方法
在Spark的Rdd中,Rdd是分区的. 有时候需要重新设置Rdd的分区数量,比如Rdd的分区中,Rdd分区比较多,但是每个Rdd的数据量比较小,需要设置一个比较合理的分区.或者需要把Rdd的分区数量 ...
- RDD/Dataset/DataFrame互转
1.RDD -> Dataset val ds = rdd.toDS() 2.RDD -> DataFrame val df = spark.read.json(rdd) 3.Datase ...
- 深入理解Spark(一):Spark核心概念RDD
RDD全称叫做弹性分布式数据集(Resilient Distributed Datasets),它是一种分布式的内存抽象,表示一个只读的记录分区的集合,它只能通过其他RDD转换而创建,为此,RDD支持 ...
随机推荐
- Doc2vec实现原理
论文来源:https://www.eecs.yorku.ca/course_archive/2016-17/W/6412/reading/DistributedRepresentationsofSen ...
- 转://WITH AS and materialize hints
WITH AS: 就是将一个子查询部分独立出来,有时候是为了提高SQL语句的可读性,有时候是为了提高SQL语句性能. 如果一个SQL语句中,某个表会被访问多次,而且每次访问的限制条件一样的话,就可以使 ...
- HashMap 1.7
1.关键属性与内部类 1.1属性 使用拉链法解决hash冲突的hash表,hash表里存了多少个元素.数组有多长以及当什么情况下需要扩容是重要的参数. transient Entry<K,V&g ...
- 总结 Linux 下安装 PHP 扩展步骤
总结一下 Linux 下安装 PHP 扩展步骤,这里以安装 PHP 的 redis 扩展为例. 一.拿到扩展包下载地址,下载扩展包 pecl 上搜索 redis wget http://pecl.ph ...
- Python:Day54 ORM
Django项目中使用mysql DATABASES = { 'default': { 'ENGINE': 'django.db.backends.mysql', 'NAME': 'books', # ...
- 请根据英文单词的第一个字母判断星期几,如果第一个字母是一样的,则继续判断第二个字母。例如如果第一个字母是S,则继续判断第二个字母,如果第二个字母是a,则输出“星期六”
请根据英文单词的第一个字母判断星期几,如果第一个字母是一样的,则继续判断第二个字母.例如如果第一个字母是S,则继续判断第二个字母,如果第二个字母是a,则输出“星期六”.星期的英文单词如下表所示. 星期 ...
- mybatis-高级结果映射之一对多
目录 1 数据准备 1.2 实体类, 接口和XML 2 一对多映射 2.1 collection集合映射 2.1.1 创建结果实体类 2.1.2 创建结果集 2.1.3 创建对应的方法和XML 2.1 ...
- Linux常用软件启动、停止、重启命令
一.PHP 启动命令: /usr/local/php5/sbin/php-fpm 停止命令: pkill php-fpm 二.MySQL 启动命令: /etc/init.d/mysqld start ...
- Python+Appium学习篇之WebView处理
1.认识WebView 实例说明: 当你打开百度阅读APP→VIP全站去广告→用自带的 UI Automator去定位里面的元素,如图: 不管你去定位 '规则详情' '开通'等等,都会定位不到,只 ...
- stark组件之展示数据(查)
1.编辑按钮构建完成 2.构造表头,删除,checkbox,links编辑 3.代码+总结 1.编辑按钮构建完成 1.必备知识预习 第一个会打印5. 第二个输出alex alex是person ...