
Spark应用【根据新df更新旧df】
       // 主键字段保持不变,再转换回来

       var columnMap:Map[String, String] = Map()

       for(key <- keysOpt){

         columnMap += (key + " AS " + key + "S" -> key)

       }

       // keysOpt:主键字段构成的数组

       var columnBackMap:Map[String, String] = Map()

       for(key <- columnName){

         if(!keysOpt.contains(key)){// 只对非主键字段做处理

           columnBackMap += (key + "S" -> key)

         }

       }

       val convertion = columnName.map(key => key + " AS " + key + "S") // columnName:包含该df中所有的字段名称

       val df1_plus = df1.selectExpr(convertion.map(t => columnMap.getOrElse(t, t)): _*) // 修改df1除主键之外的字段,末尾加S

       //df关联

       val df3 = df1_plus.join(df2, keysOpt)

       val df4 = df3.select(columnName.map(c => df2(c)): _*)

       // 重新获取df3中属于df1的字段

       val df1_column_back = df1_plus.columns

       val df5 = df3.select(df1_column_back.map(c => df1_plus(c)): _*)

       // 把转换的字段名称再转换回来

       val df5_plus = df1.selectExpr(df1_column_back.map(t => columnBackMap.getOrElse(t, t)): _*) // 去掉末尾之前添加的S

       // 合并

       val union_Data = df4.union(df5_plus)
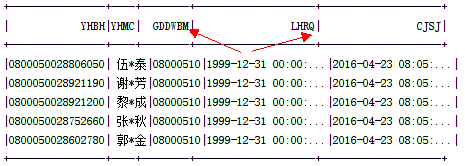
结果:
在非主键字段名称末尾添加S

去掉非主键字段名称末尾添加的S
Spark应用【根据新df更新旧df】的更多相关文章
- 11-Pandas之排序(df.sort_index()、df.sort_values()、随机重排、随机采样)
排序是一种索引机制的一种常见的操作方法,也是Pandas重要的内置运算,主要包括以下3种方法: 排序方法 说明 sort_values() 根据某一列的值进行排序 sort_index() 根据索引进 ...
- 5-Pandas数据分组的函数应用(df.apply()、df.agg()和df.transform()、df.applymap())
将自己定义的或其他库的函数应用于Pandas对象,有以下3种方法: apply():逐行或逐列应用该函数 agg()和transform():聚合和转换 applymap():逐元素应用函数 一 ...
- Mean Shift Tracking: 2000-2012回顾 (新论文更新)
参考: Mean Shift Tracking: 2000-2012回顾 (新论文更新) ECCV2016要来了,估计深度学习要一统天下了吧
- atitit.hbnt orm db 新新增更新最佳实践o99
atitit.hbnt orm db 新新增更新最佳实践o99 1. merge跟个save了. 1 2. POJO对象处于游离态.持久态.托管态.使用merge()的情况. 1 3. @Dynami ...
- atitit.hbnt orm db 新新增更新最佳实践o7
atitit.hbnt orm db 新新增更新最佳实践o7 1. merge跟个save了. 1 2. POJO对象处于游离态.持久态.托管态.使用merge()的情况. 1 3. @Dynamic ...
- xmake v2.1.5版本正式发布,大量新特性更新
此版本带来了大量新特性更新,具体详见:xmake v2.1.5版本新特性介绍. 更多使用说明,请阅读:文档手册. 项目源码:Github, Gitee. 新特性 #83: 添加 add_csnippe ...
- linux命令df中df -h和df -i
df 命令: linux中df命令的功能是用来检查linux服务器的文件系统的磁盘空间占用情况.可以利用该命令来获取硬盘被占用了多少空间,目前还剩下多少空间等信息. 1.命令格式: df [选项] [ ...
- linux命令df中df -h和df -i的区别
df 命令: linux中df命令的功能是用来检查linux服务器的文件系统的磁盘空间占用情况.可以利用该命令来获取硬盘被占用了多少空间,目前还剩下多少空间等信息. 1.命令格式: df [选项] [ ...
- Spark 1.5新特性介绍
一.DataFrame执行后端优化(Tungsten第一阶段) DataFrame可以说是整个Spark项目最核心的部分,在1.5这个开发周期内最大的变化就是Tungsten项目的第一阶段已经完成.主 ...
随机推荐
- sql server 性能调优之 资源等待内存瓶颈的三种等待类型
一.概述 这篇介绍Stolen内存相关的主要三种等待类型以及对应的waittype编号,CMEMTHREAD(0x00B9),SOS_RESERVEDMEMBLOCKLIST(0x007B),RESO ...
- python自动化工具之pywinauto(一个实例)结合pyuserinput
以下是pywinauto使用指南.这个窗口句柄可以在Spy++中查看 (Microsoft Spy++(查看窗口句柄) 10.00.30319 官方最新绿色版) python自动化工具之pywinau ...
- 搞懂ES6的import export
引言 说来惭愧,这两个关键字几乎天天在写,但是自己写的模块export出去的对象,import居然拿不到,也是没谁了
- 详解网络编程必会的poll和epoll函数
前言 之前已经介绍过select函数,请参考这篇博客:https://www.cnblogs.com/liudw-0215/p/9661583.html,原理都是类似的,有时间先阅读下那篇博客,以便于 ...
- SpingBoot 属性加载
属性加载顺序 配置属性加载的顺序 开发者工具 `Devtools` 全局配置参数: 单元测试上的 `@TestPropertySource` 注解指定的参数: 单元测试上的 `@SpringBootT ...
- Linux文本编辑器vim
目录 1.vim 的工作模式 2.插入命令 3.定位命令 4.删除命令 5.复制和剪切命令 6.替换和取消命令 7.搜索和搜索替换命令 8.保存和退出命令 9.vim 高级操作 10.总结 通过前面几 ...
- SpringCloud(1) 架构演进和基础知识简介
一.传统架构演进到分布式架构 简介:讲解单机应用和分布式应用架构演进基础知识 (画图) 高可用 LVS+keepalive 1.单体应用:开发速度慢.启动时间长.依赖庞大.等等 2.微服务:易开发.理 ...
- Hibernate学习(六)———— cascade(级联)和inverse关系详解
序言 写这篇文章之前,自己也查了很多的资料来搞清楚这两者的关系和各自所做的事情,但是百度一搜,大多数博文感觉说的云里雾里,可能博主自己清楚是怎么一回事,但是给一个不懂的人或者一知半解的人看的话,别人也 ...
- Eureka 2.0 开源流产,真的对你影响很大吗?
本文首发于 http://blog.didispace.com/Eureka-2-0-discontinued/ 最近连续发烧四天,偶尔刷两下朋友圈都能看到好几条来自不同号的关于<Eureka ...
- for 循环 和 Array 数组对象
博客地址:https://ainyi.com/12 for 循环 和 Array 数组对象方法 for for-in for-of forEach效率比较 - 四种循环,遍历长度为 1000000 的 ...