
Perl6 必应抓取(2):最终版
use HTTP::UserAgent;

use URI::Encode;

my $ua = HTTP::UserAgent.new(:user-agent<Mozilla/5.0 (Windows NT 6.1; WOW64; rv:52.0) Gecko/ Firefox/52.0>);

my $bing_url = 'http://cn.bing.com/search?q=';

my $choose = rx/'<cite>'(.*?)'</cite>'/;#要查的内容

my $filename = ~now.DateTime~'.txt';

$filename = do given $filename {S:g/':'/-/};

my $fp = open $filename, :w;

my $hv;

my $all_data; #进度显示

sub MAIN (Int $page_number) {

    say '+';

    say '=======================================================================';

    say '                  By: FireC@t';

    say '=======================================================================';

    #say '';

    my $strings = prompt 'Input String You Want: ';

    say 'Search : '~$strings;

        $all_data = *$page_number;

    say 'Data count(10*'~$page_number~') : '~$all_data; #输出数据数目

    my $start_time = now.DateTime;

    say 'Start Time : '~$start_time;

    say '=======================================================================';

    $strings = uri_encode($strings);

    my $count = ;

    for ..$page_number {

          #每一页的结果调用函数

          my $url_end = '&first='~$count;

          my $targeturl = $bing_url~$strings~$url_end;

          #say $targeturl;

          #调用函数查询结果URL

          Bing_search($targeturl);

          $count += ;

    }

    my $end_time = now.DateTime;

    say '=======================================================================';

    say 'Finish Time : '~$end_time;

    say 'Time Use : '~($end_time-$start_time);

    say '=======================================================================';

    say 'Data save to : '~$filename;

    say '=======================================================================';

}

#查询函数

sub Bing_search($url) {

    my $html = $ua.get($url).content;#获取结果

    loop {

          $html ~~ $choose;

          last if not $;

          my $swap_ = ~$;

          $html = $/.postmatch;

          $swap_ = do given $swap_ {S:g/'<strong>'//};

          $swap_ = do given $swap_ {S:g/'</strong>'//};

          say '('~$hv~':'~$all_data~')'~$swap_;

                    $hv++;

          $fp.say($swap_);

    }

}
说明, 在dos下输入中文, 因为终端编码问题, 程序会报错。
在linux下运行正常, 或dos下设置编为utf8。
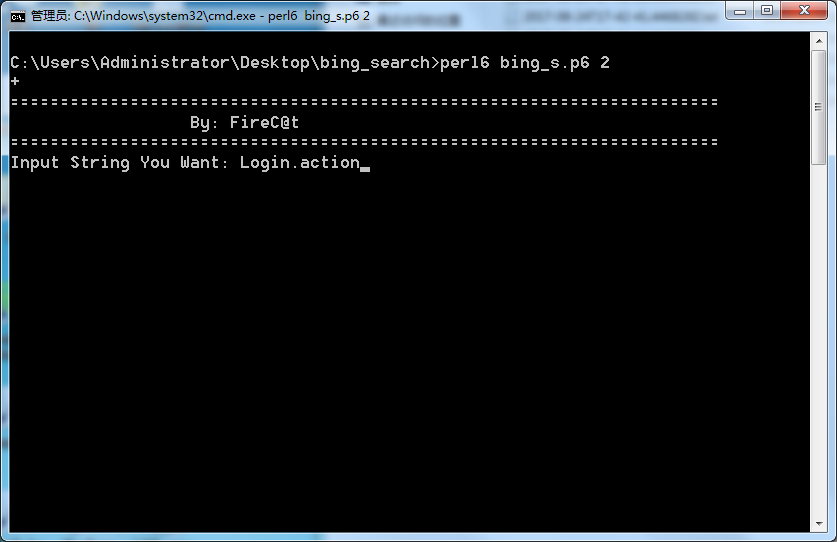
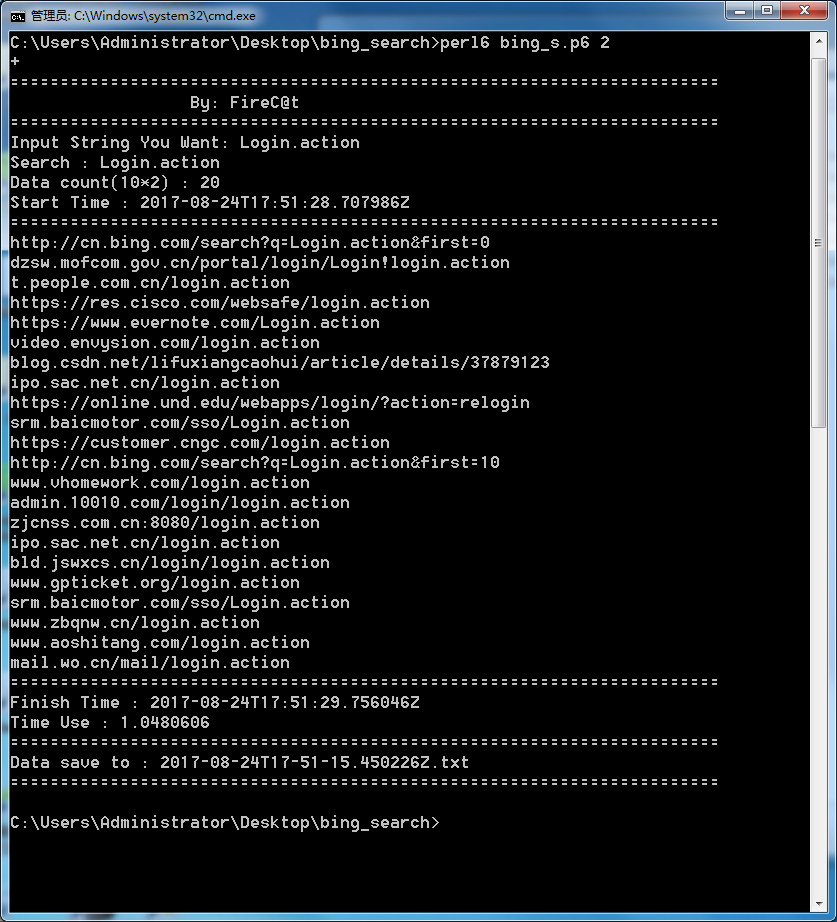
用法:
> perl6 bing_s.p6

这里的参数 10为页数, 可随意更改。
BUG:
如果bing中的结果只有 100 条, 而我们向他取 1000 条, 这时我们会取到相同的数据。
修复:
在运行前, 用bing的数据库条目与用户输入的对比。 如果用户请求数目超出bing现有数目, 取bing最大值代替用户输入的最大值。
update: 2017/08/25
修复后代码:
use HTTP::UserAgent;

use URI::Encode;

=begin pod

用于国内版bing查询

# by FireC@t

# 2017/08/25

=end pod

my $ua = HTTP::UserAgent.new(:user-agent<Mozilla/5.0 (Windows NT 6.1; WOW64; rv:52.0) Gecko/ Firefox/52.0>);

my $bing_url = 'http://cn.bing.com/search?q=';

my $choose = rx/'<cite>'(.*?)'</cite>'/;#要查的内容

my $filename = ~now.DateTime~'.txt';

$filename = do given $filename {S:g/':'/-/};

my $fp = open $filename, :w;

my $hv=;

my $all_data; #进度显示

sub MAIN (Int $page_number) {

    say '+';

    say '=======================================================================';

    say '                  By: FireC@t';

    say '=======================================================================';

    #say '';

    my $strings = prompt 'Input String You Want: ';

    say 'Search : '~$strings;

    say 'User Data  Get Page : '~$page_number; #输出数据数目

    my $start_time = now.DateTime;

    $strings = uri_encode($strings);

        #调用用户处理函数, 处理记录数, 防止重复

        $all_data = *$page_number;#先计算用户实际要求的数目

        #如果用户请求数据过多, 提示

        #say 'Test all_data ->'~$all_data; # for test;

        my $page_number_swap = User_data_chang($strings);

        if $page_number_swap < $page_number {

                    say 'Not enough Data for bing('~$page_number_swap~' pages), page_number change: '~$page_number~' to '~$page_number_swap;

                    #改写用户要求的实际数目

                    $all_data = *$page_number_swap;

        }

    my $count = ;

        say 'Start Time : '~$start_time;

        say '=======================================================================';

        #sleep(100);

    for ..$page_number_swap {

          #每一页的结果调用函数

          my $url_end = '&first='~$count;

          my $targeturl = $bing_url~$strings~$url_end;

          say '>> '~$targeturl~'';

          #调用函数查询结果URL

          Bing_search($targeturl);

          $count += ;

    }

    my    $end_time = now.DateTime;

    say '=======================================================================';

    say 'Finish Time : '~$end_time;

    say 'Time Use : '~($end_time-$start_time);

    say '=======================================================================';

        say 'Data('~$hv-~' lines) save to : '~$filename;

        say '=======================================================================';

}

#查询函数

sub Bing_search($url) {

    my $html = $ua.get($url).content;#获取结果

    loop {

          $html ~~ $choose;

                    last if not $;

          my $swap_ = ~$;

          $html = $/.postmatch;

          $swap_ = do given $swap_ {S:g/'<strong>'//};

          $swap_ = do given $swap_ {S:g/'</strong>'//};

          say '('~$hv~':'~$all_data~') '~$swap_;

                    $hv++; #记录数据数目

          $fp.say($swap_);

    }

}

#用于处理用户请求记录数

sub User_data_chang($strings){

        #获取所有记录数:

        my $start_url = $bing_url~$strings;

        my $all_result_number = $ua.get($start_url);

        $all_result_number ~~ /'sb_count">'(.*?)\s.*?'</span>'/;

        if not  $ {

                    #say 'Not Result';

                    return ;

                    #没有结果, 直接返回0个页面

        }

        #如果有结果

        my $data_number = ~$;#123,45

        #say $data_number; #test

        my $bing_all_data = Int($data_number.subst: /','/,'',:g); #获得结果总数

        #test

        #say $bing_all_data;

        #say $all_data;

        #$all_data为用户请求总数

        if $all_data > $bing_all_data {

                    #如果用户请求数大于数据已有数目, 那就返回所有请求

                    #调用分页函数返回一共有多少页

                    my $user_page = User_page($bing_all_data);

                    #say 'return page:'~$user_page;    sleep(1000);

                    return $user_page;#返回页数

        }else {

                    #否则返回用户自定义页数

                    my $user_page = User_page($all_data);

                    #say 'return page:'~$user_page;    sleep(1000);

                    return $user_page;

        }

}

#用于处理页数

sub User_page($data_number) {

            my $page_check = ~($data_number/);

            if $page_check.split('.').elems ==  {

                    #说明有小数

                    return $page_check.split('.')[] + ;

            }else {

                    #没小数, 取整数

                    return $page_check.split('.')[];

            }

}
Perl6 必应抓取(2):最终版的更多相关文章
- Perl6 必应抓取(1):测试版代码
一个相当丑漏的代码, 以后有时间再优化了. 默认所有查找都是15页, 如果结果没有15页这么多估计会有重复.速度还是很快的. sub MAIN() { my $fp = open 'bin_resul ...
- Python爬虫:新浪新闻详情页的数据抓取(函数版)
上一篇文章<Python爬虫:抓取新浪新闻数据>详细解说了如何抓取新浪新闻详情页的相关数据,但代码的构建不利于后续扩展,每次抓取新的详情页时都需要重新写一遍,因此,我们需要将其整理成函数, ...
- 【爬虫】biqukan抓取2.0版
#!python3.7 import requests,sys,time,logging,random from lxml import etree logging.basicConfig(level ...
- php抓取远程数据显示在下拉列表中
前言:周五10月20日的时候,经理让做一个插件,使用的thinkphp做这个demo 使用CURL抓取远程数据时如果出现乱码问题可以加入 header("content-type:text/ ...
- Java、C#双语版HttpHelper类(解决网页抓取乱码问题)
在做一些需要抓取网页的项目时,经常性的遇到乱码问题.最省事的做法是去需要抓取的网站看看具体是什么编码,然后采用正确的编码进行解码就OK了,不过总是一个个页面亲自去判断也不是个事儿,尤其是你需要大量抓取 ...
- 如何使用 Github Actions 自动抓取每日必应壁纸?
如何白嫖 Github 服务器自动抓取必应搜索的每日壁纸呢? 如果你访问过必应搜索网站,那么你一定会被搜索页面的壁纸吸引,必应搜索的壁纸每日不同,自动更换,十分精美.这篇文章会介绍如何一步步分析出必应 ...
- python爬虫beta版之抓取知乎单页面回答(low 逼版)
闲着无聊,逛知乎.发现想找点有意思的回答也不容易,就想说要不写个爬虫帮我把点赞数最多的给我搞下来方便阅读,也许还能做做数据分析(意淫中--) 鉴于之前用python写爬虫,帮运营人员抓取过京东的商品品 ...
- 用正则表达式抓取网页中的ul 和 li标签中最终的值!
获取你要抓取的页面 const string URL = "http://www.hn3ddf.gov.cn/price/GetList.html?pageno=1& ...
- Java版 QQ空间自动登录无需拷贝cookie一天抓取30WQQ说说数据&流程分析
QQ空间说说抓取难度比较大,花了一个星期才研究清楚! 代码请移步到GitHub GitHub地址:https://github.com/20100507/Qzone [没有加入多线程,希望你可以参与进 ...
随机推荐
- 子类的实例给父类的引用 在编译器时候 jvm认为他是父类的实例 只会去寻找父类里面的方法 如果调用子类里面的属性或者方法时候 jvm会认为该引用并没有 所以会报错
- 深度学习读书笔记之RBM(限制波尔兹曼机)
深度学习读书笔记之RBM 声明: 1)看到其他博客如@zouxy09都有个声明,老衲也抄袭一下这个东西 2)该博文是整理自网上很大牛和机器学习专家所无私奉献的资料的.具体引用的资料请看参考文献.具体的 ...
- BZOJ 2426: [HAOI2010]工厂选址
2426: [HAOI2010]工厂选址 Time Limit: 10 Sec Memory Limit: 128 MBSubmit: 364 Solved: 248[Submit][Status ...
- BZOJ2217 [Poi2011]Lollipop 【贪心】
题目链接 BZOJ2217 题解 如果只判定存不存在方案的话,我倒是想到可以将\(2\)拆成两个\(1\),其中一个不能作为区间开头,线段树优化计算补集方案数 但是一看这道题要输出方案啊,,, 怎么办 ...
- POJ.1067 取石子游戏 (博弈论 威佐夫博弈)
POJ.1067 取石子游戏 (博弈论 威佐夫博弈) 题意分析 简单的威佐夫博弈 博弈论快速入门 代码总览 #include <cstdio> #include <cmath> ...
- elasticsearch5使用snapshot接口备份索引
数据备份是一个必须要考虑的问题,官网提供了 snapshot 接口来备份和恢复数据. 先来看看官方说明: 如果ES是集群,那么需要使用共享存储,支持的存储有: a.shared file system ...
- linux中man 2与man 3区别
1.Standard commands (标准命令)2.System calls (系统调用)3.Library functions (库函数)4.Special devices (设备说明)5.Fi ...
- Linux编程中 #define _XOPEN_SOURCE的作用
[误解]#define _XOPEN_SOURCE决不是简单的宏定义它是使程序符合系统环境的不可缺少的部分 [概念]Glibc 所实现全部或部分规范下的功能有:1.ISO C: C语言国际标准. 2. ...
- Java入门:使用Java API
什么是Java类库 在编写程序的时候,通常有很多功能是通用的,或者是很基础的,可以用这些功能来组成更发杂的功能代码.比如文件操作,不同程序对文件的操作基本都是一样的,打开文件,关闭文件,读取文件里面的 ...
- 针对《面试心得与总结—BAT、网易、蘑菇街》一文中出现的技术问题的收集与整理
最近,我在ImportNew网站上,看到了这篇文章,觉得总结的非常好,就默默的收藏起来了,觉得日后一定要好好整理学习一下,昨天突然发现在脉脉的行业头条中,居然也推送了这篇文章,更加坚定了我整理的信心. ...