
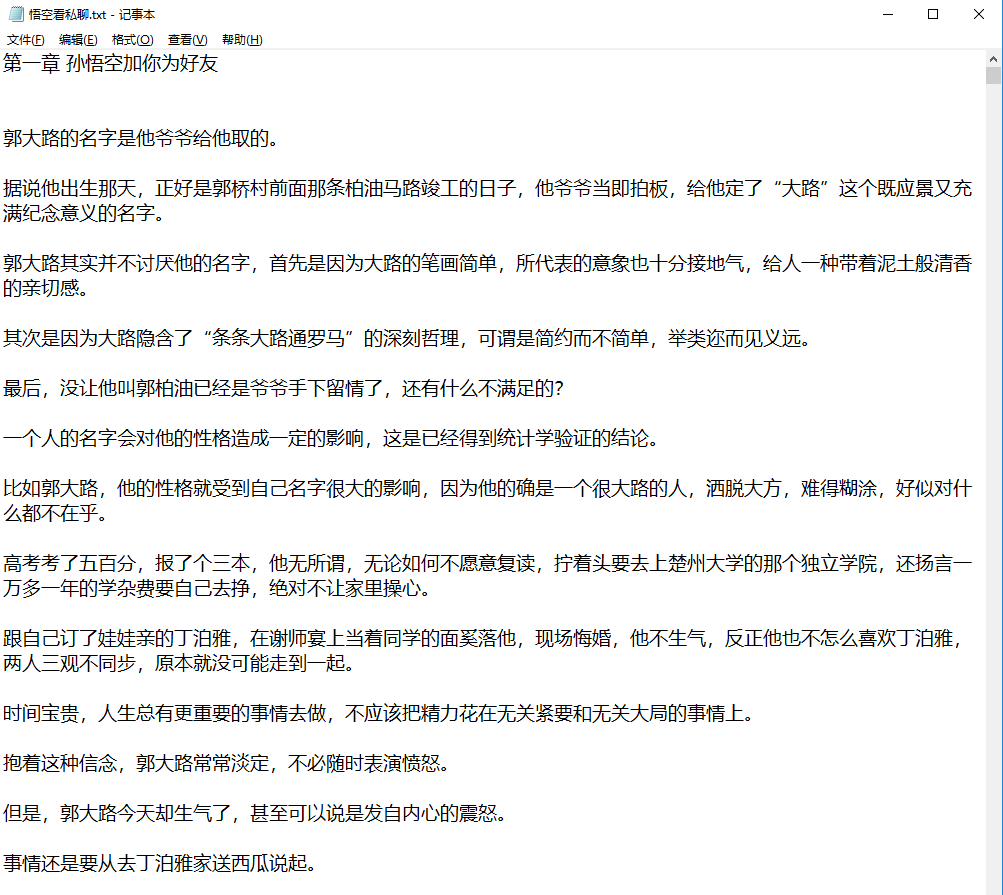
python爬虫-《笔趣看》网小说《悟空看私聊》
小编是个爱看小说的人,哈哈
# -*- coding:UTF-8 -*-

'''

类说明:下载《笔趣看》网小说《悟空看私聊》

'''

from bs4 import BeautifulSoup

import requests,urllib3, sys

urllib3.disable_warnings()

class downloader(object):

    def __init__(self):

        self.server = 'http://www.biqukan.com/'

        self.target = 'http://www.biqukan.com/37_37039/'

        self.names = []            #存放章节名

        self.urls = []            #存放章节链接

        self.nums = 0            #章节数

    """

    函数说明:获取下载链接

    """

    def get_download_url(self):

        req = requests.get(url = self.target)

        html = req.text

        div_bf = BeautifulSoup(html, "html.parser")

        div = div_bf.find_all('div', class_ = 'listmain')

        a_bf = BeautifulSoup(str(div[0]))

        a = a_bf.find_all('a')

        self.nums = len(a[12:])                                #剔除不必要的章节,并统计章节数

        for each in a[12:]:

            self.names.append(each.string)

            self.urls.append(self.server + each.get('href'))

        print(self.names)

        print(self.urls)

    """

    函数说明:获取章节内容

        target - 下载连接(string)

        texts - 章节内容(string)

    """

    def get_contents(self, target):

        req = requests.get(url = target)

        aa = req.content

        bf = BeautifulSoup(aa,"html.parser")

        texts = bf.find_all('div', id = 'content')

        a = texts[0].text.replace('\xa0'*8,'\n\n')

        print(a)

        return a

    """

    函数说明:将爬取的文章内容写入文件

        name - 章节名称(string)

        path - 当前路径下,小说保存名称(string)

        text - 章节内容(string)

    """

    def writer(self, name, path, text):

        write_flag = True

        with open(path, 'a', encoding='utf-8') as f:

            f.write(name + '\n')

            f.writelines(text)

            f.write('\n\n')

if __name__ == "__main__":

    dl = downloader()

    dl.get_download_url()

    print('《悟空看私聊》开始下载:')

    for i in range(dl.nums):

        dl.writer(dl.names[i], 'D://悟空看私聊.txt', dl.get_contents(dl.urls[i]))

        sys.stdout.write("  已下载:%.5f%%" %  float(i/dl.nums*100) + '\r')

        sys.stdout.flush()

    print('《悟空看私聊》下载完成')
python爬虫-《笔趣看》网小说《悟空看私聊》的更多相关文章
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- python爬虫:爬取慕课网视频
前段时间安装了一个慕课网app,发现不用注册就可以在线看其中的视频,就有了想爬取其中的视频,用来在电脑上学习.决定花两天时间用学了一段时间的python做一做.(我的新书<Python爬虫开发与 ...
- Python爬虫抓取东方财富网股票数据并实现MySQL数据库存储
Python爬虫可以说是好玩又好用了.现想利用Python爬取网页股票数据保存到本地csv数据文件中,同时想把股票数据保存到MySQL数据库中.需求有了,剩下的就是实现了. 在开始之前,保证已经安装好 ...
- Python 爬虫 爬校花网!!
爬虫:是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本 1.福利来了 校花网 ,首先说为什么要爬这个网站呢,第一这个网站简单爬起来容易不会受到打击,第二呢 你懂得... 1.第一步,需要下载 ...
- Python爬虫入门教程 21-100 网易云课堂课程数据抓取
写在前面 今天咱们抓取一下网易云课堂的课程数据,这个网站的数据量并不是很大,我们只需要使用requests就可以快速的抓取到这部分数据了. 你第一步要做的是打开全部课程的地址,找出爬虫规律, 地址如下 ...
- Python爬虫 爬取百合网的女人们和男人们
学Python也有段时间了,目前学到了Python的类.个人感觉Python的类不应称之为类,而应称之为数据类型,只是数据类型而已!只是数据类型而已!只是数据类型而已!重要的事情说三篇. 据书上说一个 ...
- Python 爬虫: 抓取花瓣网图片
接触Python也好长时间了,一直没什么机会使用,没有机会那就自己创造机会!呐,就先从爬虫开始吧,抓点美女图片下来. 废话不多说了,讲讲我是怎么做的. 1. 分析网站 想要下载图片,只要知道图片的地址 ...
- 项目: python爬虫 福利 煎蛋网妹子图
嘿嘿嘿! 嘿嘿嘿! 福利一波, 之前看小甲鱼的python教学视频的时候, 看到上面教的爬虫, 爬美女图片的, 心很痒痒, 但是不知道为啥, 按照视频一个字一个字敲的代码,总是报错, 有一天花了 一下 ...
- python爬虫06取当当网 Top 500 本五星好评书籍
主要思路 使用 page 变量来实现翻页 我们使用 requests 请求当当网 然后将返回的 HTML 进行正则解析 由于我们暂时还没学到数据库 所以解析完之后就把内容存到文件中 def main( ...
- python爬虫爬取赶集网数据
一.创建项目 scrapy startproject putu 二.创建spider文件 scrapy genspider patubole patubole.com 三.利用chrome浏览器 ...
随机推荐
- 关于html异步加载外部json文件报错问题
一. HTML代码如下: 参考网站(echarts-JSON请求数据):https://blog.csdn.net/you23hai45/article/details/51585506 <!D ...
- nRF52832 串口仅支持偶检验
通常在使用串口时,我们习惯是不进行奇偶检验(even/odd parity),让应用层的软件自己检验即可.如果非要硬件校验时,以下是关于NRF52832的奇偶检验配置: // 52832 仅支持 ev ...
- Scala函数柯里化(Currying or Curry)
柯里化(Currying) 把接受多个参数的函数变换成接受一个单一参数(最初函数的第一个参数)的函数,并且返回接受余下的参数而且返回结果的新函数的技术. 简单的实现如下: scala> def ...
- eos的资源和工具列表
1.eos买rex的时候同时获得投票收益: https://b1.run/eosproxy eos的投票衰减规则: Block.one 希望确保用户经常更新他们的投票设定,而不是设置完就不管了.为了促 ...
- ZooKeeper和ZAB协议
前言 ZooKeeper是一个提供高可用,一致性,高性能的保证读写顺序的存储系统.ZAB协议为ZooKeeper专门设计的一种支持数据一致性的原子广播协议. 演示环境 $ uname -a Darwi ...
- Xamarin图表开发基础教程(7)OxyPlot框架
Xamarin图表开发基础教程(7)OxyPlot框架 Xamarin.Forms中使用OxyPlot框架 在Xamarin. Forms平台上实现图表显示需要完成以下的步骤: 1.添加OxyPlot ...
- np.concatenate
- VBA 如何检测一个中文字符串是否包含在另一个字符串中
Sub test() aaa = "江苏省南京市建邺区水西门大街34号" If InStr(aaa, Then MsgBox "在里面" Else MsgBox ...
- Python3基础 list(dict) 使用 * 扩充时,出现字典元素重复问题
Python : 3.7.3 OS : Ubuntu 18.04.2 LTS IDE : pycharm-community-2019.1.3 ...
- (二)limit的高级用法
一.取出前n条数据 ; 二.取出第几行到第几行的数据 ,; 解释:取出从第3行(从0行开始)开始的5条记录.