
Logstash 安装配置使用
一、Windows下安装运行
官网下载,下载与elasticSearch同一个版本,zip格式。Logstash占用内存较大,我在使用的时候cpu一般都是冲到90%
1、CMD直接运行
创建一个基本的Logstash管道来测试Logstash设置。
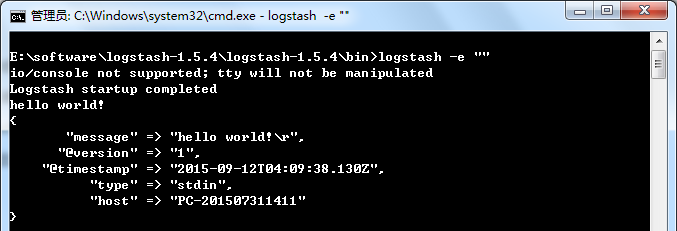
解压logstash ,并且在bin目录下运行命令(参考下面命令):加入 -e 标志可以在命令行直接指定配置文件。
logstash -e ""
或者:
logstash -e "input { stdin {} } output { stdout {} }"
注意:双引号不能改成单引号否则可能会报:ERROR: Unknown command '{'
然后你会发现终端在等待你的输入。没问题,敲入 Hello World,回车,Logstash会将时间戳和IP地址信息加入输出的消息。按下ctrl+C可以从命令行退出Logstash。
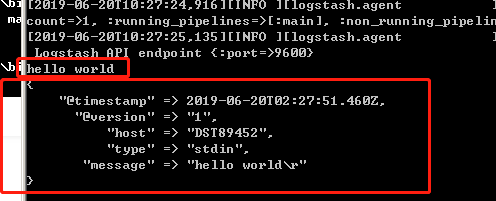
2、配置文件运行,并用bat文件
进入bin目录,新建文件 logstash_default.conf 内容如下:
input {

stdin{}

}

output {

stdout{}
elasticsearch {hosts=>"127.0.0.1:9200"}

}
配置文件中定义了stdout和elasticsearch作为output,这样的“多重输出”即保证输出结果显示到屏幕上,同时也输出到elastisearch中。
在bin目录,新文件文件 run_default.bat 内容如下:
logstash -f logstash_default.conf
启动 run_default.bat 启动logstash。 等待cmd中出现:logstash api endpoint {:port=>9600 } 浏览器访问:http://localhost:9600/
在CMD中输入任何你想输入的字符串。然后看下es中是否有了数据。

3、使用NSSM将Logstash安装为Windows服务
- 下载NSSM:http://www.nssm.cc/download
将
NSSM解压,eg:E盘,进入到E:\nssm-2.24\win64 ,执行cmdnssm install logstash,【nssm install <服务名> 例如:nssm install Elasticsearch(自定义服务名)】弹出如下界面
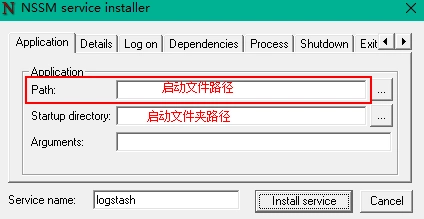
Path: 填写启动文件路径(${LOGSTASH_HOME}\bin\xxx.bat)Startup directory : 填写启动文件目录(${LOGSTASH_HOME}\bin)Detail : 填写服务名称Dependencies : 填写此服务启动需要依赖哪个服务(一般配置为要先启动elasticsearch,再启动logstash)
二、工作原理
在logstash中,包括了三个阶段:输入input --> 处理filter(不是必须的) --> 输出output
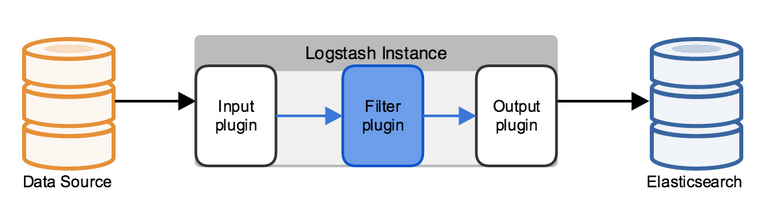
1、输入:采集各种样式、大小和来源的数据
数据往往以各种各样的形式,或分散或集中地存在于很多系统中。Logstash 支持各种输入选择 ,可以在同一时间从众多常用来源捕捉事件。能够以连续的流式传输方式,轻松地从您的日志、指标、Web 应用、数据存储以及各种 AWS 服务采集数据。
2、过滤器:实时解析和转换数据
数据从源传输到存储库的过程中,Logstash 过滤器能够解析各个事件,识别已命名的字段以构建结构,并将它们转换成通用格式,以便更轻松、更快速地分析和实现商业价值。
3、输出:选择你的存储,导出你的数据
尽管 Elasticsearch 是我们的首选输出方向,能够为我们的搜索和分析带来无限可能,但它并非唯一选择。
Logstash 提供众多输出选择,您可以将数据发送到您要指定的地方,并且能够灵活地解锁众多下游用例。
每个阶段都由很多的插件配合工作,比如file、elasticsearch、Redis等等。
每个阶段也可以指定多种方式,比如输出既可以输出到elasticsearch中,也可以指定到标准输出stdout在控制台打印。
三、命令行中常用的命令
-f:通过这个命令可以指定Logstash的配置文件,根据配置文件配置logstash
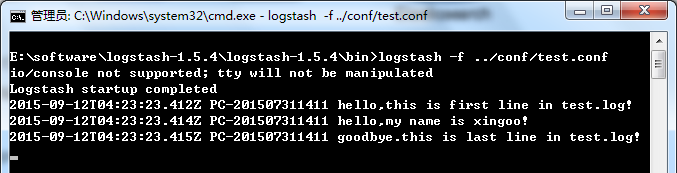
-e:后面跟着字符串,该字符串可以被当做logstash的配置(如果是“” 则默认使用stdin作为输入,stdout作为输出)
-l:日志输出的地址(默认就是stdout直接在控制台中输出)
-t:测试配置文件是否正确,然后退出。
logstash -f stdin.conf -t
四、用Logstash解析日志
在现实世界中,一个Logstash管理会稍微复杂一些:它通常有一个或多个input,filter 和 output 插件。
在这一小节中,创建一个Logstash管道,并且使用Filebeat将Apache Web日志作为input,解析这些日志,然后将解析的数据写到一个Elasticsearch集群中。你将在配置文件中定义管道,而不是在命令行中定义管道配置。
在开始之前,请先下载示例数据。
1、配置Filebeat来发送日志行到Logstash
在你创建Logstash管道之前,你需要先配置Filebeat来发送日志行到Logstash。Filebeat客户端是一个轻量级的、资源友好的工具,它从服务器上的文件中收集日志,并将这些日志转发到你的Logstash实例以进行处理。Filebeat设计就是为了可靠性和低延迟。Filebeat在主机上占用的资源很少,而且Beats input插件将对Logstash实例的资源需求降到最低。
(画外音:注意,在一个典型的用例中,Filebeat和Logstash实例是分开的,它们分别运行在不同的机器上。在本教程中,Logstash和Filebeat在同一台机器上运行。)
第1步:配置filebeat.yml
filebeat.inputs:

- type: log

  paths:

    - /usr/local/programs/logstash/logstash-tutorial.log

output.logstash:

  hosts: ["localhost:5044"]
第2步:在logstash安装目录下新建一个文件first-pipeline.conf
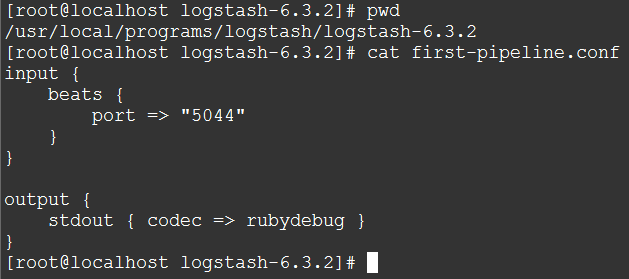
(画外音:刚才说过了通常Logstash管理有三部分(输入、过滤器、输出),这里input下面beats { port => "5044" }的意思是用Beats输入插件,而stdout { codec => rubydebug }的意思是输出到控制台)
第3步:检查配置并启动Logstash
logstash -f first-pipeline.conf --config.test_and_exit
(画外音:--config.test_and_exit选项的意思是解析配置文件并报告任何错误)
logstash -f first-pipeline.conf --config.reload.automatic
(画外音:--config.reload.automatic选项的意思是启用自动配置加载,以至于每次你修改完配置文件以后无需停止然后重启Logstash)
第4步:启动filebeat
filebeat -e -c filebeat.yml -d "publish"
如果一切正常,你将会在Logstash控制台下看到类似这样的输出:

更多参考:Logstash
Logstash 安装配置使用的更多相关文章
- logstash 安装 配置
1.Logstash 安装:在产生日志的服务器上安装 Logstash1.安装java环境 # yum install java-1.8.0-openjdk.x86_642.安装logstash(使用 ...
- 第三篇:Logstash 安装配置
Logstash 简介: Logstash 是一个实时数据收集引擎,可收集各类型数据并对其进行分析,过滤和归纳.按照自己条件分析过滤出符合数据导入到可视化界面.Logstash 建议使用java1.8 ...
- logstash安装配置
vim /usr/local/logstash/etc/hello_search.conf 输入下面: input { stdin { type => "human" }} ...
- Elasticsearch+Kibana+Logstash安装
安装环境: [root@node- src]# cat /etc/redhat-release CentOS Linux release (Core) 安装之前关闭防火墙 firewalld 和 se ...
- ELK 架构之 Logstash 和 Filebeat 安装配置
上一篇:ELK 架构之 Elasticsearch 和 Kibana 安装配置 阅读目录: 1. 环境准备 2. 安装 Logstash 3. 配置 Logstash 4. Logstash 采集的日 ...
- ELK 架构之 Elasticsearch、Kibana、Logstash 和 Filebeat 安装配置汇总(6.2.4 版本)
相关文章: ELK 架构之 Elasticsearch 和 Kibana 安装配置 ELK 架构之 Logstash 和 Filebeat 安装配置 ELK 架构之 Logstash 和 Filebe ...
- ELk(Elasticsearch, Logstash, Kibana)的安装配置
目录 ELk(Elasticsearch, Logstash, Kibana)的安装配置 1. Elasticsearch的安装-官网 2. Kibana的安装配置-官网 3. Logstash的安装 ...
- elk集成安装配置
三台虚拟机 193,194,195 本机 78 流程 pythonserver -> nginx -> logstash_shipper->kafka->logstash_in ...
- FileBeat安装配置
在ELK中因为logstash是在jvm上跑的,资源消耗比较大,对机器的要求比较高.而Filebeat是一个轻量级的logstash-forwarder,在服务器上安装后,Filebeat可以监控日志 ...
随机推荐
- 【LEETCODE】46、999. Available Captures for Rook
package y2019.Algorithm.array; /** * @ProjectName: cutter-point * @Package: y2019.Algorithm.array * ...
- tkinter学习笔记_03
6.单选框 Radiobutton import tkinter as tk root = tk.Tk() root.title("xxx") root.geometry('2 ...
- [LOJ2002] [SDOI2017] 序列计数
题目链接 LOJ:https://loj.ac/problem/2002 洛谷:https://www.luogu.org/problemnew/show/P3702 Solution 考虑补集转换, ...
- [LOJ#3119][Luogu5405][CTS2019]氪金手游(DP+容斥)
先考虑外向树的做法,显然一个点在其子树内第一个出现的概率等于它的权值除以它子树的权值和.于是f[i][j]表示i的子树的权值和为j时,i子树内所有数的相互顺序都满足条件的概率,转移直接做一个背包卷积即 ...
- Spring Cloud Alibaba学习笔记(19) - Spring Cloud Gateway 自定义过滤器工厂
在前文中,我们介绍了Spring Cloud Gateway内置了一系列的内置过滤器工厂,若Spring Cloud Gateway内置的过滤器工厂无法满足我们的业务需求,那么此时就需要自定义自己的过 ...
- Java 哈希表
public int firstUniqChar(String s){ int[] freq=new int[26]; for(int i=0;i<s.length();i++){ freq[s ...
- vmware下的linux没有网络问题解决思路
这里几天一直在搞vm下的linux主机的网络问题,这里做个总结 这里使用的NAT连接方式 1.首先保证本机联网正常 2.检查虚拟机相应的服务(VMware NET Service 和 VMware W ...
- python3-使用requests模拟登录网易云音乐
# -*- coding: utf-8 -*- from Crypto.Cipher import AES import base64 import random import codecs impo ...
- 【转载】C#使用Math.Ceiling方法对计算结果向上取整操作
在C#的数值运算中,有时候需要对计算结果进行向上取整操作,支持设定结算结果的有效位数,Math.Ceiling方法是C#中专门用来对数值进行向上取整的方法,此方法和Math.Round方法.Math. ...
- 【雅思】【绿宝书错词本】List37~48
List 37 ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ List 38 ❤ ❤ ❤ ❤ ❤ ❤ ❤ ❤ ❤ ❤ ❤ ❤ ❤ ❤ ❤ List 39 ✔ ✔ ✔ ✔ ✔ ✔ ✔ ✔ ...