
python的深浅拷贝以及fromkeys的用法
1.join()的用法:使用前面的字符串.对后面的列表进行拼接,拼接结果是一个字符串
# lst = ["alex","dsb",'wusir','xsb']

# s = "".join(lst)

# print(s)  #alexdsbwusirxsb
2.
split() 根据你给的参数进行切割,切割的结果就是列表
需要把字符串转换成列表 split
把列表转化为字符串 join
# s = "alex_dsb_wusir_xsb"

# lst = s.split("_") #列表

# print(lst)
3.join的迭代拼接
# print("*".join("周润发")) #用迭代的方式进行拼接

# #周*润*发
4.删除操作
# lst = ["篮球","排球","乒乓球","足球","电子竞技","台球"]

# for el in lst:

#     lst.remove(el)

# print(lst)#['排球', '足球', '台球']
  会发现删不干净 原因是:删除一个.元素的索引重新排序,for循环向后走一个,就漏掉一个
删掉了索引是0的元素,然后索引是1的元素补充到索引为0的位置上,然后索引指向1,
就漏掉了以前的索引为1的元素 因为索引为一的元素在第二次循环的时候已经掉到了索引0的位置
正确的删除操作:
#lst = ["篮球","排球","乒乓球","足球","电子竞技","台球"]
# for i in range(len(lst)):  #0,1,2,3,4

#     lst.pop(0)

# print(lst) #[]  #永远删索引是0元素

# for i in range(len(lst)):

#     lst.pop()

# print(lst)  #[] #从最后一个删
最合理的删除方法:
1,先把需要删除的元素写在一个新的列表中
2.循环这个新列表,删除老列表
5.fromkeys()用法
 fromkeys() 帮我们创建字典用
# 把第一个参数进行迭代 拿到的每一项作为key和后面的value组成字典
# d = dict.fromkeys("张无忌","赵敏") #创建字典

# print(d)#{'张': '赵敏', '无': '赵敏', '忌': '赵敏'}
坑 1
# 返回新字典,和原来的字典没有关系
# dic = {}

# d = dic.fromkeys("风扇哥","很困")

# print(dic)# {}

# print(d)#{'风': '很困', '扇': '很困', '哥': '很困'}
# 坑2
# 如果value是可变的数据类型,
# 那么其中一个key对应的value执行更改操作,其他的也跟着改变
d = dict.fromkeys("胡辣汤",[])

print(d)#{'胡': [], '辣': [], '汤': []}

# print(id(d["胡"]))#1797375051912

# print(id(d["辣"]))#1797375051912

# print(id(d["汤"]))#1797375051912

#说明这几个还是同一个[]  所以对其中一个进行改变别的也进行相应的改变

# d["胡"] .append("湖南特色")

# print(d)#{'胡': ['湖南特色'], '辣': ['湖南特色'], '汤': ['湖南特色']}
6.深浅拷贝
先来看一下这个问题
从上到下只有一个列表创建
# lst1 = ["胡辣汤","麻辣香锅","灌汤包","油泼面"]

# lst2 = lst1 #并没有产生新对象.只是一个指向(内存地址)的赋值

# print(id(lst1))#2253612239048

# print(id(lst2))#2253612239048
# lst1.append("葫芦娃")
# print(lst1)#['胡辣汤', '麻辣香锅', '灌汤包', '油泼面', '葫芦娃']
# print(lst2)#['胡辣汤', '麻辣香锅', '灌汤包', '油泼面', '葫芦娃']
用图来解释

# lst1 = ["胡辣汤","麻辣香锅","灌汤包","油泼面"]

# lst2 = lst1.copy() #拷贝,抄作业,可以帮我们创建新的对象,和原来一模一样,浅拷贝

# print(id(lst1))#2232732993736

# print(id(lst2))#2232732993672

#

# lst1.append("葫芦娃")

# print(lst1)

# print(lst2)
用图来解释

# lst1 = ["胡辣汤", "灌汤包", "油泼面", "麻辣香锅", ["长白山", "白洋淀", "黄鹤楼"]]

# lst2 = lst1.copy() #浅拷贝,只拷贝第一层内容

#

# print(id(lst1))#1199044806792

# print(id(lst2))#1199044806984

# print(lst1)

# print(lst2)

#

# lst1[4].append("葫芦娃")

# print(lst1)

# print(lst2)
用图来解释

#深拷贝  需要引入一个模块
import copy

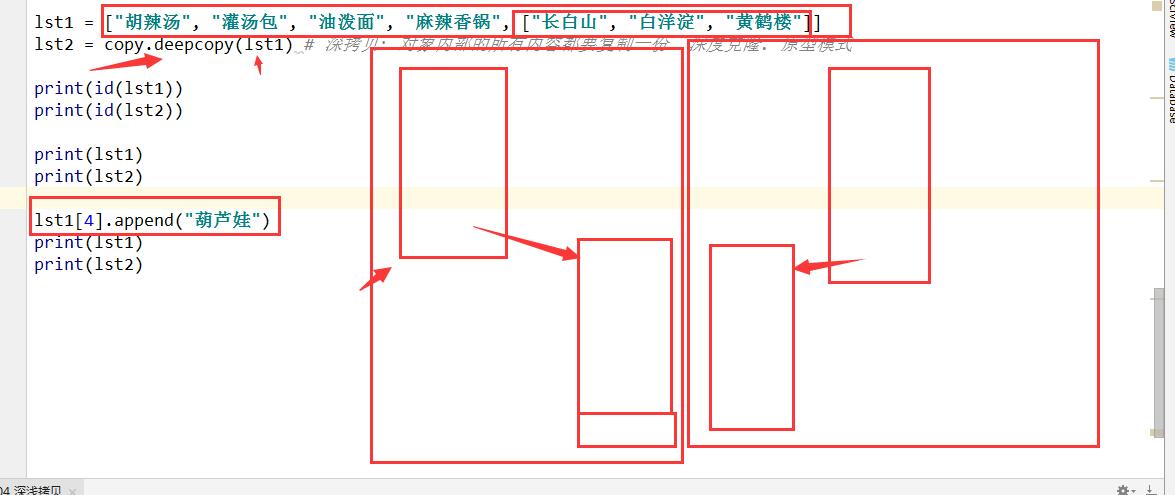
lst1 = ["胡辣汤", "灌汤包", "油泼面", "麻辣香锅", ["长白山", "白洋淀", "黄鹤楼"]]
lst2 = copy.deepcopy(lst1)#深拷贝 对象内部的所有内容都要复制一份.深度克隆 原型模式
print(id(lst1))#2150506176840
print(id(lst2))#2150506178120

print(lst1)#['胡辣汤', '灌汤包', '油泼面', '麻辣香锅', ['长白山', '白洋淀', '黄鹤楼']]
print(lst2)#['胡辣汤', '灌汤包', '油泼面', '麻辣香锅', ['长白山', '白洋淀', '黄鹤楼']]
lst1[4].append("葫芦娃")
print(lst1)#['胡辣汤', '灌汤包', '油泼面', '麻辣香锅', ['长白山', '白洋淀', '黄鹤楼', '葫芦娃']]
print(lst2)#['胡辣汤', '灌汤包', '油泼面', '麻辣香锅', ['长白山', '白洋淀', '黄鹤楼']]

用图来解释
为什么要有深浅拷贝?
提高创建速度  计算机中最慢的就是创建对象,需要分配内存各种事情
最快的方式就是以二进制流的方式进行复制 速度最快
python的深浅拷贝以及fromkeys的用法的更多相关文章
- Python原理 -- 深浅拷贝
python原理 -- 深浅拷贝 从数据类型说开去 str, num : 一次性创建, 不能被修改, 修改即是再创建. list,tuple,dict,set : 链表,当前元素记录, 下一个元素的位 ...
- Python的深浅拷贝
Python的深浅拷贝 深浅拷贝 1. 赋值,对于list, set, dict来说, 直接赋值. 其实是把内存地址交给变量并不是复制一份内容 list1 = [']] list2 = list1 p ...
- 24、简述Python的深浅拷贝以及应用场景
深浅拷贝的原理 深浅拷贝用法来自copy模块. 导入模块:import copy 浅拷贝:copy.copy 深拷贝:copy.deepcopy 字面理解:浅拷贝指仅仅拷贝数据集合的第一层数据,深拷贝 ...
- Python入门-深浅拷贝
首先我们在这里先补充一下基础数据类型的一些知识: 一.循环删除 1.前面我们学了列表,字典和集合的一些操作方法:增删改查,现在我们来看一下这个问题: 有这样一个列表: lst = ['周杰伦','周润 ...
- day2学python 数据类型+深浅拷贝+循环
数据类型+深浅拷贝+循环 别的语言的数组 python不用定义 直接使用 color=['红','橙','黄','绿','青','蓝','紫'] print(color[1:3]) //打印[1,3) ...
- 简述Python的深浅拷贝以及应用场景
深浅拷贝的原理 深浅拷贝用法来自copy模块. 导入模块:import copy 浅拷贝:copy.copy 深拷贝:copy.deepcopy 字面理解:浅拷贝指仅仅拷贝数据集合的第一层数据,深拷贝 ...
- python 赋值 深浅拷贝
深浅拷贝 一.数字和字符串 对于 数字 和 字符串 而言,赋值.浅拷贝和深拷贝无意义,因为其永远指向同一个内存地址. 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 impor ...
- Python随笔---深浅拷贝
Python中为了避免某些方法的副作用(拷贝后有时更改原有数据),故存在有深浅拷贝的存在 浅拷贝导入copy方法集,使用copy_copy的方法进行 深拷贝一样导入copy方法集,使用copy_dee ...
- python 的深浅拷贝问题
深浅拷贝概念 基本类型和引用类型数据拷贝的问题.因为基本类型的数据大小是固定的,所以他保存在栈内存中:而引用类型的数据大小不固定,因而保存在堆内存中,单引用类型在栈内存中只保存一个指向堆内存的指针. ...
随机推荐
- spring IOC理解
用spring做了几个项目后发现,对spring的IOC理解还是不够清晰,今天就来总结下自己的理解(个人的一些见解) 以前用jsp+servlet做网站时,只是分了显示层(jsp),控制层(servl ...
- 【xsy1130】tree 树形dp+期望dp
题目写得不清不楚的... 题目大意:给你一棵$n$个节点的树,你会随机选择其中一个点作为根,随后随机每个点深度遍历其孩子的顺序. 下面给你一个点集$S$,问你遍历完$S$中所有点的期望时间,点集S中的 ...
- Python数据结构:栈 队列
栈,队列的特性: 1.栈(stacks)是一种只能通过访问其一端来实现数据存储与检索的线性数据结构,具有后进先出(last in first out,LIFO)的特征 2.队列(queue)是一种具有 ...
- 解决Navicat Premium终端操作mysql ONLY_FULL_GROUP_BY错误
解决navicate终端操作mysql ONLY_FULL_GROUP_BY错误 问题描述: [Err] 1055 - Expression #1 of SELECT list is not ...
- [Error] 'exit' was not declared in this scope的解决方法
新手刚开始用Linux和c++写程序,可能会出现下面的错误 error: ‘exit’ was not declared in this scope 解决方法是 添加 #include <cst ...
- 把 Elasticsearch 当数据库使:聚合后排序
使用 https://github.com/taowen/es-monitor 可以用 SQL 进行 elasticsearch 的查询.有的时候分桶聚合之后会产生很多的桶,我们只对其中部分的桶关心. ...
- VS2013编译的exe独立运行在XP中方案
转载知乎 现在,我们深入探讨一下:<如何使用VS 2013发布一个可以在Windows XP中独立运行的可执行文件>. 这个问题是比较常见且容易造成初学者困惑的,作为曾经撞了无数次南墙的初 ...
- ASP.NET MVC View中的标签(tag)
在编辑View的时候会用到各种HTML标签,如<a>,<input>,<p>等待,这些标签在ASP.NET MVC中都有对应的编程语法,它叫Razor,它是帮助我们 ...
- Cglib invoke以及invokeSuper的一点区别
简单记录下,解决的一个问题,Cglib的invoke和invokeSuper的区别: 简而言之,invoke方法调用的对象没有增强过,invokeSuper方法调用的对象已经是增强了的,所以会再走一遍 ...
- 读jQuery源码释疑笔记3
1.在jQuery.fn=jQuery.prototype中定义了方法:init, map, each , toArray, get, pushStack, ready, slice,first ...