
spark work目录处理 And HDFS空间都去哪了?
1、说在前面
过完今天就放假回家了(挺高兴),于是提前检查了下个服务集群的状况,一切良好。正在我想着回家的时候突然发现手机上一连串的告警,spark任务执行失败,spark空间不足。我的心突然颤抖了一下,于是赶紧去看服务器的磁盘容量:
#df -h
确实,还剩下6.8G,赶紧排查是什么占用了空间。发现hadoop、spark站的空间比较大,一个50多G(data)、一个30多G(spark-events)。不对啊,这也没占多少啊,于是登录到hadoop的webui去看资源的使用情况:
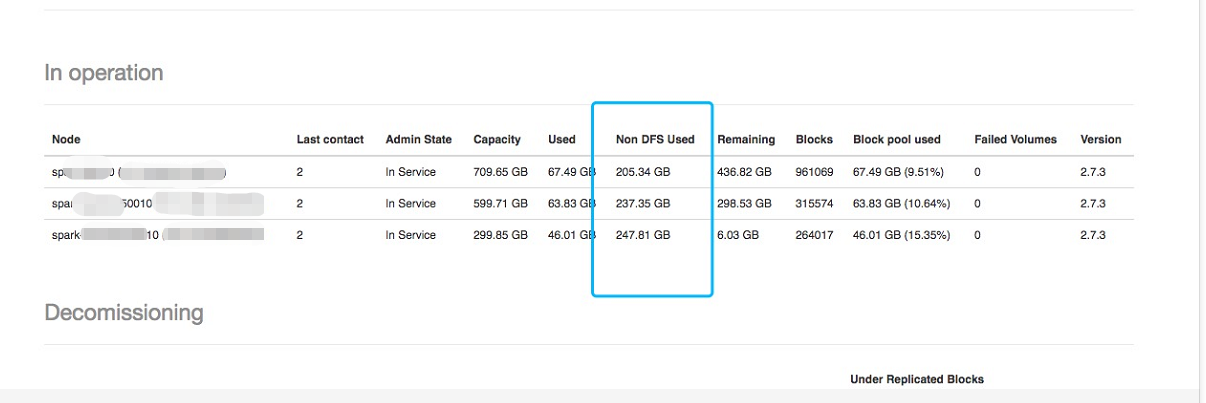
发现Non DFS Used的值很大,接下来就是名词解释时间:
Capacity:可用的总空间
Used:已用的空间
Non DFS Used:非hdfs文件占用dfs的空间(侵占)
Remaining:剩余可用空间
发现Non DFS Used的值都很大,证明有很多的非hdfs文件侵占了大量的dfs空间。可以看到其中有一个加点只剩6.03G了。这个总空间的大小默认就是磁盘的大小,不过hadoop有个磁盘的配置项dfs.datanode.du.reserved,这个配置是设置hadoop保留一部分不用于hdfs存储的空间默认是0。
2、好了,明白这个后,开始去排查到底是什么文件侵占了dfs的空间。看了一下服务器上面部署的服务,有spark、hadoop(hdfs)、presto,如果是对大数据相对熟悉的人第一判断应该是spark,首先想到的是spark work和spark-events,检查是否运行了history。简单科普一下,spark work存放的是一个spark work任务运行的依赖环境和日志输出,集群其他的节点都来这个地方拉取,spark-events存放的是运行日志,history web就是去的这里的数据。经检查发现是work,已经201G了。
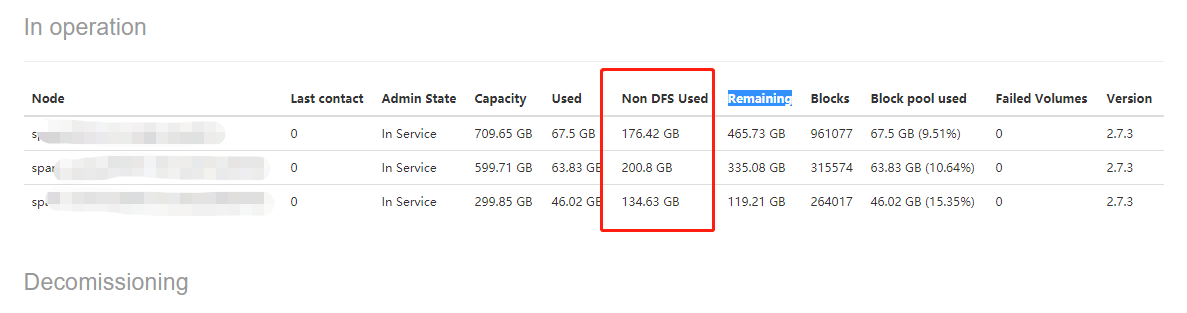
使用spark standalone模式执行任务,每提交一次任务,在每个节点work目录下都会生成一个文件夹,命名规则app-20180212191730-0249。该文件夹下是任务提交时,各节点从主节点下载的程序所需要的资源文件。 这些目录每次执行都会生成,且不会自动清理,执行任务过多会将内存撑爆。将历史没用的work目录下面的app目录删除:
3、解决方案
需要添加定时清理策略,只针对于standalong模式:
在spark-env.sh里面添加如下配置
-Dspark.worker.cleanup.interval=1800:清理周期,每隔多长时间清理一次,单位秒
-Dspark.worker.cleanup.appDataTtl=3600:保留最近多长时间的数据
spark work目录处理 And HDFS空间都去哪了?的更多相关文章
- du 命令,对文件和目录磁盘使用的空间的查看
Linux du命令也是查看使用空间的,但是与df命令不同的是Linux du命令是对文件和目录磁盘使用的空间的查看,还是和df命令有一些区别的. 1.命令格式: du [选项][文件] 2.命令功能 ...
- hadoop进阶---hadoop性能优化(一)---hdfs空间不足的管理优化
Hadoop 空间不足,hive首先就会没法跑了,进度始终是0%. 将HDFS备份数降低 将默认的备份数3设置为2. 步骤:CDH–>HDFS–>配置–>搜索dfs.replicat ...
- Flume实时监控目录sink到hdfs,再用sparkStreaming监控hdfs的这个目录,对数据进行计算
目标:Flume实时监控目录sink到hdfs,再用sparkStreaming监控hdfs的这个目录,对数据进行计算 1.flume的配置,配置spoolDirSource_hdfsSink.pro ...
- 泛函p121可分Hilbert空间都同构于l^2
如何理解最后面两句话, L^2与l^2同构 L^2里面 有理系数多项式 是可数稠密子集 所以L^2可分 可分Hilbert空间都同构于 l^2 傅里叶级数是一个稠密的子集
- du---是对文件和目录磁盘使用的空间查看
du命令也是查看使用空间的,但是与df命令不同的是Linux du命令是对文件和目录磁盘使用的空间的查看,还是和df命令有一些区别的. 语法 du [选项][文件] 选项 -a或-all 显示目录中个 ...
- linux中root目录下下指定磁盘空间扩容
1 查看当前磁盘情况 fdisk -l /dev/sda1 2048 6143 2048 83 Linux /dev/sda2 * 6144 1054719 524288 83 Linux /dev/ ...
- Redis内存——内存消耗(内存都去哪了?)
最新:Redis内存--三个重要的缓冲区 最新:Redis内存--内存消耗(内存都去哪了?) 最新:Redis持久化--如何选择合适的持久化方式 最新:Redis持久化--AOF日志 更多文章... ...
- MySQL 中删除的数据都去哪儿了?
不知道大家有没有想过下面这件事? 我们平时调用 DELETE 在 MySQL 中删除的数据都去哪儿了? 这还用问吗?当然是被删除了啊 那么这里又有个新的问题了,如果在 InnoDB 下,多事务并发的情 ...
- from表单上提交的数据都去了哪里呢?
from表单上提交的数据都去了哪里呢? 一个简单的from案例如下: <form> 姓名:<br> <input type="text" name=& ...
随机推荐
- 封装了三个对TMemoryStream操作的函数,大牛莫笑
// TMemoryStream 转化为string字符串 function MemoryStreamToString(M: TMemoryStream): AnsiString; begin Set ...
- CentOS 7配置nginx-1.13.10支持http/2和Server Push
0.确保openssl版本大于1.0.2 openssl version 1.下载nginx-1.13.10 wget http://nginx.org/download/nginx-1.13.10. ...
- [leetcode.com]算法题目 - Restore IP Addresses
Given a string containing only digits, restore it by returning all possible valid IP address combina ...
- SAP接口的调用
最近做一个专案用到的SAO接口的调用,用到的上传参数获取回传的IRfcTable,以及以IRfcTable作为参数上传SAP,通过查阅很多资料,发现资料说明的也多是鱼龙混杂,许多没有实现就直接贴在上面 ...
- 浏览器标识ua
# LinuxLinux / Firefox 29: Mozilla/5.0 (X11; Linux x86_64; rv:29.0) Gecko/20100101 Firefox/29.0Linux ...
- [JavaWeb] Servlet Filter
作用: Servlet 过滤器可以动态地拦截请求和响应,以变换或使用包含在请求或响应中的信息. 可以将一个或多个 Servlet 过滤器附加到一个 Servlet 或一组 Servlet.Servle ...
- HDFS概要
--HDFS-- Hadoop Distributed File System HDFS一个分布式,高容错,可线性扩展的文件系统 简介: Hadoop分布式文件系统(HDFS)是一种分布式文件系统,设 ...
- [工具]渗透神器CobaltStrike 3.1.2 K8去后门破解版 & Windows版TeamServer
CS简介 Cobalt Strike(简称CS)是全球黑客公认一款非常优秀的渗透测试神器,以metasploit为基础的GUI的框架式渗透工具,集成了传统远控功能(远程桌面VNC.键盘记录.CmdSh ...
- jquery中的ajax请求,阻塞ui线程的解决方案(自己总结的demo)
/*****************************************************/ function getAjaxData(url,data){ showLoading( ...
- (转)Python异常类的继承关系
原文:https://blog.csdn.net/Dragonfli_Lee/article/details/52350793 https://www.cnblogs.com/Lival/p/6203 ...