
Eureka源码分析:Eureka不会进行二次Replication的原因
Eureka不会进行二次同步注册信息
Eureka会将本实例中的注册信息同步到它的peer节点上,这是我们都知道的特性。然而,当peer节点收到同步数据后,并不会将这些信息再同步到它自己的peer节点上。如果有A, B, C三个实例,A配B, B配C, C配A, 那么当向A注册一个新服务时,只有A, B两个Eureka实例会有新服务的注册信息,C是没有的。这一点在官方wiki上并没有明确说明。下面通过源码来查找一下原因。
构建
Eureka当前版本 (https://github.com/Netflix/eureka) 使用gradle作为构建工具,不过Git仓库里提供了gradlew,所以也不用我们自己去下载。如果自己下载了gradle的最新版本3.X,那么反而会因为兼容性问题导致构建失败,因为官方使用的是2.1.0版本。构建之前一定要科学上网,否则很多依赖是下载不到的:
./gradlew build -x test // 跳过测试源码定位与分析
Eureka本质上是一个Servlet应用,它使用jersey作为RESTful框架来构造自己的REST服务。在eureka-server模块中可以找到web.xml文件,在build/libs目录下可以看到构建完成后生成的war包。我们要找的代码,在eureka-core模块的com.netflix.eureka.resource包下。jersey相比SpringMVC来说它是一个更加标准的HTTP RESTful框架,因此很自然可以猜想到resource就是请求路由所在的包。
查阅官方wiki, 我们知道eureka对外暴露接口的形式为:
GET/POST/PUT/DELETE /eureka/v2/apps/{APP-ID}我们在ApplicationsResource类中可以发现如下注解:
@Path("/{version}/apps")

@Produces({"application/xml", "application/json"})

public class ApplicationsResource {

    // ... ...

}
由此可以确定该类就是我们要找的重点。查阅该类,会发现有如下方法:
/**

     * Gets information about a particular {@link com.netflix.discovery.shared.Application}.

     *

     * @param version

     *            the version of the request.

     * @param appId

     *            the unique application identifier (which is the name) of the

     *            application.

     * @return information about a particular application.

     */

    @Path("{appId}")

    public ApplicationResource getApplicationResource(

            @PathParam("version") String version,

            @PathParam("appId") String appId) {

        CurrentRequestVersion.set(Version.toEnum(version));

        return new ApplicationResource(appId, serverConfig, registry); // 交给ApplicationResource处理

}通过注释得知该方法用来处理客户端查询某个服务信息的HTTP请求。但是方法体中并没有具体的查询逻辑,而是委托给了ApplicationReource类进行处理。查阅该类,可以发现注册信息的CRUD操作逻辑都是在这里实现的。我们重点关注一下注册方法,因为Eureka在收到新服务的注册信息时会马上将其同步到peer节点中:
@POST

    @Consumes({"application/json", "application/xml"})

    public Response addInstance(InstanceInfo info,

                                @HeaderParam(PeerEurekaNode.HEADER_REPLICATION) String isReplication) {

        logger.debug("Registering instance {} (replication={})", info.getId(), isReplication);

        // validate that the instanceinfo contains all the necessary required fields

        // 参数检查 ...

        // 调用注册逻辑

        registry.register(info, "true".equals(isReplication));

        return Response.status(204).build();  // 204 to be backwards compatible

}注意register的第二个参数:
"true".equals(isReplication)isReplication是从请求头中获取的字符串,因此可以得知,Eureka在向peer节点发送同步请求时会在请求头中携带自定义的x-netflix-discovery-replication头:
public static final String HEADER_REPLICATION = "x-netflix-discovery-replication";peer节点通过该请求头来判断当前请求是其它Eureka节点的同步请求还是服务的注册请求。我们假定当前请求是上一个Eureka发来的同步请求,那么这里第二个参数的值应该为true。
继续看register()方法,这是个PeerAwareInstanceRegistry接口的接口方法,该接口只有一个唯一实现PeerAwareInstanceRegistryImpl:
/**

     * Registers the information about the {@link InstanceInfo} and replicates

     * this information to all peer eureka nodes. If this is replication event

     * from other replica nodes then it is not replicated.

     *

     * @param info

     *            the {@link InstanceInfo} to be registered and replicated.

     * @param isReplication

     *            true if this is a replication event from other replica nodes,

     *            false otherwise.

     */

    @Override

    public void register(final InstanceInfo info, final boolean isReplication) {

        int leaseDuration = Lease.DEFAULT_DURATION_IN_SECS;

        if (info.getLeaseInfo() != null && info.getLeaseInfo().getDurationInSecs() > 0) {

            leaseDuration = info.getLeaseInfo().getDurationInSecs();

        }

        // 调用父类的实现执行注册逻辑

        super.register(info, leaseDuration, isReplication);

        // 将该注册请求同步到peer节点中

        replicateToPeers(Action.Register, info.getAppName(), info.getId(), info, null, isReplication);

}首先通过英文注释可以了解到,如果当前注册请求是一个Replication请求,那么该注册请求不会被再次Replicate到下一个peer节点中。我们进入到关键的replicateToPeers()方法中看看为什么不会被同步:
private void replicateToPeers(Action action, String appName, String id,

                                  InstanceInfo info /* optional */,

                                  InstanceStatus newStatus /* optional */, boolean isReplication) {

        Stopwatch tracer = action.getTimer().start();

        try {

            // ... ...

            // If it is a replication already, do not replicate again as this will create a poison replication

            // 如果 isReplication 为true, 即当前是个同步注册信息的请求

            // 这里就直接返回了

            if (peerEurekaNodes == Collections.EMPTY_LIST || isReplication) {

                return;

            }

            // 向自己的peer节点同步注册信息

            for (final PeerEurekaNode node : peerEurekaNodes.getPeerEurekaNodes()) {

                // If the url represents this host, do not replicate to yourself.

                if (peerEurekaNodes.isThisMyUrl(node.getServiceUrl())) {

                    continue;

                }

                replicateInstanceActionsToPeers(action, appName, id, info, newStatus, node);

            }

        } finally {

            tracer.stop();

        }

    }
可以看到下面的代码
if (peerEurekaNodes == Collections.EMPTY_LIST || isReplication) {

    return;

}
就是Eureka不进行二次Replication的原因,如果当前请求是从其他Eureka发来的同步请求,那么该方法就直接返回了,不再执行后面的同步逻辑。
结论
通过上面的追踪我们确认了Eureka不进行二次同步是作者有意而为之,并不是bug。但是官方wiki上并没有明确写明这一点,文档并不太完善。可以考虑提一个Issue提醒一下开发组。
http://blog.csdn.net/neosmith/article/details/52912645
Eureka注册不了,如果查看是否是因为注册的Eureka服务器不对。
解决办法:
com.sun.jersey.client.apache4.ApacheHttpClient4Handler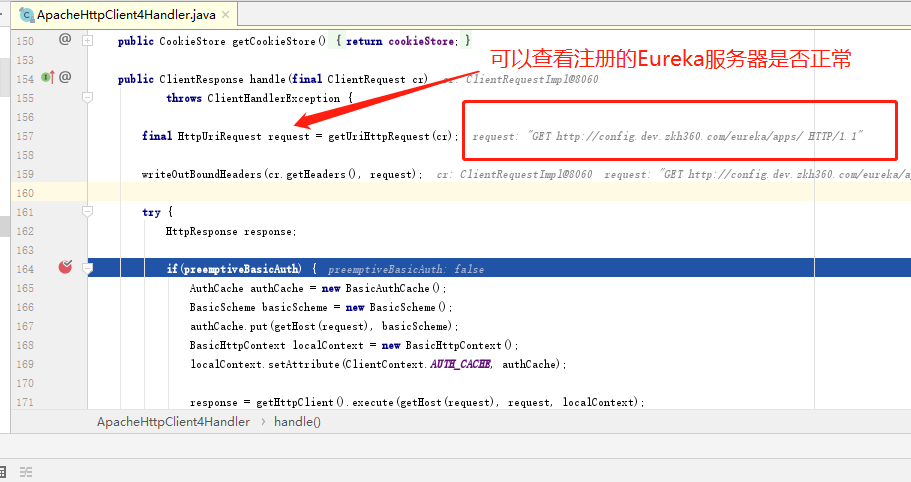
Eureka源码分析:Eureka不会进行二次Replication的原因的更多相关文章
- Eureka 源码分析之 Eureka Server
文章首发于公众号<程序员果果> 地址 : https://mp.weixin.qq.com/s/FfJrAGQuHyVrsedtbr0Ihw 简介 上一篇文章<Eureka 源码分析 ...
- Solr4.8.0源码分析(19)之缓存机制(二)
Solr4.8.0源码分析(19)之缓存机制(二) 前文<Solr4.8.0源码分析(18)之缓存机制(一)>介绍了Solr缓存的生命周期,重点介绍了Solr缓存的warn过程.本节将更深 ...
- 深入源码分析SpringMVC底层原理(二)
原文链接:深入源码分析SpringMVC底层原理(二) 文章目录 深入分析SpringMVC请求处理过程 1. DispatcherServlet处理请求 1.1 寻找Handler 1.2 没有找到 ...
- JUC源码分析-线程池篇(二)FutureTask
JUC源码分析-线程池篇(二)FutureTask JDK5 之后提供了 Callable 和 Future 接口,通过它们就可以在任务执行完毕之后得到任务的执行结果.本文从源代码角度分析下具体的实现 ...
- Spring Ioc源码分析系列--Bean实例化过程(二)
Spring Ioc源码分析系列--Bean实例化过程(二) 前言 上篇文章Spring Ioc源码分析系列--Bean实例化过程(一)简单分析了getBean()方法,还记得分析了什么吗?不记得了才 ...
- 微服务之SpringCloud实战(四):SpringCloud Eureka源码分析
Eureka源码解析: 搭建Eureka服务的时候,我们会再SpringBoot启动类加上@EnableEurekaServer的注解,这个注解做了一些什么,我们一起来看. 点进@EnableEure ...
- Eureka 源码分析之 Eureka Client
文章首发于微信公众号<程序员果果> 地址:https://mp.weixin.qq.com/s/47TUd96NMz67_PCDyvyInQ 简介 Eureka是一种基于REST(Repr ...
- Eureka源码分析
源码流程图 先上图,不太清晰,抱歉 一.Eureka Server源码分析 从@EnableEurekaServer注解为入口,它是一个标记注解,点进去看 注解内容如下 /** * 激活Eureka服 ...
- 【SpringCloud技术专题】「Eureka源码分析」从源码层面让你认识Eureka工作流程和运作机制(上)
前言介绍 了解到了SpringCloud,大家都应该知道注册中心,而对于我们从过去到现在,SpringCloud中用的最多的注册中心就是Eureka了,所以深入Eureka的原理和源码,接下来我们要进 ...
随机推荐
- 【Qt编程】基于Qt的词典开发系列<十二>调用讲述人
我们知道,win7系统自带有讲述人,即可以机器读出当前内容,具体可以将电脑锁定,然后点击左下角的按钮即可.之前在用Matlab写扫雷游戏的时候,也曾经调用过讲述人来进行游戏的语音提示.具体的Matla ...
- android studio比较长用的几款插件
不懂安装studio插件,看参考博文:android stuido插件安装:http://blog.csdn.net/liang5630/article/details/46372447 1.Butt ...
- 面试之路(27)-链表中倒数第K个结点
代码的鲁棒性: 所谓的鲁棒性是指能够判断输入是否合乎规范,能对不和规范的程序进行处理. 容错性是鲁棒性的一个重要体现. 防御性编程有助于提高鲁棒性. 切入正题,我可不是标题党: 链表倒数第k个节点 列 ...
- ruby抓取web页面
一种方法是Net::HTTP.new方法,返回resp码和实际的data: require 'net/http' h = Net::HTTP.new("www.baidu.com" ...
- ES6之let命令
ES6新增了let命令,用来声明变量.它的用法类似于var. let和var声明变量的区别: 1.let声明的变量,只在let命令所在的代码块内有效,出了这个块级作用域就不起作用 先看一个例子: { ...
- javaScript(1)---概述
javaScript(1)---概述 学习要点: 1.什么是JavaScript 2.JavaScript特点 3.JavaScript历史 4.JavaScript核心 JavaScript诞生于1 ...
- 掌握 Java 泛型类型(一)
为理解泛型类型为何如此有用,我们要将注意力转向 Java 语言中最容易引发错误的因素之一 - 需要不断地将表达式向下类型转换(downcast)为比其静态类型更为具体的数据类型(请参阅参考资料中的&q ...
- #cat /proc/meminfo 详解
$cat /proc/meminfoMemTotal: 2052440 kB //总内存MemFree: 50004 kB //空闲内存Buffers: ...
- CSS position 笔记+实验
目录: 1.static 2.relative 3.absolute 4.fixed 5.实验:static, relative, absolute中,父元素-子元素高度关系 6.z-index 7. ...
- 原生Eclipse下Java服务器调试的一个问题
当你对Server的配置修改以后,最好到 workspacedir\.metadata\.plugins\org.eclipse.wst.server.core\tmp0目录下把缓存文件给删除了,否则 ...