
5分钟学习spark streaming之 轻松在浏览器运行和修改Word Counts
方案一:根据官方实例,下载预编译好的版本,执行以下步骤:
- nc -lk 9999 作为实时数据源
- ./bin/run-example org.apache.spark.examples.sql.streaming.StructuredNetworkWordCount localhost 9999
- 在第一步的terminal 窗口输入一些句子
- 第二步的output 就是实时执行结果
此方案的问题有
- 探索其中的api 比较困难,比如我想试试另外一种写法,需要改源码,然后编译,时间就变长了
- 如果是一个裸机的话,需要安装好java 环境,spark和java版本之间的依赖也要特别小心
方案二(2个docker 命令,你就可以为所欲为的在浏览器里面运行,更改Word counts这个hello word了)
除去下载docker img的时间,5min没法完成以下步骤,请立即私信给我,有奖,哈哈
- docker run -p 8080:8080 --rm fancyisbest/zeppeinsparkstreaming:0.1 (第一次会花很长时间在pull img)
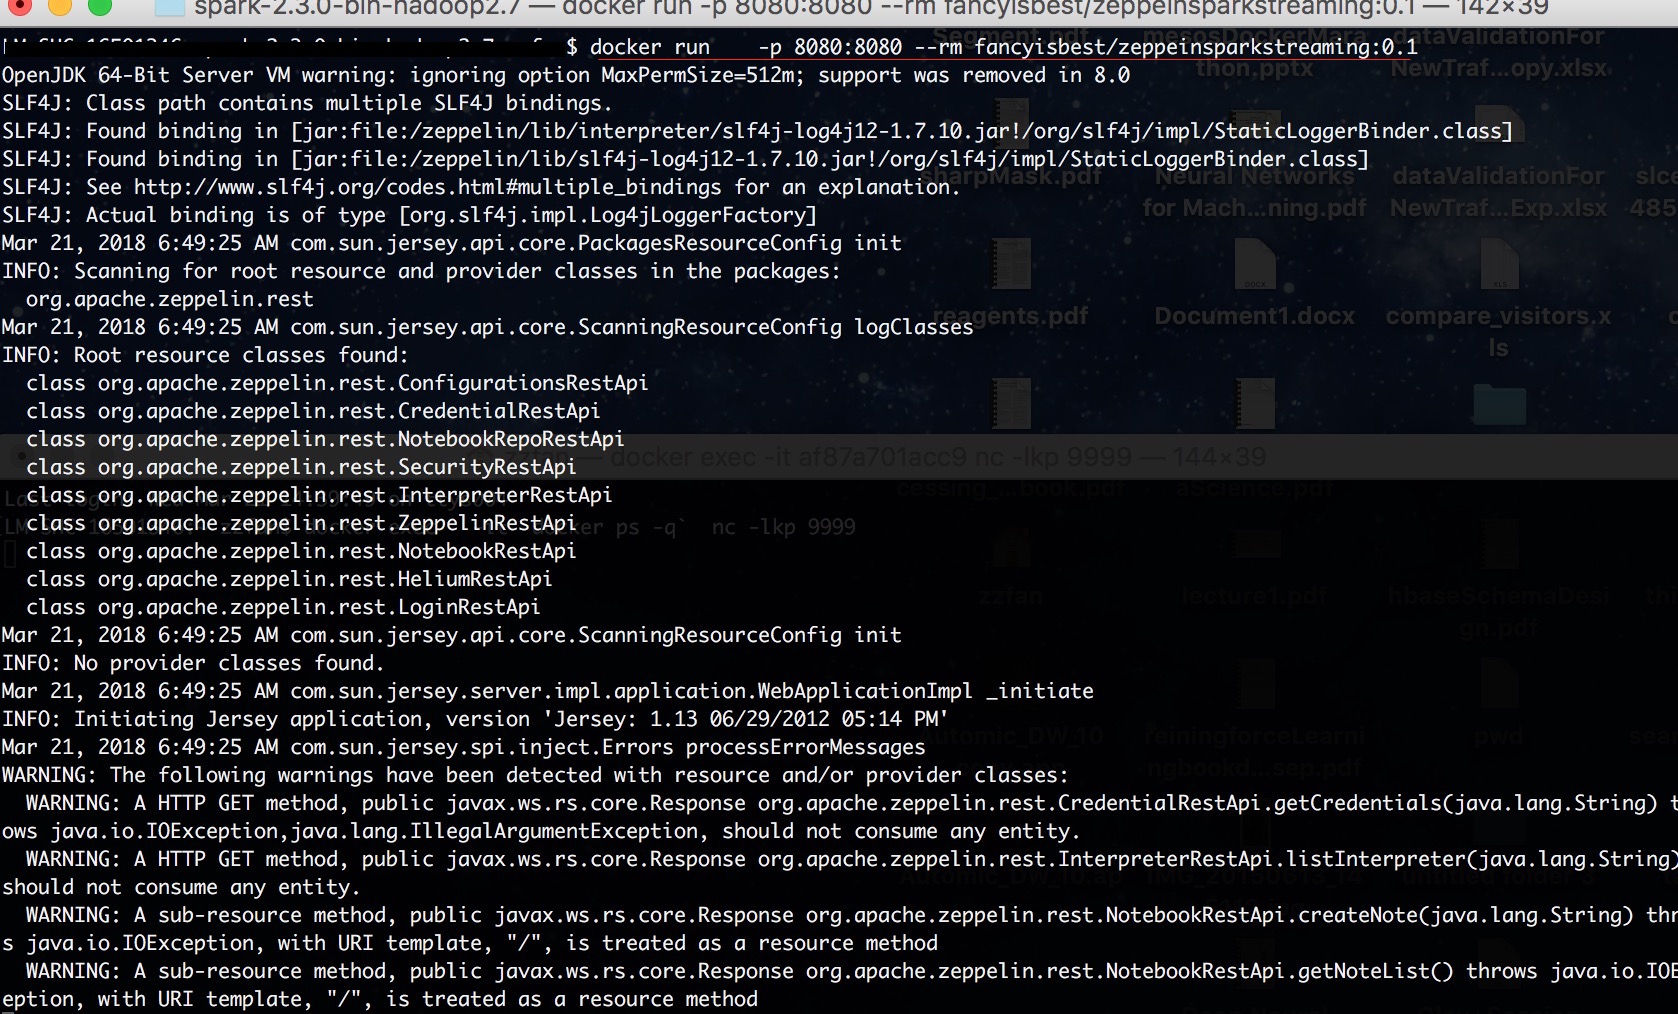
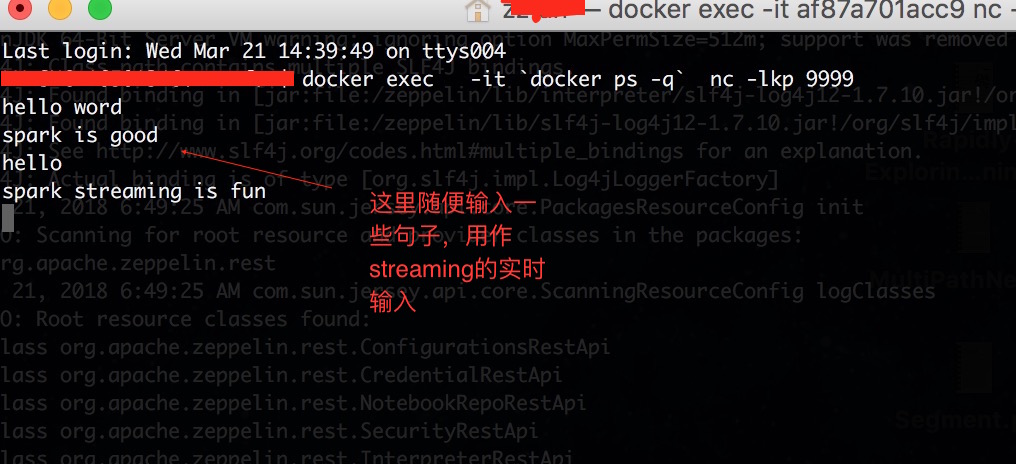
- docker exec -it `docker ps -q` nc -lkp 9999 (注意如果你有多个container在运行,请把`docker ps -q` 替换成上一个的container id)

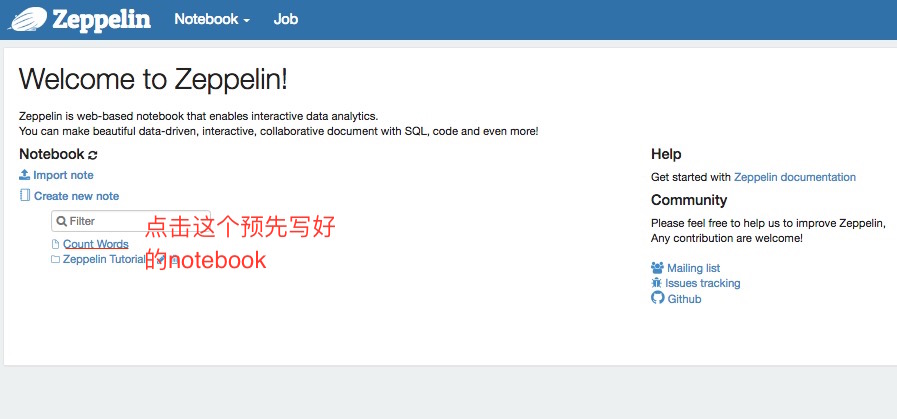
- 打开浏览器输入http://localhost:8080/#/, 左下角有Word counts,点击进入notebook,点击运行所有段落。

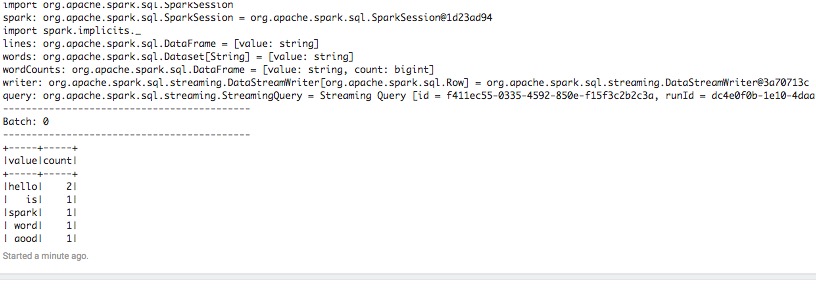
- 在第二步termial输入些句子,你就可以在notebook里面观察到streaming 在执行。
此方案的优势
- 除了docker,不需要安装任何依赖,这很dev ops
- 可以狠狠地改代码,改完就可以立即执行,不用担心会破坏任何环境,探索你的世界,你做主。
提示:
- 此方案的技术堆是:docker+zeppelin+spark
- docker img是我在zeppelin img上加入了必要的命令和notebook 打包成的img,请放心使用。
- 如果你对docker,zeppelin不熟悉,不要担心,它们都很简单,只要稍微花点时间就可以掌握,请记住我们的目标是学习spark streaming
参考:
zeppelin 官网http://zeppelin.apache.org/
5分钟学习spark streaming之 轻松在浏览器运行和修改Word Counts的更多相关文章
- 5分钟学习spark streaming 表格和图形化的文档-概览
看图回答以下问题: 1. spark streaming 架构以及功能特性 2. spark streaming mode?以及每个mode主要特性?包括延迟和语义保证.
- Dream_Spark-----Spark 定制版:005~贯通Spark Streaming流计算框架的运行源码
Spark 定制版:005~贯通Spark Streaming流计算框架的运行源码 本讲内容: a. 在线动态计算分类最热门商品案例回顾与演示 b. 基于案例贯通Spark Streaming的运 ...
- 【Streaming】30分钟概览Spark Streaming 实时计算
本文主要介绍四个问题: 什么是Spark Streaming实时计算? Spark实时计算原理流程是什么? Spark 2.X下一代实时计算框架Structured Streaming Spark S ...
- 基于案例贯通 Spark Streaming 流计算框架的运行源码
本期内容 : Spark Streaming+Spark SQL案例展示 基于案例贯穿Spark Streaming的运行源码 一. 案例代码阐述 : 在线动态计算电商中不同类别中最热门的商品排名,例 ...
- 5.Spark Streaming流计算框架的运行流程源码分析2
1 spark streaming 程序代码实例 代码如下: object OnlineTheTop3ItemForEachCategory2DB { def main(args: Array[Str ...
- 贯通Spark Streaming流计算框架的运行源码
本章节内容: 一.在线动态计算分类最热门商品案例回顾 二.基于案例贯通Spark Streaming的运行源码 先看代码(源码场景:用户.用户的商品.商品的点击量排名,按商品.其点击量排名前三): p ...
- Spark Streaming概念学习系列之SparkStreaming运行原理
SparkStreaming运行原理 Spark Streaming不断的从数据源获取数据(连续的数据流),并将这些数据按照周期划分为batch. Spark Streaming将每个batch的数据 ...
- spark streaming 接收kafka消息之四 -- 运行在 worker 上的 receiver
使用分布式receiver来获取数据使用 WAL 来实现 exactly-once 操作: conf.set("spark.streaming.receiver.writeAheadLog. ...
- Spark Streaming:大规模流式数据处理的新贵(转)
原文链接:Spark Streaming:大规模流式数据处理的新贵 摘要:Spark Streaming是大规模流式数据处理的新贵,将流式计算分解成一系列短小的批处理作业.本文阐释了Spark Str ...
随机推荐
- UVA - 10723 类似LCS
思路:dp(i, j)表示第一个串前i个字符和第二个串前j个字符需要的最短字符串长度,cnt(i, j)表示第一个串前i个字符和第二个串前j个字符需要的最短字符串的个数. 转移方程: if(s1[i] ...
- Zookeeper笔记1-CAP/BASE理论
分布式系统八大谬论: 1.网络相当可靠 2.延迟为0 3.传输带宽是无限的 4.网络相当安全. 5.拓扑结构不会改变 6.必须要有一名管理员 7.传输成本为0 8.网络同质化. 分布式最常出现的问题: ...
- 后台模拟请求 HttpHelper 序列化 MD5 时间戳
使用场景 C# 服务器后台调用其他服务器并处理 场景 /// <summary> /// 获取用户信息 /// </summary> /// <param name=&q ...
- 【java学习笔记】正则表达式
一.正则表达式 1.预定义字符集 . 表示任意一个字符 \d 表示任意一个数字 \w 表示任意一个单词字符(只能是数字.字母.下划线) \s 表示任意一个空白字符(\t\r\n\f\x0B) \D ...
- hashtable的运用实例
#include <hash_set> #include <iostream> using namespace std; int main() { hashtable<i ...
- PaddlePaddle︱开发文档中学习情感分类(CNN、LSTM、双向LSTM)、语义角色标注
PaddlePaddle出教程啦,教程一部分写的很详细,值得学习. 一期涉及新手入门.识别数字.图像分类.词向量.情感分析.语义角色标注.机器翻译.个性化推荐. 二期会有更多的图像内容. 随便,帮国产 ...
- R语言︱情感分析—基于监督算法R语言实现(二)
每每以为攀得众山小,可.每每又切实来到起点,大牛们,缓缓脚步来俺笔记葩分享一下吧,please~ --------------------------- 笔者寄语:本文大多内容来自未出版的<数据 ...
- RFM模型及R语言实现
每每以为攀得众山小,可.每每又切实来到起点,大牛们,缓缓脚步来俺笔记葩分享一下吧,please~ --------------------------- 一.基本概念 根据美国数据库营销研究所Arth ...
- HighCharts之气泡图报错
HighCharts之气泡图报错 具体报错如下: uncaught exception: Highcharts error #17: www.highcharts.com/errors/17 ...
- Java Web项目(Extjs)报错二
1.Java Web项目(Extjs)报错二 具体报错如下: usage: java org.apache.catalina.startup.Catalina [ -config {pathname} ...