
Spark Java API 计算 Levenshtein 距离
Spark Java API 计算 Levenshtein 距离
在上一篇文章中,完成了Spark开发环境的搭建,最终的目标是对用户昵称信息做聚类分析,找出违规的昵称。聚类分析需要一个距离,用来衡量两个昵称之间的相似度。这里采用levenshtein距离。现在就来开始第一个小目标,用Spark JAVA API 计算字符串之间的Levenshtein距离。
1. 数据准备
样本数据如下:
{"name":"Michael", "nick":"Mich","age":50}
{"name":"Andy", "nick":"Anc","age":30}
{"name":"Anch", "nick":"MmAc","age":19}
把数据保存成文件并上传到hdfs上:./bin/hdfs dfs -put levestein.json /user/panda
2. 代码实现
定义一个类表示样本数据:
    public static class User{

        private String name;

        private String nick;

        private int age;

        public String getName() {

            return name;

        }

        public void setName(String name) {

            this.name = name;

        }

        public String getNick() {

            return nick;

        }

        public void setNick(String nick) {

            this.nick = nick;

        }

        public int getAge() {

            return age;

        }

        public void setAge(int age) {

            this.age = age;

        }

    }
创建SparkSession
SparkSession sparkSession = SparkSession.builder()

                .appName("levenshtein example")

                .master("spark://172.25.129.170:7077")

                .config("spark.some.config.option", "some-value")

                .getOrCreate();
在Spark命令行./bin/pyspark 启动Spark时,会默认创建一个名称为 spark 的SparkSession。而这里是写代码,也需要创建SparkSession对象。
The SparkSession instance is the way Spark executes user-defined
manipulations across the cluster. There is a one-to-one correspondence between a SparkSession and
a Spark Application.
定义数据类型
Encoder<User> userEncoder = Encoders.bean(User.class);
JAVA里面定义了一套数据类型,比如java.util.String是字符串类型;类似地,Spark也有自己的数据类型,因此Encoder就定义了如何将Java对象映射成Spark里面的对象。
Used to convert a JVM object of type
Tto and from the internal Spark SQL representation.To efficiently support domain-specific objects, an
Encoderis required. The encoder maps the domain specific typeTto Spark's internal type system. For example, given a classPersonwith two fields,name(string) andage(int), an encoder is used to tell Spark to generate code at runtime to serialize thePersonobject into a binary structure. This binary structure often has much lower memory footprint as well as are optimized for efficiency in data processing (e.g. in a columnar format). To understand the internal binary representation for data, use theschemafunction.
构建Dataset:
Dataset<User> userDataset = sparkSession.read().json(path).as(userEncoder);
说明一下Dataset与DataFrame区别,Dataset是针对Scala和JAVA特有的。Dataset是有类型的,Dataset的每一行是某种类型的数据,比如上面的User类型。
A Dataset is a strongly typed collection of domain-specific objects that can be transformed in parallel using functional or relational operations. Each Dataset also has an untyped view called a
DataFrame, which is a Dataset ofRow.
而DataFrame的每一行的类型是Row(看官方文档,我就这样理解了,哈哈。。)
DataFrame is represented by a Dataset of
Row。While, in Java API, users need to useDataset<Row>to represent aDataFrame.
这个图就很好地解释了DataFrame和Dataset的区别。
计算levenshtein距离,将之 transform 成一个新DataFrame中:
Column lev_res = functions.levenshtein(userDataset.col("name"), userDataset.col("nick"));

Dataset<Row> leveDataFrame = userDataset.withColumn("distance", lev_res);
完整代码
import org.apache.spark.sql.*;

public class LevenstenDistance {

    public static class User{

        private String name;

        private String nick;

        private int age;

        public String getName() {

            return name;

        }

        public void setName(String name) {

            this.name = name;

        }

        public String getNick() {

            return nick;

        }

        public void setNick(String nick) {

            this.nick = nick;

        }

        public int getAge() {

            return age;

        }

        public void setAge(int age) {

            this.age = age;

        }

    }

    public static void main(String[] args) {

        SparkSession sparkSession = SparkSession.builder()

                .appName("levenshtein example")

                .master("spark://172.25.129.170:7077")

                .config("spark.some.config.option", "some-value")

                .getOrCreate();

        String path = "hdfs://172.25.129.170:9000/user/panda/levestein.json";

        Encoder<User> userEncoder = Encoders.bean(User.class);

        Dataset<User> userDataset = sparkSession.read().json(path).as(userEncoder);

        userDataset.show();

        Column lev_res = functions.levenshtein(userDataset.col("name"), userDataset.col("nick"));

        Dataset<Row> leveDataFrame = userDataset.withColumn("distance", lev_res);

//        userDataset.show();

        leveDataFrame.show();

        System.out.println(lev_res.toString());

    }

}
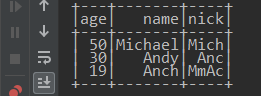
原来的Dataset:
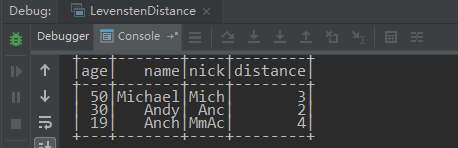
计算Levenshtein距离后的得到的DataFrame:
根据上面的示例,下面来演示一下一个更实际点的例子:计算昵称和签名之间的levenshtein距离,若levenshtein距离相同,就代表该用户的 昵称 和 签名 是相同的:
数据格式如下:
{"nick":"赖求","uid":123456}
{"details":"时尚是一种态度,时尚第一品牌。看我的。","nick":"冰冷世家@蹦蹦","signature":"轻装时代看我的。艾莱依时尚羽绒服。。","uid":123456}
{"nick":"[潗團軍-6]明 明『招 募』","signature":"我是来擂人的,擂死人不偿命!","uid":123456}
加载数据
        Dataset<Row> dataset = spark.read().format("json")

                .option("header", "false")

                .load("hdfs://172.25.129.170:9000/user/panda/profile_noempty.json");
取出昵称和签名
        //空字符串 与 null 是不同的

        Dataset<Row> nickSign = dataset.filter(col("nick").isNotNull())

                .filter(col("signature").isNotNull())

                .select(col("nick"), col("signature"), col("uid"));
计算昵称和签名的Levenshtein距离
Column lev_distance = functions.levenshtein(nickSign.col("nick"), nickSign.col("signature"));

        Dataset<Row> nickSignDistance = nickSign.withColumn("distance", lev_distance);
按距离进行过滤
Dataset<Row> sameNickSign = nickSignDistance.filter("distance = 0");
这样就能找出昵称和签名完全一样的用户了。
原文:https://www.cnblogs.com/hapjin/p/9954191.html
Spark Java API 计算 Levenshtein 距离的更多相关文章
- Spark Java API 之 CountVectorizer
Spark Java API 之 CountVectorizer 由于在Spark中文本处理与分析的一些机器学习算法的输入并不是文本数据,而是数值型向量.因此,需要进行转换.而将文本数据转换成数值型的 ...
- 在 IntelliJ IDEA 中配置 Spark(Java API) 运行环境
1. 新建Maven项目 初始Maven项目完成后,初始的配置(pom.xml)如下: 2. 配置Maven 向项目里新建Spark Core库 <?xml version="1.0& ...
- spark (java API) 在Intellij IDEA中开发并运行
概述:Spark 程序开发,调试和运行,intellij idea开发Spark java程序. 分两部分,第一部分基于intellij idea开发Spark实例程序并在intellij IDEA中 ...
- spark java API 实现二次排序
package com.spark.sort; import java.io.Serializable; import scala.math.Ordered; public class SecondS ...
- spark java api数据分析实战
1 spark关键包 <!--spark--> <dependency> <groupId>fakepath</groupId> <artifac ...
- 【Spark Java API】broadcast、accumulator
转载自:http://www.jianshu.com/p/082ef79c63c1 broadcast 官方文档描述: Broadcast a read-only variable to the cl ...
- 基于OpenStreetMap计算驾车距离(Java)
最近公司有个项目需要计算6000个点之间的驾车距离,第一时间想到的是利用Google的Distance Matrix API,但是免费Key每天只能计算2500个元素(元素 = 起点数量 * 终点数量 ...
- Elasticsearch 2.3.3 JAVA api说明文档
原文地址:https://www.blog-china.cn/template\documentHtml\1484101683485.html 翻译作者:@青山常在人不老 加入翻译:cdcnsuper ...
- Spark基础与Java Api介绍
原创文章,转载请注明: 转载自http://www.cnblogs.com/tovin/p/3832405.html 一.Spark简介 1.什么是Spark 发源于AMPLab实验室的分布式内存计 ...
随机推荐
- 1.2 NCE22 By heart
Some plays are so successful that they run/are performed/ for years on end/successively/in a row/con ...
- Altium Designer 复制和粘贴功能
在使用Altium Deigner时,很多时候会使用到复制和粘贴功能,Altium Designer复制分为三步:第一步选中要复制的内容(包括点选和框选),第二步,启动COPY命令,这时光标会变成十字 ...
- 英语词性系列-B02-动词
诗Poem 要求:背诵这首诗,翻译现代文,根据现代文用简单的英文翻译. 动词直观体会 动词 动词 动词 动词 动词 sell卖 buy买 beat击打 look看 dance跳舞 sing唱歌 spe ...
- 日志学习系列(二)——Log4net的实例
一.log4net简单实例创建步骤如下 1.第一步:在项目中添加对log4net.dll的引用,这里引用版本是2.0.8.0 2.第二步:程序启动时读取log4net的配置文件. 读取log4net的 ...
- 好程序员web前端分享18个用CSS制作出来的东西
好程序员web前端分享18个用CSS制作出来的东西,与流行的看法相反,CSS不仅仅是用来提供一个WEB页面的基本风格,以使它看起来更有吸引力.还有很多其他的事情,CSS也可以做的很好.由于它创建动画和 ...
- [P1169] 棋盘制作 &悬线法学习笔记
学习笔记 悬线法 最大子矩阵问题: 在一个给定的矩形中有一些障碍点,找出内部不包含障碍点的,边与整个矩形平行或重合的最大子矩形. 极大子矩型:无法再向外拓展的有效子矩形 最大子矩型:最大的一个有效子矩 ...
- [Spark]如何设置使得spark程序不输出 INFO级别的内容
Spark程序在运行的时候,总是输出很多INFO级别内容 查看了网上的一些文章,进行了试验. 发现在 /etc/spark/conf 目录下,有一个 log4j.properties.template ...
- 在 .NET Core 中结合 HttpClientFactory 使用 Polly(中篇)
译者:王亮作者:Polly 团队原文:http://t.cn/EhZ90oq声明:我翻译技术文章不是逐句翻译的,而是根据我自己的理解来表述的(包括标题).其中可能会去除一些不影响理解但本人实在不知道如 ...
- 08-JavaScript中的函数
JavaScript中的函数 1.函数简介 函数:就是将一些语句进行封装,然后通过调用的形式,执行这些语句. 函数的作用: 将大量重复的语句写在函数里,以后需要这些语句的时候,可以直接调用函数,避免重 ...
- Linux scp sudo
command line - scp to remote server with sudo - Super Userhttps://superuser.com/questions/138893/scp ...