
Spark Java API 之 CountVectorizer
Spark Java API 之 CountVectorizer
由于在Spark中文本处理与分析的一些机器学习算法的输入并不是文本数据,而是数值型向量。因此,需要进行转换。而将文本数据转换成数值型的向量有很多种方法,CountVectorizer是其中之一。
A CountVectorizer converts a collection of text documents into a vector representing the word count of text documents.
在构建向量时,有两个重要的参数:VocabSize和MinDF。前者表示词典的大小,后者表示当文档中某个Term出现的次数小于MinDF时,则不计入词典(该Term不属于词典中的 单词)。
比如说现在有两篇文档:【"w1", "w2", "w4", "w5", "w2"】,【"w1", "w2", "w3"】
CountVectorizer cv = new CountVectorizer().setInputCol("text").setOutputCol("feature")

                .setVocabSize(3).setMinDF(2);
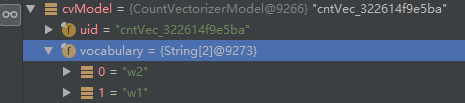
根据上面代码中的参数设置,词典大小为3,即一共可以有三个Term。由于在所有的文档中,"w1"出现2次,"w2"出现2次,因此计入词典。而"w3"、"w4"、"w5"只出现一次,不属于词典中的单词(Term)。如下图所示:词典中只有两个Term
When the dictionary is not defined CountVectorizer iterates over the dataset twice to prepare
the dictionary based on frequency and size.
CountVectorizer 首先扫描Dataset(文本数据)生成词典,然后再次扫描生成向量模型(CountVectorizerModel)
在构造Dataset 时,需要指定模式。用模式来解释Dataset中每一行的数据。
        StructType schema = new StructType(new StructField[]{

                new StructField("text", new ArrayType(DataTypes.StringType, true), false, Metadata.empty())

        });
A field inside a StructType. param: name The name of this field. param: dataType The data type of this field. param: nullable Indicates if values of this field can be
nullvalues. param: metadata The metadata of this field. The metadata should be preserved during transformation if the content of the column is not modified
第一个参数是:名称;第二个参数是dataType 数据类型;第三个参数是标识该字段的值是否可以为空;第四个参数为字段的元数据信息。
整个示例代码:
import org.apache.spark.ml.feature.CountVectorizer;

import org.apache.spark.ml.feature.CountVectorizerModel;

import org.apache.spark.sql.Dataset;

import org.apache.spark.sql.Row;

import org.apache.spark.sql.RowFactory;

import org.apache.spark.sql.SparkSession;

import org.apache.spark.sql.types.*;

import java.util.Arrays;

import java.util.List;

public class CounterVectorExample {

    public static void main(String[] args) {

        SparkSession spark = SparkSession.builder().appName("CountVectorizer").master("spark://172.25.129.170:7077").getOrCreate();

        List<Row> data = Arrays.asList(

//                RowFactory.create(Arrays.asList("a", "b", "c")),

//                RowFactory.create(Arrays.asList("a", "b", "b", "c", "a")),

//                RowFactory.create(Arrays.asList("a", "b", "a", "b"))

                RowFactory.create(Arrays.asList("w1", "w2", "w3")),

                RowFactory.create(Arrays.asList("w1", "w2", "w4", "w5", "w2"))

        );

        StructType schema = new StructType(new StructField[]{

                new StructField("text", new ArrayType(DataTypes.StringType, true), false, Metadata.empty())

        });

        Dataset<Row> df = spark.createDataFrame(data, schema);

        CountVectorizer cv = new CountVectorizer().setInputCol("text").setOutputCol("feature")

                .setVocabSize(3).setMinDF(2);

        CountVectorizerModel cvModel = cv.fit(df);

        //prior dictionary

        CountVectorizerModel cvm = new CountVectorizerModel(new String[]{"a", "b", "c"}).setInputCol("text")

                .setOutputCol("feature");

//        cvm.

        cvModel.transform(df).show(false);

        spark.stop();

    }

}
输出结果默认是以稀疏向量表示:
A sparse vector represented by an index array and a value array.
param: size size of the vector. param: indices index array, assume to be strictly increasing. param: values value array, must have the same length as the index array.
第一个字段代表:向量长度,由于这里词典中只有2个Term,因此转换出来的向量长度为2;第二个字段:索引下标;第三个字段:索引位置处相应的向量元素值。由上图中位置0处的Term是 w2,位置1处的Term是w1,因此,输出:
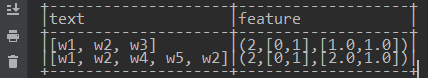
当然,我们也可以预先定义词典:在构造CountVectorizerModel的时候指定词典:【"w1", "w2", "w3"】
        //prior dictionary

        CountVectorizerModel cvm = new CountVectorizerModel(new String[]{"w1", "w2", "w3"}).setInputCol("text").setOutputCol("feature");

        cvm.transform(df).show(false);
对于文本:[w1,w2,w3],每个Term都在词典中,且出现了一次,因此稀疏特征向量表示为:(3,[0,1,2],[1.0,1.0,1.0])。其中,3代表向量的长度为3维向量;[0,1,2]表示向量的索引;[1.0,1.0,1.0]表示,在相应的索引处,每个元素值为1.0(即各个Term只出现了一次)。而对于文本[w1, w2, w4, w5, w2],因为w4和w5不在词典中,w1出现一次,w2出现2次,故其特征如下:
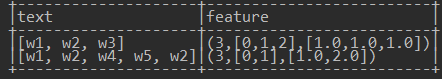
可以看出:对于CountVectorizerModel,向量长度就是词典的大小。
系列文章:
原文:https://www.cnblogs.com/hapjin/p/9899164.html
Spark Java API 之 CountVectorizer的更多相关文章
- Spark Java API 计算 Levenshtein 距离
Spark Java API 计算 Levenshtein 距离 在上一篇文章中,完成了Spark开发环境的搭建,最终的目标是对用户昵称信息做聚类分析,找出违规的昵称.聚类分析需要一个距离,用来衡量两 ...
- 在 IntelliJ IDEA 中配置 Spark(Java API) 运行环境
1. 新建Maven项目 初始Maven项目完成后,初始的配置(pom.xml)如下: 2. 配置Maven 向项目里新建Spark Core库 <?xml version="1.0& ...
- spark (java API) 在Intellij IDEA中开发并运行
概述:Spark 程序开发,调试和运行,intellij idea开发Spark java程序. 分两部分,第一部分基于intellij idea开发Spark实例程序并在intellij IDEA中 ...
- spark java API 实现二次排序
package com.spark.sort; import java.io.Serializable; import scala.math.Ordered; public class SecondS ...
- spark java api数据分析实战
1 spark关键包 <!--spark--> <dependency> <groupId>fakepath</groupId> <artifac ...
- 【Spark Java API】broadcast、accumulator
转载自:http://www.jianshu.com/p/082ef79c63c1 broadcast 官方文档描述: Broadcast a read-only variable to the cl ...
- Spark基础与Java Api介绍
原创文章,转载请注明: 转载自http://www.cnblogs.com/tovin/p/3832405.html 一.Spark简介 1.什么是Spark 发源于AMPLab实验室的分布式内存计 ...
- 利用SparkLauncher 类以JAVA API 编程的方式提交Spark job
一.环境说明和使用软件的版本说明: hadoop-version:hadoop-2.9.0.tar.gz spark-version:spark-2.2.0-bin-hadoop2.7.tgz jav ...
- Spark:java api实现word count统计
方案一:使用reduceByKey 数据word.txt 张三 李四 王五 李四 王五 李四 王五 李四 王五 王五 李四 李四 李四 李四 李四 代码: import org.apache.spar ...
随机推荐
- (原创)超详细一步一步在eclipse中配置Struts2环境,无基础也能看懂
(原创)超详细一步一步在eclipse中配置Struts2环境,无基础也能看懂 1. 在官网https://struts.apache.org下载Struts2,建议下载2.3系列版本.从图中可以看出 ...
- 总结JAVA----IO流中的File类
对于IO流中File类的总结 File类的基本概念 File类只能用于完成对于文件属性(是否存在.可读性.长度)的一些操作,不能用于文件的访问. File类的对象 File类的对象存储的是文件的绝对路 ...
- Loj 2320.「清华集训 2017」生成树计数
Loj 2320.「清华集训 2017」生成树计数 题目描述 在一个 \(s\) 个点的图中,存在 \(s-n\) 条边,使图中形成了 \(n\) 个连通块,第 \(i\) 个连通块中有 \(a_i\ ...
- SQL Server百万级大数据量删除
删除一个表中的部分数据,数据量百万级. 一般delete from 表 delete from 表名 where 条件: 此操作可能导致,删除操作执行的时间长:日志文件急速增长: 针对此情况处理 de ...
- redhat 6.5 安装和配置zabbix客户端
一.安装zabbix-agent端 rpm -ivh http://repo.zabbix.com/zabbix/2.4/rhel/6/x86_64/zabbix-release-2.4-1.el6. ...
- 百度杯”CTF比赛 九月场 123
进去后让登录,先看源码有提示 进到user.php 后发现是空的,看了wp才知道,有bak 下载下来直接爆破 但是那个1990是蛮骚的 直接进去登录 登录成功后是空的,走fd看看是怎么过 的 改包然后 ...
- 8个Python高效数据分析的技巧
一行代码定义List 下面是使用For循环创建列表和用一行代码创建列表的对比. x = [1,2,3,4] out = [] for item in x: out.append(item**2) pr ...
- IntelliJ IDEA编译项目报错 "xxx包不存在" 或 "找不到符号"
简介 在维护一个新的项目时出现在的这个情况,项目构建时一直报错"xxx包找不到",但是引用的包和引用的类都是存在的,一开始以为是项目问题,还问了做过的同事,第一次搞好了,但是换了分 ...
- C#中字节数组(byte[])和字符串相互转换
转换过程主要使用到System.Text.Encoding命名空间下的类 1. 字符串转换成字节数组byte[]: string str = "This is test string&quo ...
- PS图片后期之超简易造光调色方法
技法是死的,而人是活的,说的简单一点就是我们要学会开拓一下思维,调色的方法并不是只有[可选颜色]而已. 在修片之前,我们先要学会分析,在拍摄这一组照片时我希望有一种夕阳的光穿透晒在脸庞的感觉,而左边的 ...