
java 解析富文本处理 img 标签
很多项目都需要到富文本来添加内容,就好比新闻啊,旅游景点之类的,都需要使用富文本去添加数据,然而怎么我这边就发现了两个问题
1)怎样将富文本的图片的 src 获取出来?
2)后台上传的时候用的是相对路径,前端显示需要的是最对路径
我下面就记录一下解决这两个问题的方法
1):怎么将富文本的图片的 src 获取出来?很简单,就一个工具即可
public static List<String> getImgStr(String htmlStr) {

        List<String> list = new ArrayList<>();

        String img = "";

        Pattern p_image;

        Matcher m_image;

        // String regEx_img = "<img.*src=(.*?)[^>]*?>"; //图片链接地址

        String regEx_img = "<img.*src\\s*=\\s*(.*?)[^>]*?>";

        p_image = Pattern.compile(regEx_img, Pattern.CASE_INSENSITIVE);

        m_image = p_image.matcher(htmlStr);

        while (m_image.find()) {

            // 得到<img />数据

            img = m_image.group();

            // 匹配<img>中的src数据

            Matcher m = Pattern.compile("src\\s*=\\s*\"?(.*?)(\"|>|\\s+)").matcher(img);

            while (m.find()) {

                list.add(m.group(1));

            }

        }

        return list;

    }
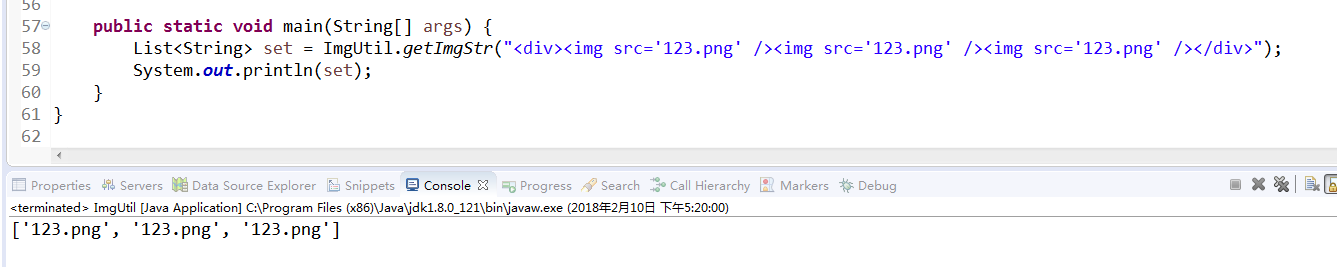
即可获取到以下结果
2)后台上传的时候用的是相对路径,前端显示需要的是最对路径,下面来看看我们怎么动态去修改富文本的 img 标签的 src ,也很简单,也是一个工具即可
这里需要一个叫做 jsoup 的 jar, maven 项目的话,直接引进来就行了
<dependency>

            <groupId>org.jsoup</groupId>

            <artifactId>jsoup</artifactId>

            <version>1.11.2</version>

        </dependency>
下面是工具类
public static String documentBody (String newsBody) {

        Element doc = Jsoup.parseBodyFragment(newsBody).body();

        Elements pngs = doc.select("img[src]");

        String httpHost = "http://192.168.0.100";

        for (Element element : pngs) {

            String imgUrl = element.attr("src");

            if (imgUrl.trim().startsWith("/")) { // 会去匹配我们富文本的图片的 src 的相对路径的首个字符,请注意一下

                imgUrl =httpHost + imgUrl;

                element.attr("src", imgUrl);

            }

        }

      return newsBody = doc.toString();

    }
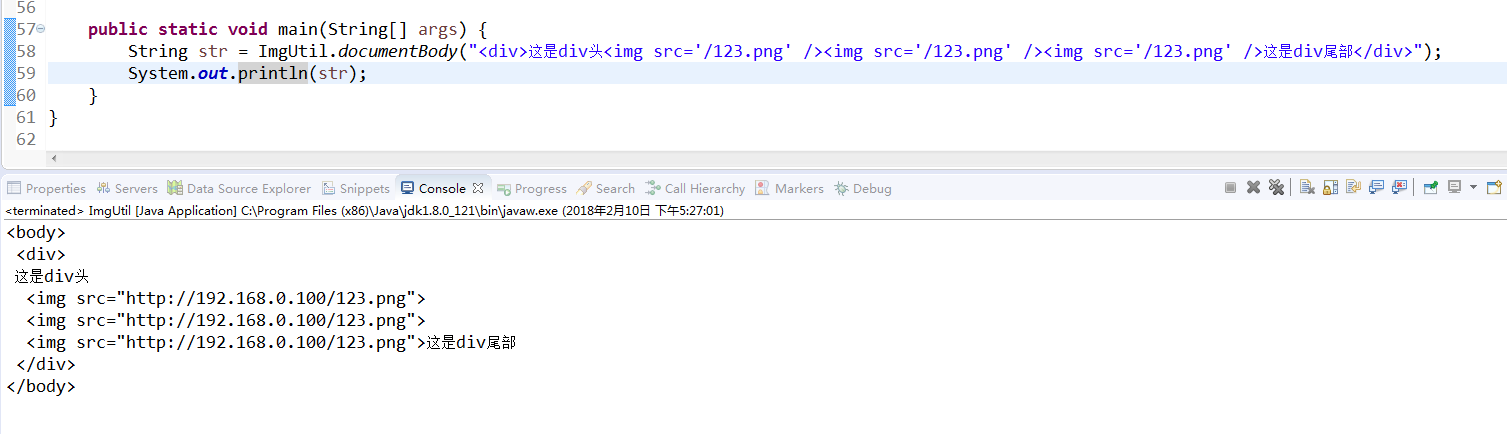
即可获取到以下结果
好了,以上就是这两个问题的解决方式
不喜勿喷!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
java 解析富文本处理 img 标签的更多相关文章
- 从文本中提取图片路径(java 解析富文本处理 img 标签)
很多项目都需要到富文本来添加内容,就好比新闻啊,旅游景点之类的,都需要使用富文本去添加数据,然而怎么我这边就发现了两个问题 怎样将富文本的图片的 src 获取出来? 方法一: 利用正则表达式: pub ...
- wxParse解析富文本内容使点击图片可以选中并实现放大缩小
wxParse解析富文本内容不多说,之前写过步骤介绍,主要是在使用过程中发现解析的富文本内容里有图片时有的可以点击放大缩小,有的点击却报错,找不到imgUrls. 经过排查发现:循环解析的富文本内容正 ...
- springmvc 后台实体类接受前端json字符串时,其中一个属性content 接受富文本内容时 标签<p>、<span> 这些标签丢失问题解决
问题描述: 前端一个字段 <script id="editor" type="text/plain" name="content" s ...
- php读取富文本处理html标签问题
thinkphp的一项配置会将富文本编辑器的内容中的html标签进行转义处理 'DEFAULT_FILTER' => 'htmlspecialchars', // 默认参数过滤方法使用htmls ...
- php 解析富文本编辑器中的hmtl内容,富文本样式正确输出
说明:富文本编辑器中的内容在直接获获取后需要解析以后才能在页面中正确显示 我在后端这样处理: $content = htmlspecialchars_decode($info['intro']); h ...
- 微信小程序/支付宝小程序 WxParse解析富文本(html)代码
小程序本身并不太支持html代码,比如html的img.span.p这个时候改这么办呢?需要用到一个小插件WxParse来实现. 小程序高级交流群:336925436 微信小程序支持富文本编辑器代码 ...
- selenium+java解决富文本输入
方法一: Actions actions = new Actions(driver); actions.sendKeys(Keys.TAB).perform(); //鼠标通过tab要先移到富文本框中 ...
- Selenium+java - 关于富文本编辑器的处理
什么是富文本编辑器? 富文本编辑器,Rich Text Editor, 简称 RTE, 是一种可内嵌于浏览器,所见即所得的文本编辑器.具体长啥样,如下图: 通过自动化操作富文本编辑器 模拟场景:在富文 ...
- 小程序里面使用wxParse解析富文本导致页面空白等
在部分安卓手机上会出现白屏的情况且有些ios手机上图文混排上,图片显示不出问题 解决:把插件里面的console.dir去掉即可(原因在于安卓手机无法解析console.dir) 有些图片解析出来下面 ...
随机推荐
- springboot 拦截器
拦截器的实现: 创建自定义拦截器CustomInterceptor: package com.xc.boot.handler; import org.springframework.stereotyp ...
- Notepad++ 的函数参数提示错误的问题终于解决了
看第3张图片,明明我输入的是 print_double(), 提示的却是 print() 函数的参数. 这个问题困扰了我半年,今天晚上找到解决问题的办法:
- 存在多个 AJAX 任务
实现的效果: 这两个Ajax任务可同时实现,也可单独实现. 标准的函数: var xmlhttp; function loadXMLDoc(url,ufunc){ if(window.XMLHttpR ...
- 优化算法系列-遗传算法(3)——NSGAII学习网址
JMetal https://www.cnblogs.com/denggaoshan/p/6306640.html https://www.cnblogs.com/denggaoshan/p/6308 ...
- django - 总结 - cookie|session
Cookie是通过HTTP请求和响应头在客户端和服务器端传递的. 在Web开发中,使用session来完成会话跟踪,session底层依赖Cookie技术. --------------------- ...
- 2017-2018-2 PDE 讨论班
等等. 第一次上课居然忘记怎么让笔记本电脑和投影仪相连了. 有两个接口. 一个在外面, 没用. 一个盖着了, 忘记翻开了.
- Scrapy 下载图片
参考 : https://www.jianshu.com/p/6c8d2730d088 https://docs.scrapy.org/en/latest/topics/item-pipeline.h ...
- Chrome firefox ie等浏览器空格 宽度不一样
用半角空格 或者全角空格 相当于半格中文字符的宽度, 相当于一个中文字符宽度. 注:在chrome中两个 占一个汉字的宽度;,而在IE.firefox中四个 才占一个汉字的宽度.
- 分别基于TensorFlow、PyTorch、Keras的深度学习动手练习项目
×下面资源个人全都跑了一遍,不会出现仅是字符而无法运行的状况,运行环境: Geoffrey Hinton在多次访谈中讲到深度学习研究人员不要仅仅只停留在理论上,要多编程.个人在学习中也体会到单单的看理 ...
- Anaconda+django安装问题
Anaconda使用中常遇到如下问题: 如果Anaconda不是最新版本,可在Anaconda Prompt中使用如下命令更新至最新版 conda update -n base -c defaults ...