
从文本中提取图片路径(java 解析富文本处理 img 标签)
很多项目都需要到富文本来添加内容,就好比新闻啊,旅游景点之类的,都需要使用富文本去添加数据,然而怎么我这边就发现了两个问题
怎样将富文本的图片的 src 获取出来?
方法一:
利用正则表达式:
public static List<String> getImgStr(String htmlStr) {

        List<String> list = new ArrayList<>();

        String img = "";

        Pattern p_image;

        Matcher m_image;

        // String regEx_img = "<img.*src=(.*?)[^>]*?>"; //图片链接地址

        String regEx_img = "<img.*src\\s*=\\s*(.*?)[^>]*?>";

        p_image = Pattern.compile(regEx_img, Pattern.CASE_INSENSITIVE);

        m_image = p_image.matcher(htmlStr);

        while (m_image.find()) {

            // 得到<img />数据

            img = m_image.group();

            // 匹配<img>中的src数据

            Matcher m = Pattern.compile("src\\s*=\\s*\"?(.*?)(\"|>|\\s+)").matcher(img);

            while (m.find()) {

                list.add(m.group(1));

            }

        }

        return list;

    }
即可获取到以下结果
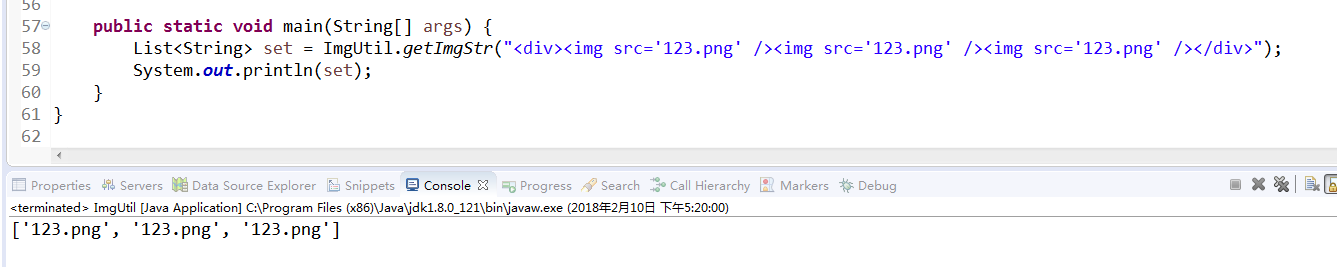
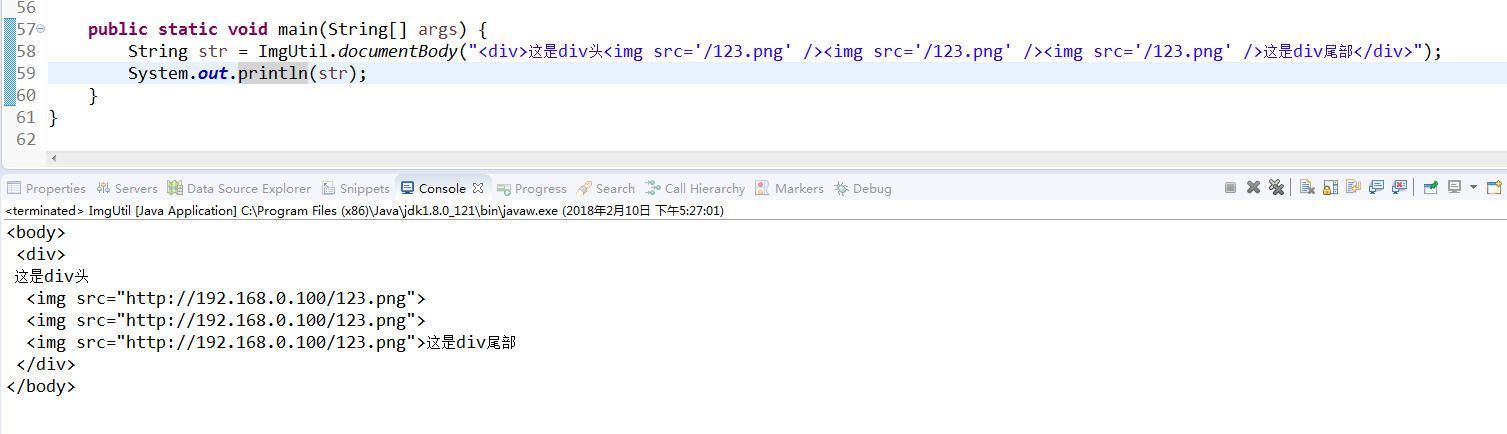
方法二:
引入一个叫做 jsoup 的 jar, (下载地址:https://jsoup.org/download)
<dependency>

            <groupId>org.jsoup</groupId>

            <artifactId>jsoup</artifactId>

            <version>1.11.2</version>

        </dependency>
下面是工具类
public static String documentBody (String newsBody) {

        Element doc = Jsoup.parseBodyFragment(newsBody).body();

        Elements pngs = doc.select("img[src]");

        String httpHost = "http://192.168.0.100";

        for (Element element : pngs) {

            String imgUrl = element.attr("src");

            if (imgUrl.trim().startsWith("/")) { // 会去匹配我们富文本的图片的 src 的相对路径的首个字符,请注意一下

                imgUrl =httpHost + imgUrl;

                element.attr("src", imgUrl);

            }

        }

      return newsBody = doc.toString();

    }
转载自:https://www.cnblogs.com/xjbBill/p/8439248.html
从文本中提取图片路径(java 解析富文本处理 img 标签)的更多相关文章
- JAVA-替换html中图片的路径-从html代码中提取图片路径并下载(完整版)
transHtml方法实现提取网络图片中得图片路径,将其重新下载到本地,并替换html中原来得路径 package com.googosoft.until; import java.io.Buffer ...
- java 解析富文本处理 img 标签
很多项目都需要到富文本来添加内容,就好比新闻啊,旅游景点之类的,都需要使用富文本去添加数据,然而怎么我这边就发现了两个问题 1)怎样将富文本的图片的 src 获取出来? 2)后台上传的时候用的是相对路 ...
- 用正则从html代码中提取图片路径
$str = '<div align="center"> <img src="http://www.99tyg.com/public/images/e8 ...
- wxParse解析富文本内容使点击图片可以选中并实现放大缩小
wxParse解析富文本内容不多说,之前写过步骤介绍,主要是在使用过程中发现解析的富文本内容里有图片时有的可以点击放大缩小,有的点击却报错,找不到imgUrls. 经过排查发现:循环解析的富文本内容正 ...
- 利用ROS工具从bag文件中提取图片
bag文件是ROS常用的数据存储格式,因此要从bag文件中提取数据就需要了解一点ROS的背景知识. 1. 什么是ROS及其优势 ROS全称Robot Operating System,是BSD-lic ...
- C#正则表达式匹配HTML中的图片路径,图片地址
C#正则表达式匹配HTML中的图片路径,图片地址 最近的项目中有个关于网页取图的功能需要我自己开发,那就是用正则表达式来匹配图片标签. 一般来说一个 HTML 文档有很多标签,比如“< ...
- NLP入门(十一)从文本中提取时间
在我们的日常生活和工作中,从文本中提取时间是一项非常基础却重要的工作,因此,本文将介绍如何从文本中有效地提取时间. 举个简单的例子,我们需要从下面的文本中提取时间: 6月28日,杭州市统计局权 ...
- 从html富文本中提取纯文本
其实从html富文本中提取纯文本很简单,富文本基本上是使用html标签给文本加上丰富多彩的样式. 所以只需要将富文本字符串中的“<.....>”标签剔除,即可得到纯文本.我们可以使用正则表 ...
- php读取出字符串中的img标签中的图片路径
php读取出字符串中的img标签中的图片路径 $pageContents = '字符串,带img标签'; $pageContents = str_replace('\"','"', ...
随机推荐
- TensorFlow中的变量和常量
1.TensorFlow中的变量和常量介绍 TensorFlow中的变量: import tensorflow as tf state = tf.Variable(0,name='counter') ...
- 基于Alpha-Beta剪枝的欢乐斗地主残局辅助
2019年4月17日更新: 将搜索主函数优化为局部记忆化搜索,再次提高若干倍搜索速度 更新了main和player,helper无更新 #include "Player-v3.0.cpp&q ...
- hibernate框架(2)---Hibernate的核心API
Hibernate的核心API 一般我们通过hibernate进行操作的时候,都会遵循下面的流程,那么接下来我对每一个步骤进行讲解: 1 public void testInsert() { 2 // ...
- salesforce lightning零基础学习(十二) 自定义Lookup组件的实现
本篇参考:http://sfdcmonkey.com/2017/01/07/custom-lookup-lightning-component/,在参考的demo中进行了简单的改动和优化. 我们在ht ...
- 解决AssetBundle包加载预制体时,Shader显示异常的问题
现象: 预制体上的粒子效果显示为紫色方块. 原因:shader在打成AB包后与指定平台产生相关性,Editor中无法正常读取. 解决办法: 遍历所有加载的对象,重新赋值Shader 代码: //修正s ...
- [NewLife.XCode]数据初始化
NewLife.XCode是一个有10多年历史的开源数据中间件,支持nfx/netstandard,由新生命团队(2002~2019)开发完成并维护至今,以下简称XCode. 整个系列教程会大量结合示 ...
- leetcode — plus-one
import java.util.ArrayList; import java.util.Arrays; import java.util.List; /** * Source : https://o ...
- python练习二—画幅好画
这个练习相对简单,主要是对reportlab库的学习调用,看代码 #! /usr/bin/env pyton # -*- coding=utf-8 -*- from reportlab.lib imp ...
- docker 构建 https 私有仓库 Registry
1.安装docker # docker install docker 2.拉取仓库镜像 # docker pull registry 3.生成认证certificate # mkdir ~/certs ...
- 用主题模型可视化分析911新闻(Python版)
本文由 伯乐在线 - 东狗 翻译,toolate 校稿.未经许可,禁止转载!英文出处:blog.dominodatalab.com.欢迎加入翻译小组. 本文介绍一个将911袭击及后续影响相关新闻文章的 ...