
【python 3.6】从网站抓图并存放到本地路径
#!/usr/bin/python

# -*- coding: UTF-8 -*-

_author_ = 'BH8ANK'

import urllib.request

import re

import os

import time

#os.rmdir("D:/images")

#1,打开页面,读取图片张数,抓html

wangzhi = "https://www.zhihu.com/question/43551423"

keywords = ".jpg"

def get_html(url):

    page = urllib.request.urlopen(url)

    html = page.read()

    return html

content = str(get_html(wangzhi))

a = content.count(keywords)

#print(content)

#print("此页面有%d张图" %a)

#2,匹配图片文件,抓jpg

def get_image(html):

    t = r'src="(.+?\.jpg)"' #正则表达式,匹配的是r后面的内容,这部分内容来自于网页的html

    img = re.compile(t)#将正则表达式翻译成它的对象

    html1 = html.decode('utf-8')

    # html用decode('utf-8')进行解码,由bytes变成string。

    # py3的urlopen返回的不是string是bytes,如果没有这一步,就会报下面的错

    #    return _compile(pattern, flags).findall(string)

    #TypeError: cannot use a string pattern on a bytes-like object

    img_list = re.findall(img,html1)#在html中找到所有符合正则表达式的图片,存入列表list

    # try:                           #要么用异常处理方式,要么用if not判断路径是否存在

    #     os.mkdir("D:/images")

    # except FileExistsError:

    #     pass

    if not os.path.exists("D:/images"):#不存在即创建

        os.mkdir("D:/images")

    print("\n\nCreat Success\n")

    # input()

    n = 1                              #此处要重点理解的是循环变量n,这个n一边控制循环,一边给抓到的图命名

    for html in img_list:

        urllib.request.urlretrieve(html, 'D:/images/%s.jpg' %n)

        print("抓到第%3d张图"  %n,end="") #如果写为%03d,则不满3位,前面加0,如果写为%3d,则右对齐,前面不加0

        '''

        上面print中用到了end='',表示后面的打印不换行

        下面的模块负责显示抓到第几张图片时,打印进度条

        '''

        N=0.05#每隔0.05秒打印一个=

        k=1#循环控制变量,一共打印20个=,最后打印Done

        while k < 20:

            print("=", end='', flush=True)

            time.sleep(N)

            k += 1

        print("Done")

        n += 1

    print("\n一共抓到%d张图"   %(n - 1))

    return img_list

    # for img_url in img_list:

    #     urllib.urlretrieve(img_url, 'D:/tmp/%s.jpg' % n)

    #     return img_list

# c = get_image(get_html(wangzhi))

# d = c.decode('utf-8')

#

# print(d)

if __name__ == "__main__":

    daima = get_html(wangzhi)

    print(daima)#此为目标网页的html代码

# input()

    get_image(daima)#从html中取出匹配的图片,并存放
代码部分本身比较简单,重点需要理解的部分是re.compile和re.findall.
容易出错的地方:
1,下面两行,为什么要decode呢
    html1 = html.decode('utf-8')

    img_list = re.findall(img,html1)
如果不decode,就会报错
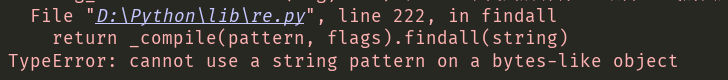
原因是:
TypeError: can't use a string pattern on a bytes-like object.
html用decode('utf-8')进行解码,由bytes变成string。
py3的urlopen返回的不是string是bytes,这一点和py2有差异。
2,下面这句的意思是筛选 【src="(.+?\.jpg)"】,这部分内容是通过查看网页html来确定的
t = r'src="(.+?\.jpg)"'
3,创建文件夹时,需要判断当前路径下,是否有这个文件夹,可以采用两种方式,if not 或者try except
【python 3.6】从网站抓图并存放到本地路径的更多相关文章
- Python Locust对指定网站“一键压测”
[本文出自天外归云的博客园] 前篇 前篇:Python Locust性能测试框架实践 本篇 承上——归纳过程 在前篇的基础上,我们可以利用Locust性能测试框架编写python脚本对指定网站或者接口 ...
- Python之路,Day22 - 网站用户访问质量分析监测分析项目开发
Python之路,Day22 - 网站用户访问质量分析监测分析项目开发 做此项目前请先阅读 http://3060674.blog.51cto.com/3050674/1439129 项目实战之 ...
- python爬虫之小说网站--下载小说(正则表达式)
python爬虫之小说网站--下载小说(正则表达式) 思路: 1.找到要下载的小说首页,打开网页源代码进行分析(例:https://www.kanunu8.com/files/old/2011/244 ...
- python爬虫之天气预报网站--查看最近(15天)的天气信息(正则表达式)
python爬虫之天气预报网站--查看最近(15天)的天气信息(正则表达式) 思路: 1.首先找到一个自己想要查看天气预报的网站,选择自己想查看的地方,查看天气(例:http://www.tianqi ...
- python爬虫之12306网站--火车票信息查询
python爬虫之12306网站--火车票信息查询 思路: 1.火车票信息查询是基于车站信息查询,先完成车站信息查询,然后根据车站信息查询生成的url地址去查询当前已知出发站和目的站的所有车次车票信息 ...
- python+splinter实现12306网站刷票并自动购票流程
python+splinter实现12306网站刷票并自动购票流程 通过python+splinter,实现在12306网站刷票并自动购票流程(无法自动识别验证码). 此类程序只是提高了12306网站 ...
- [转载]python实现带验证码网站的自动登陆
原文地址:python实现带验证码网站的自动登陆作者:TERRY-V 早听说用python做网络爬虫非常方便,正好这几天单位也有这样的需求,需要登陆XX网站下载部分文档,于是自己亲身试验了一番 ...
- python爬取某个网站的图片并保存到本地
python爬取某个网站的图片并保存到本地 #coding:utf- import urllib import re import sys reload(sys) sys.setdefaultenco ...
- 推荐一个学习python非常好的网站
推荐一个入门python非常好的网站(也可以学习JAVA)非常适合入门,不说多易于理解,也是比较亲民的0基础学习教程,还免费…… 网址:https://www.liaoxuefeng.com/(廖雪峰 ...
随机推荐
- 类似QQ的聊天工程
首先建立一个html:<!DOCTYPE html><html lang="en"><head> <meta charset=" ...
- Oracle查找lobsegment、lobindex对应的表
在查看表空间的使用情况的时候,发现有几个LOBSEGMENT.LOBINDEX类型的对象占用了大量的空间.于是想找出那些表占用了大量的空间,以便于清理. Oracle对BLOB类型的定义 ...
- tctip打赏小插件
tctip是一个js插件,作用是在web网页右侧生成一个打赏浮动窗 使用方法 页面使用(多数人的使用方式) 插件下载地址 第一步,引入js 一般引入min版本,即引入tctip-版本号.min.js文 ...
- PHP程序员面试中经常被提问的问题【转载】
1. Include 与 require的区别,require和require_once的效率哪个高? Php在遇到include时就解释一次,如果页面中出现10次include,php就解释10次, ...
- 发送邮箱验证码、session校验
本篇主要描述“发送邮箱验证码.session校验”相关前(html\js)后(java)台代码,业务逻辑示例,闲话少诉,直接上代码. 1.引入的jar包是mail-1.4.jar 2.java底层发送 ...
- C# 后台Http访问 raw from 键值对
using RestSharp;using System;using System.Collections;using System.Collections.Generic;using System. ...
- 简单的HTTP协议
HTTP 协议和 TCP/IP 协议族内的其他众多的协议相同,用于客户端和服务器之间的通信. 请求访问文本或图像等资源的一端称为客户端,提供资源响应的一端称为服务器端. 在两台计算机之间使用 HTTP ...
- operator.itemgetter() 字典列表排序
## 字典列表排序 students = [ {"name": "Stanley", "age": 22, "score" ...
- PHP在foreach中对$value赋值
foreach ($data as $key => $value) { $data[$key]['name'] = '测试在value中赋值';}
- django创建第一个子应用-3
在Web应用中,通常有一些业务功能模块是在不同的项目中都可以复用的,故在开发中通常将工程项目拆分为不同的子功能模块,各功能模块间可以保持相对的独立,在其他工程项目中需要用到某个特定功能模块时,可以将该 ...