
python爬虫之天气预报网站--查看最近(15天)的天气信息(正则表达式)
python爬虫之天气预报网站--查看最近(15天)的天气信息(正则表达式)
思路:
1.首先找到一个自己想要查看天气预报的网站,选择自己想查看的地方,查看天气(例:http://www.tianqi.com/xixian1/15/)
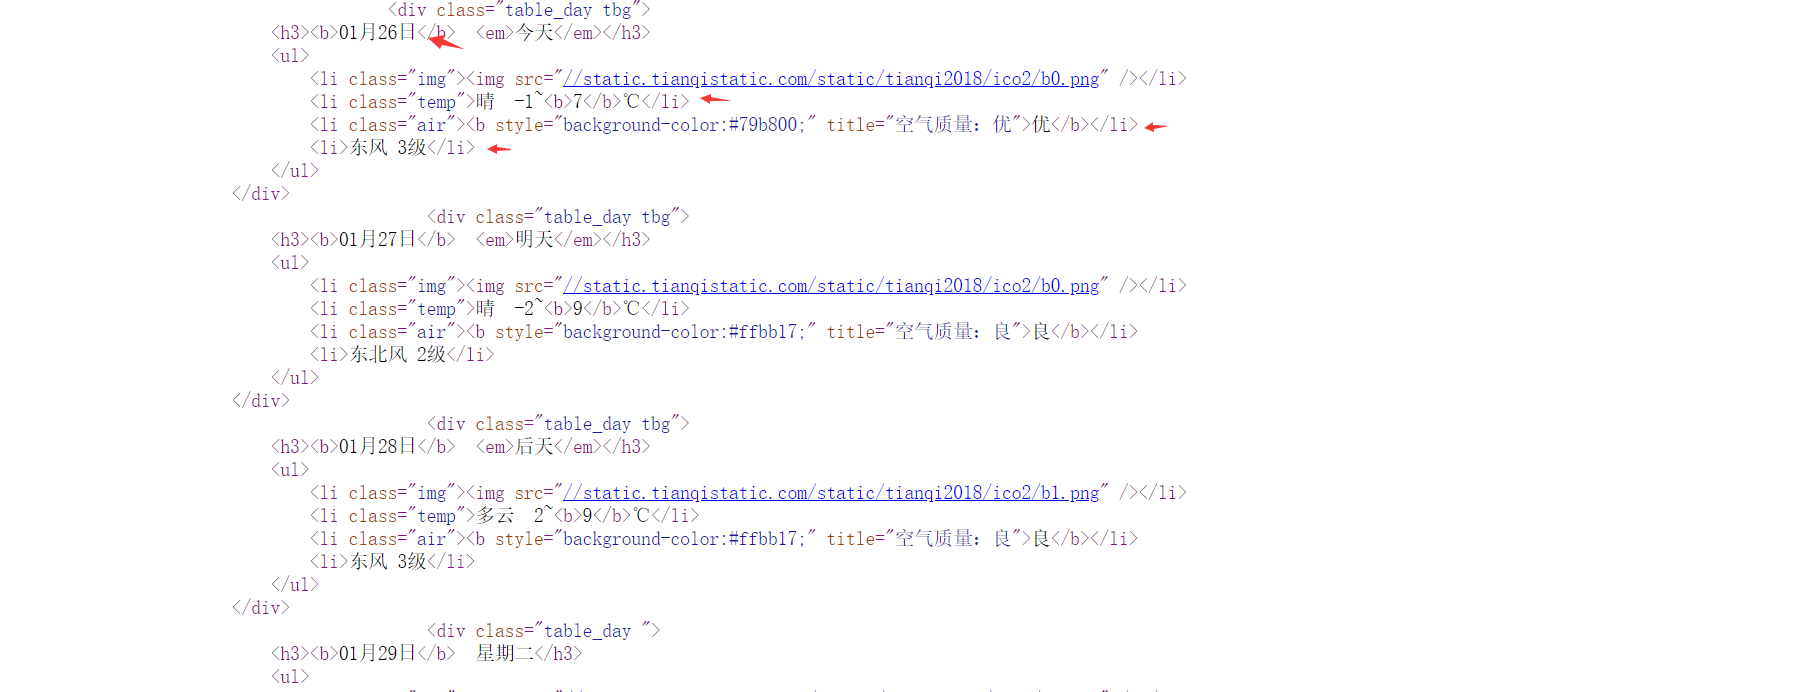
2.打开"网页源代码",分析自己想要获取数据的特点
3.运用正则表达式来对数据进行处理,获得自己想要的数据 #网站可能反爬虫,需要绕过,这里用浏览器的代理(python默认的用户代理是自己,需要改成浏览器的用户代理,这样就能绕过一些网站简单的反爬虫)
4.获得数据后,对数据进行简单的美化
5.把数据写入文件(用pickle模块)
2.打开"网页源代码",分析自己想要获取数据的特点(不同网站的数据不同,需要具体问题具体分析)
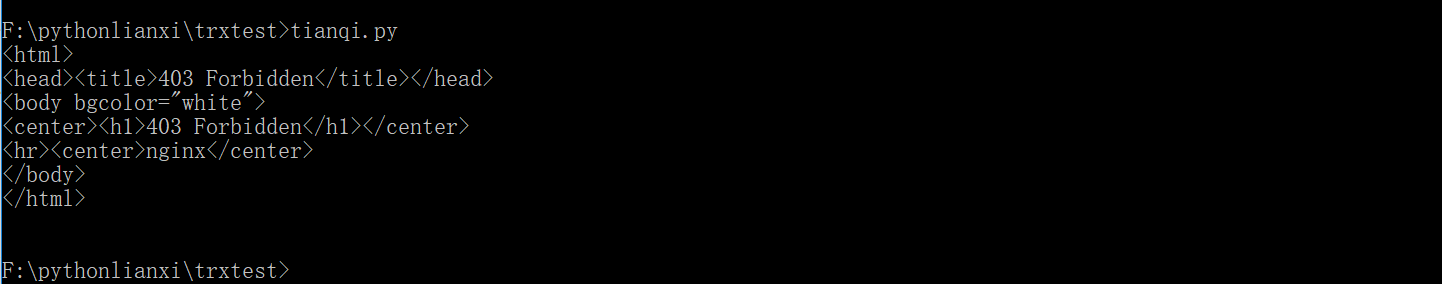
3.1被网站禁止爬虫效果图如下:
3.2运用正则表达式来对数据进行处理,获得自己想要的数据
代码如下:
查看天气预报

import re

import requests

from prettytable import PrettyTable

url="http://www.tianqi.com/xixian1/15/"

#绕过网站反爬虫

txt=requests.get(url,headers={"User-Agent":"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36","Host":"www.tianqi.com"}).text

#print(txt)

s1=re.compile(r'<b>(\d\d月\d\d日)</b>')   #日期

print(s1.findall(txt))

s2=re.compile(r'<li class="temp">(.+) (-?\d+)(\W+)<b>(-?\d+)</b>℃</li>')

print(s2.findall(txt))

s3=re.compile('>(.{1,4})</b></li>')

print(s3.findall(txt))

s4=re.compile(r'<li>([\u4e00-\u9fa5].+)</li>')

print(s4.findall(txt))

tianqi=[]

for i in range(len(s1.findall(txt))):

    tianqi.append([s1.findall(txt)[i],s2.findall(txt)[i][0],s2.findall(txt)[i][1]+s2.findall(txt)[i][2]+s2.findall(txt)[i][3],s3.findall(txt)[i],s4.findall(txt)[i]])

print(tianqi)

ptable=PrettyTable('日期 天气 气温(℃) 空气质量 风级'.split())

for i in tianqi:

    ptable.add_row(i)

print(ptable)
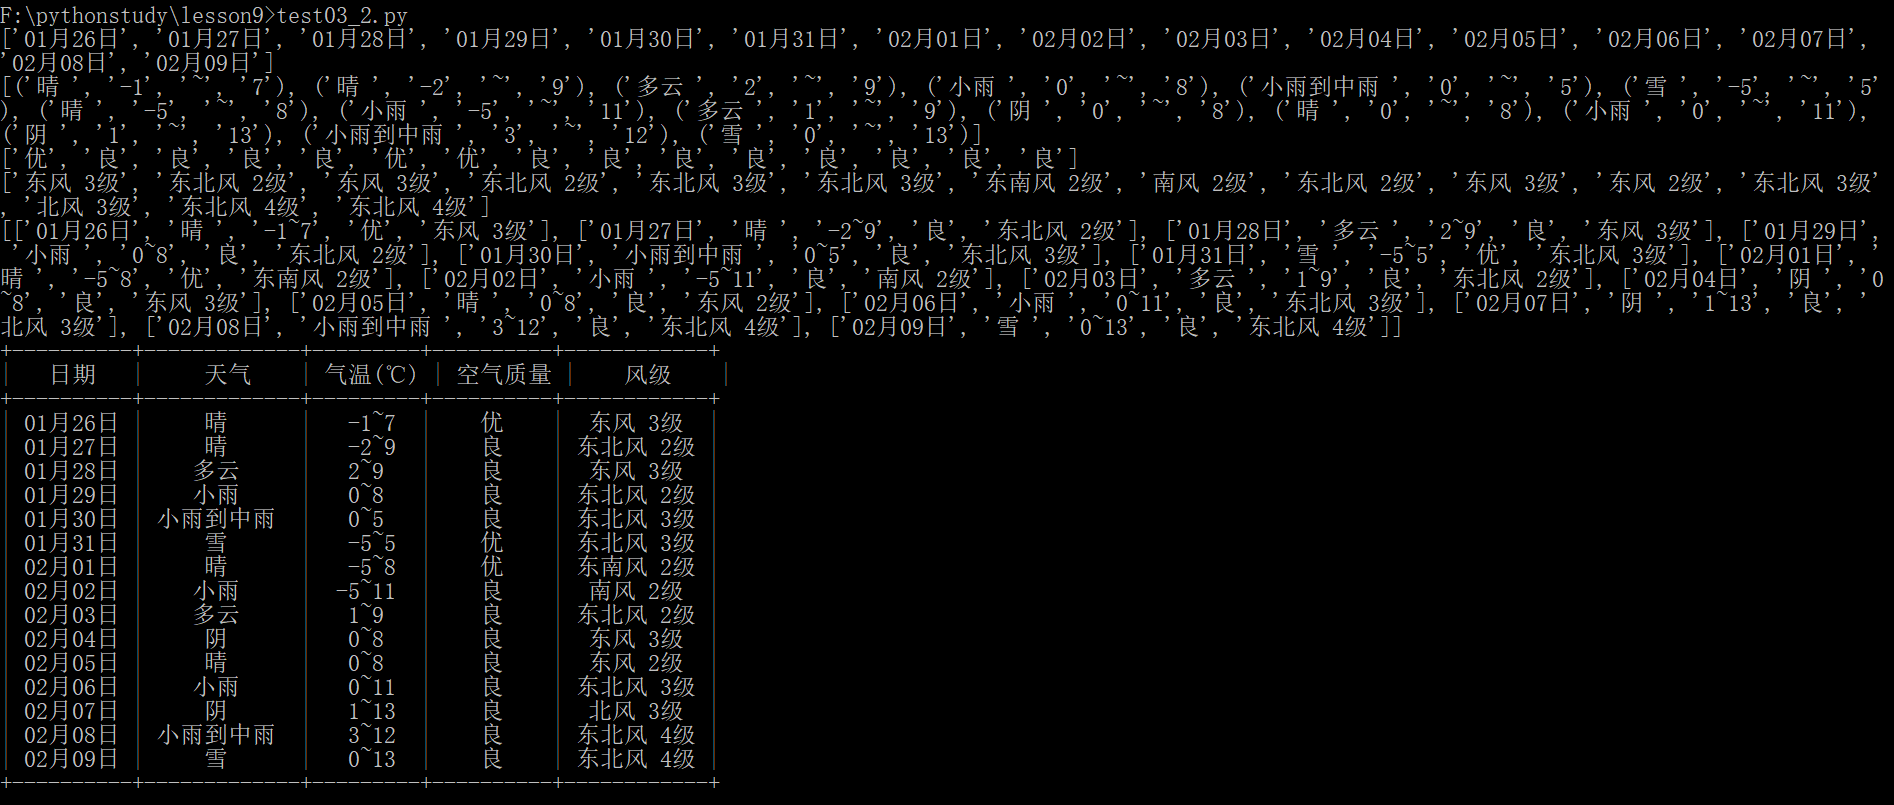
运行效果如下:
5.把数据写入文件(pickle)
代码如下:
import re

import requests

import pickle

from prettytable import PrettyTable

url="http://www.tianqi.com/xixian1/15/"

#绕过网站反爬虫

#把内容写入到文件中(序列化)

try:

    with open("tianqi.txt","rb") as f:

        txt=pickle.load(f)

        print("结果已加载")

except:

    txt=requests.get(url,headers={"User-Agent":"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36","Host":"www.tianqi.com"}).text

    with open("tianqi.txt","wb") as f:

        pickle.dump(txt,f)

        print("文件已写入!")

#print(txt)

s1=re.compile(r'<b>(\d\d月\d\d日)</b>')   #日期

print(s1.findall(txt))

s2=re.compile(r'<li class="temp">(.+) (-?\d+)(\W+)<b>(-?\d+)</b>℃</li>')

print(s2.findall(txt))

s3=re.compile('>(.{1,4})</b></li>')

print(s3.findall(txt))

s4=re.compile(r'<li>([\u4e00-\u9fa5].+)</li>')

print(s4.findall(txt))

tianqi=[]

for i in range(len(s1.findall(txt))):

    tianqi.append([s1.findall(txt)[i],s2.findall(txt)[i][0],s2.findall(txt)[i][1]+s2.findall(txt)[i][2]+s2.findall(txt)[i][3],s3.findall(txt)[i],s4.findall(txt)[i]])

print(tianqi)

ptable=PrettyTable('日期 天气 气温(℃) 空气质量 风级'.split())

for i in tianqi:

    ptable.add_row(i)

print(ptable)
python爬虫之天气预报网站--查看最近(15天)的天气信息(正则表达式)的更多相关文章
- python爬虫之12306网站--火车票信息查询
python爬虫之12306网站--火车票信息查询 思路: 1.火车票信息查询是基于车站信息查询,先完成车站信息查询,然后根据车站信息查询生成的url地址去查询当前已知出发站和目的站的所有车次车票信息 ...
- python爬虫之小说网站--下载小说(正则表达式)
python爬虫之小说网站--下载小说(正则表达式) 思路: 1.找到要下载的小说首页,打开网页源代码进行分析(例:https://www.kanunu8.com/files/old/2011/244 ...
- Python爬虫某招聘网站的岗位信息
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:阿尔法游戏 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- python爬虫之12306网站--车站信息查询
python爬虫查询车站信息 目录: 1.找到要查询的url 2.对信息进行分析 3.对信息进行处理 python爬虫查询全拼相同的车站 目录: 1.找到要查询的url 2.对信息进行分析 3.对信息 ...
- 利用Python爬虫刷新某网站访问量
前言:前一段时间看到有博友写了爬虫去刷新博客访问量一篇文章,当时还觉得蛮有意思的,就保存了一下,但是当我昨天准备复现的时候居然发现文章404了.所以本篇文章仅供学习交流,严禁用于商业用途 很多人学习p ...
- Python爬虫: "追新番"网站资源链接爬取
“追新番”网站 追新番网站提供最新的日剧和日影下载地址,更新比较快. 个人比较喜欢看日剧,因此想着通过爬取该网站,做一个资源地图 可以查看网站到底有哪些日剧,并且随时可以下载. 资源地图 爬取的资源地 ...
- 编写python爬虫采集彩票网站数据,将数据写入mongodb数据库
1.准备工作: 1.1安装requests: cmd >> pip install requests 1.2 安装lxml: cmd >> pip install lxml ...
- python爬虫1——获取网站源代码(豆瓣图书top250信息)
# -*- coding: utf-8 -*- import requests import re import sys reload(sys) sys.setdefaultencoding('utf ...
- python爬虫爬小说网站涉及到(js加密,CSS加密)
我是对于xxxx小说网进行爬取只讲思路不展示代码请见谅 一.涉及到的反爬 js加密 css加密 请求头中的User-Agent以及 cookie 二.思路 1.对于js加密 对于有js加密信息,我们一 ...
随机推荐
- Android Handler 机制总结
写 Handler 原理的文章很多,就不重复写了,写不出啥新花样.这篇文章的主要是对 handler 原理的总结. 1.Android消息机制是什么? Android消息机制 主要指 Handler ...
- TensorFlow中的Placement启发式算法模块——Placer
背景 [作者:DeepLearningStack,阿里巴巴算法工程师,开源TensorFlow Contributor] 受限于单个Device的计算能力和存储大小,许多深度学习模型都有着使用模型分片 ...
- IPv6笔记
单播地址包含的几种类型:1.AGUA地址:2000::到3FFF:FFFF:FFFF:FFFF:FFFF..... 一个接口可以拥有若干个AGUA地址2.Link-Local 地址:FE80::/10 ...
- SpringBoot系列——快速构建项目
前言 springboot官方参考指南:https://docs.spring.io/spring-boot/docs/2.1.0.RELEASE/reference/htmlsingle/ Spri ...
- [转]PHP开发者必须了解的工具—Composer
本文转自:https://blog.csdn.net/Zhihua_W/article/details/80345973 Composer是PHP 用来管理依赖(dependency)关系的工具.你可 ...
- C#基础知识总结(七)
摘要 C#最简单的两个算法:输入数字打印出菱形星星.冒泡排序1.输入数字打印出菱形星星 static void Main(string[] args) { //输入一个数,表示菱形星号,数字必须是一个 ...
- ubuntu 16.04服务器 搭建php LAMP环境
1.安装Apache 下载目录: sudo apt update 安装程序: sudo apt install apache2 检查是否安装成功: sudo systemctl status apac ...
- 第三讲 smart qq 登录成功后获取 vfwebqq ,psessionid,hash
public static void Login_GetPHV() { string urldata = "{\"ptwebqq\":\"#{ptwebqq}\ ...
- Element-UI 日期范围 date-picke
实际项目应用案例: <el-form-item label="开始日期:" prop="StartDate"> <el-date-picker ...
- Java集合类根接口:Collection 和 Map
前言 在前文中我们了解了几种常见的数据结构,这些数据结构有着各自的应用场景,并且被广泛的应用于编程语言中,其中,Java中的集合类就是基于这些数据结构为基础. Java的集合类是一些非常实用的工具类, ...