
scrapy操作mysql/批量下载图片
1.操作mysql
items.py

meiju.py
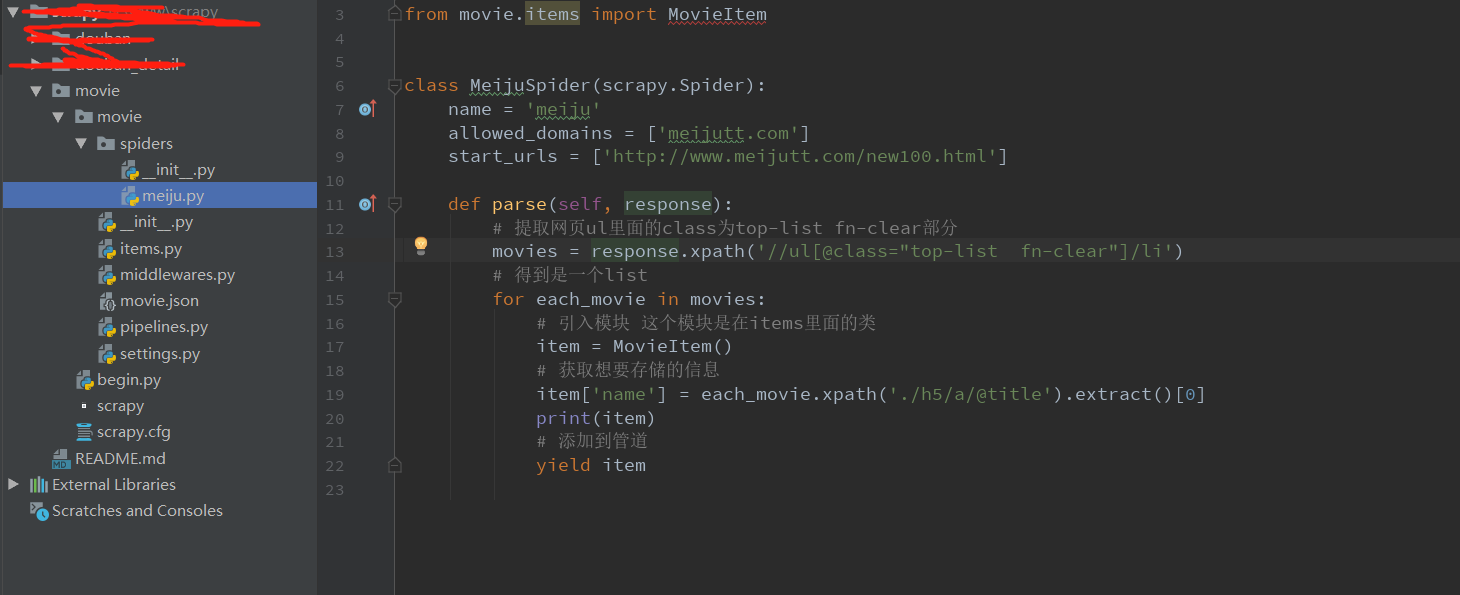
3.piplines.py

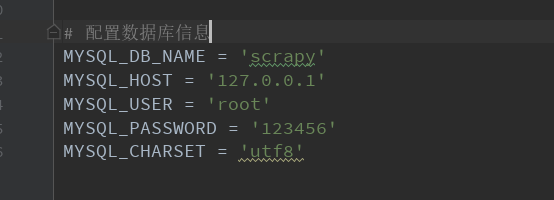
4.settings.py
--------------------------------------------------------------------------------------------------------------------------
批量下载图片。分类
网站:https://movie.douban.com/top250
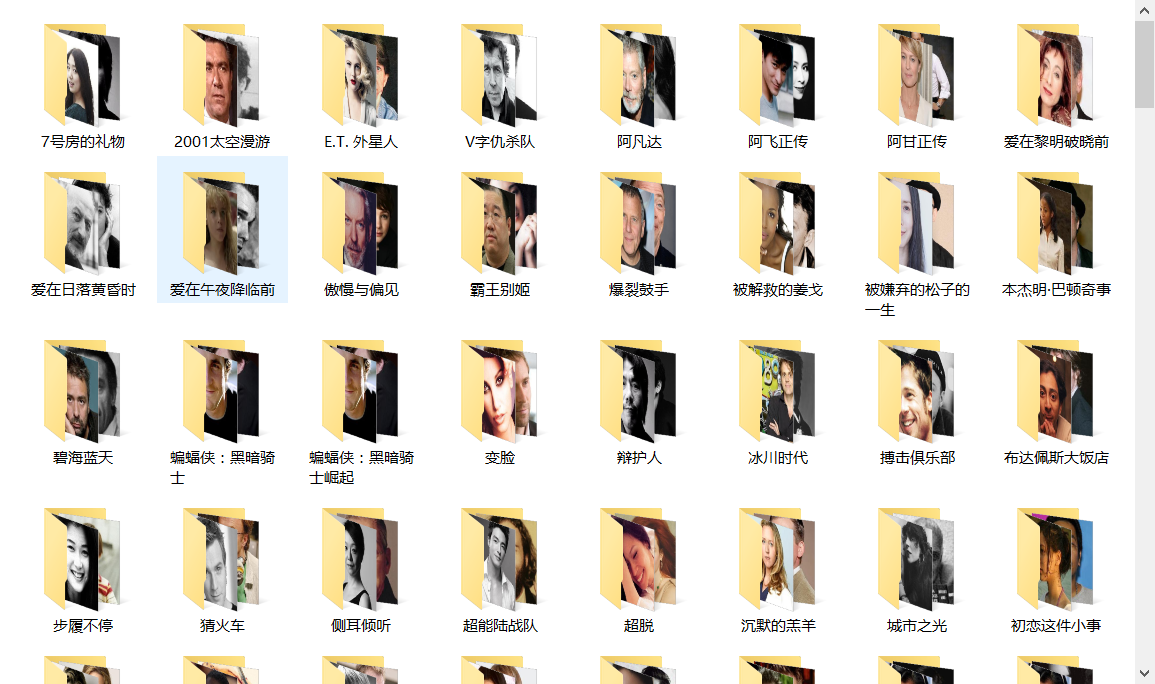
需求:按电影分类,获取里面的演职员图片。并存入各自的分类当中
效果:
代码
因为我们主要工作是下载。不存入数据库。存入数据库的话可以参考上面部分。
现在只需要修改spiders/xxx_spiders.py文件。就是开启项目适合生成的文件
我的是这个
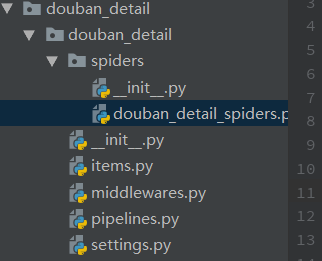
以下是这个文件夹的代码。
# -*- coding: utf-8 -*-

import scrapy

import os

import urllib.request

import re

class DoubanDetailSpidersSpider(scrapy.Spider):

    name = 'douban_detail_spiders'

    allowed_domains = ['movie.douban.com']

    start_urls = ['https://movie.douban.com/top250']

    file_path = "D:\\www\\scrapy\\douban_detail\\image\\"

    def parse(self, response):

        movie_list = response.xpath("//div[@class='article']//ol[@class='grid_view']/li")

        for i_item in movie_list:

            # 封面图

            master_pic_path = i_item.xpath(".//div[@class='pic']//a//img/@src").extract_first()

            # 文件名

            name = i_item.xpath(".//div[@class='info']//a/span[1]/text()").extract_first()

            # 创建文件夹

            self.fileIsBeing(name)

            # 详情连接

            detail_url = i_item.xpath(".//div[@class='hd']//a/@href").extract_first()

            # 获取详情里面内容

            # detail_link = response.xpath(".//div[@class='hd']//a/@href").extract()

            # for link in detail_link:
         # 这里是进入二级页面操作,在for循环里面。

            yield scrapy.Request(detail_url, meta={'name': name}, callback=self.detail_parse, dont_filter=True)

        # 解析下一页

        next_link = response.xpath("//div[@class='article']//div[@class='paginator']//span[@class='next']/link/@href").extract()

        print(next_link)

        if next_link:

            next_link = next_link[0]

            yield scrapy.Request("https://movie.douban.com/top250" + next_link, callback=self.parse)

    # 判断文件是否存在

    # 不存在则创建

    def fileIsBeing(self, name):

        path = self.file_path + name

        bool = os.path.exists(path)

        if not(bool):

            os.mkdir(path)

        return path

    # 解析详情里面的数据 获取二级页面内容操作。主要获取图片

    def detail_parse(self, response):

        name = response.meta['name']

        print(name)

        movie_prople_list = response.xpath("//div[@id='celebrities']//ul[@class='celebrities-list from-subject __oneline']//li")

        for i_mov_item in movie_prople_list:

            background_img = i_mov_item.xpath(".//div[@class='avatar']/@style").extract_first()

            user_name = i_mov_item.xpath(".//div[@class='info']//a/@title").extract_first()

            img_file_name = "%s.jpg" % user_name  # 工作人员

            img_url = self.txt_wrap_by('(', ')', background_img)  # 图片地址

            print(img_file_name)

            file_path = os.path.join(self.file_path+name, img_file_name)

            urllib.request.urlretrieve(img_url, file_path)

        #     print(img_file_name)

    # 截取字符串中间部分

    def txt_wrap_by(self, start_str, end, html):

        start = html.find(start_str)

        if start >= 0:

            start += len(start_str)

            end = html.find(end, start)

            if end >= 0:

                return html[start:end].strip()
码云:https://gitee.com/chenrunxuan/scrapy
scrapy操作mysql/批量下载图片的更多相关文章
- scrapy批量下载图片
# -*- coding: utf-8 -*- import scrapy from rihan.items import RihanItem class RihanspiderSpider(scra ...
- 第三百二十五节,web爬虫,scrapy模块标签选择器下载图片,以及正则匹配标签
第三百二十五节,web爬虫,scrapy模块标签选择器下载图片,以及正则匹配标签 标签选择器对象 HtmlXPathSelector()创建标签选择器对象,参数接收response回调的html对象需 ...
- 【Python】nvshens按目录批量下载图片爬虫1.00(单线程版)
# nvshens按目录批量下载图片爬虫1.00(单线程版) from bs4 import BeautifulSoup import requests import datetime import ...
- javaWeb 批量下载图片
批量下载网页图片 CreateTime--2017年9月26日15:40:43 Author:Marydon 所用技术:javascript.java 测试浏览器:chrome 开发工具:Ecli ...
- C++ 根据图片url 批量 下载图片
最近需要用到根据图片URL批量下载到本地的操作.查找了相关资料,记录在这儿. 1.首先在CSV文件中提取出url ifstream fin("C:\\Users\\lenovo\\Deskt ...
- 用python批量下载图片
一 写爬虫注意事项 网络上有不少有用的资源, 如果需要合理的用爬虫去爬取资源是合法的,但是注意不要越界,前一阶段有个公司因为一个程序员写了个爬虫,导致公司200多个人被抓,所以先进入正题之前了解下什么 ...
- python——批量下载图片
前言 批量下载网页上的图片需要三个步骤: 获取网页的URL 获取网页上图片的URL 下载图片 例子 from html.parser import HTMLParser import urllib.r ...
- 利用Node 搭配uglify-js压缩js文件,批量下载图片到本地
Node的便民技巧-- 压缩代码 下载图片 压缩代码 相信很多前端的同学都会在上线前压缩JS代码,现在的Gulp Webpack Grunt......都能轻松实现.但问题来了,这些都不会,难道就要面 ...
- scrapy中的ImagePipeline下载图片到本地、并提取本地的保存地址
通过scrapy内置到ImagePipeline下载图片到本地 在settings中打开 ITEM_PIPELINES的注释,并在这里面加入 'scrapy.pipelines.images.Imag ...
随机推荐
- ApacheCon 首次亚洲大会 —— Incubator 专场介绍
Apache 孵化器即为想要进入 Apache 软件基金会(ASF)的项目提供相关帮助和服务.它帮助进入的项目(称为"podling")采用 Apache 的治理风格,并引导使用 ...
- java学习第一天.day03
运行程序数据存储 ASCII Unicode(万国码) A在码表的顺序是65,a在码表的顺序是97,1代表49 变量 定义一个变量声明数据类型是开辟一个空间存储数据,java对数据的定义比较严格,比如 ...
- kafka报错 日志压缩报错直接退出
Resetting first dirty ofset to log start offset 2971862 since the checkpointed offset 12675089 is ...
- 从零开始搭建react基础开发环境(基于webpack5)
前言 最近利用闲暇时间把webpack系统的学习了下,搭建出一个react环境的脚手架,写篇文章总结一下,帮助正在学习webpack小伙伴们,如有写的不对的地方或还有可以优化的地方,望大佬们指出,及时 ...
- 基于开源方案构建统一的文件在线预览与office协同编辑平台的架构与实现历程
大家好,又见面了. 在构建业务系统的时候,经常会涉及到对附件的支持,继而又会引申出对附件在线预览.在线编辑.多人协同编辑等种种能力的诉求. 对于人力不是特别充裕.或者项目投入预期规划不是特别大的公司或 ...
- DataGridVIew控件绑定数据之后的,增、插、删操作
最开始没有绑定数据,很快就实现了增.插.删操作,可是绑定数据之后,进行这些操作就会报错. 网上对这方面的资料比较少,自己摸索着找到了解决方法,也就是直接对绑定的数据进行操作,这里以DataTable为 ...
- 字节跳动端智能工程链路 Pitaya 的架构设计
Client AI 是字节跳动产研架构下属的端智能团队,负责端智能 AI 框架和平台的建设,也负责模型和算法的研发,为字节跳动开拓端上智能新场景.本文介绍的 Pitaya 是由字节跳动的 Client ...
- 100 个常见错误「GitHub 热点速览 v.22.35」
本周的特推非常得延续上周的特点--会玩,向别人家的女朋友发送早安.这个错误是如何发生的呢?如何有效避免呢?自己用 daily_morning 免部署.定制一个早安小助手给女友吧. 除了生活中的错误,工 ...
- C#使用BouncyCastle生成PKCS#12数字证书
背景 生成数字证书用于PDF文档数字签名 数字证书需要考虑环境兼容性,如linux.windows 网上资料不全或版本多样 本文章主要介绍了在C#中使用BouncyCastle生成PKCS#12个人信 ...
- RabbitMQ 入门系列:9、扩展内容:死信队列:真不适合当延时队列。
系列目录 RabbitMQ 入门系列:1.MQ的应用场景的选择与RabbitMQ安装. RabbitMQ 入门系列:2.基础含义:链接.通道.队列.交换机. RabbitMQ 入门系列:3.基础含义: ...