
scrapy框架学习(六)日志设置和数据存储
日志设置
CRITICAL : 严重错误
ERROR : 一般错误
WARNING : 警告
INFO : 一般的信息
DEBUG : 调试信息
默认的显示级别是DEBUG
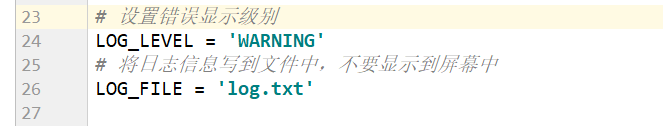
# 设置错误显示级别
LOG_LEVEL = 'DEBUG'
# 将日志信息写到文件中,不要显示到屏幕中
LOG_FILE = 'log.txt'
数据存储
在pipelines.py文件中创建3个函数
def open_spider(self,spider) 爬虫启动时会调用此方法
def close_spider(self,spider) 爬虫结束时会调用此方法
def download(self,item) 自己构建的下载文件的方法
# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: https://docs.scrapy.org/en/latest/topics/item-pipeline.html

# useful for handling different item types with a single interface

from itemadapter import ItemAdapter

import json

import os

import urllib.request

class MyfirstScrapydemoPipeline:

    #爬虫启动时会调用此方法

    def open_spider(self,spider):

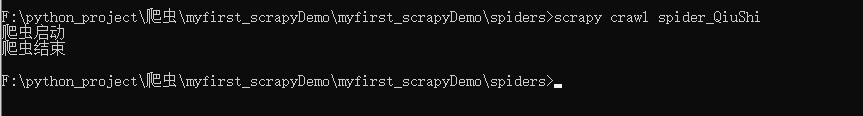
        print('爬虫启动')

        self.fp= open('qiushibaike.txt','w',encoding='utf8')

    def process_item(self, item, spider):

        #下载头像图片

        self.download(item)

        #将数据转化为字典

        obj= dict(item)

        #将字典数据装换为json格式

        string= json.dumps(obj,ensure_ascii=False)

        #将数据写入文件

        self.fp.write(string+'\n')

        #不注释return item时只会下载第一页的头像

        #return item

    def download(self,item):

        #定义头像图片存放路径

        dirpath= r'F:\python_project\爬虫\myfirst_scrapyDemo\myfirst_scrapyDemo\spiders\头像'

        #获取每一张图片的名称

        name= item['name']+'.jpg'

        #拼接每一张头像图片的存储路径

        filepath=os.path.join(dirpath,name)

        #下载头像图片

        urllib.request.urlretrieve(item['face_src'],filepath)

    # 爬虫结束时会调用此方法

    def close_spider(self,spider):

        print('爬虫结束')

        self.fp.close()
scrapy框架学习(六)日志设置和数据存储的更多相关文章
- 自己的Scrapy框架学习之路
开始自己的Scrapy 框架学习之路. 一.Scrapy安装介绍 参考网上资料,先进行安装 使用pip来安装Scrapy 在开始菜单打开cmd命令行窗口执行如下命令即可 pip install Scr ...
- 爬虫入门(四)——Scrapy框架入门:使用Scrapy框架爬取全书网小说数据
为了入门scrapy框架,昨天写了一个爬取静态小说网站的小程序 下面我们尝试爬取全书网中网游动漫类小说的书籍信息. 一.准备阶段 明确一下爬虫页面分析的思路: 对于书籍列表页:我们需要知道打开单本书籍 ...
- scrapy框架学习之路
一.基础学习 - scrapy框架 介绍:大而全的爬虫组件. 安装: - Win: 下载:http://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted pip3 ...
- Scrapy框架学习笔记
1.Scrapy简介 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网 ...
- scrapy框架学习
一.初窥Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中. 其最初是为了 页面抓取 (更确切来说, 网 ...
- Scrapy框架学习参考资料
00.Python网络爬虫第三弹<爬取get请求的页面数据> 01.jupyter环境安装 02.Python网络爬虫第二弹<http和https协议> 03.Python网络 ...
- Python3 Scrapy 框架学习
1.安装scrapy 框架 windows 打开cmd输入 pip install Scrapy 2.新建一个项目: 比如这里我新建的项目名为first scrapy startproject fir ...
- Scrapy框架学习 - 使用内置的ImagesPipeline下载图片
需求分析需求:爬取斗鱼主播图片,并下载到本地 思路: 使用Fiddler抓包工具,抓取斗鱼手机APP中的接口使用Scrapy框架的ImagesPipeline实现图片下载ImagesPipeline实 ...
- Scrapy框架学习(一)Scrapy框架介绍
Scrapy框架的架构图如上. Scrapy中的数据流由引擎控制,数据流的过程如下: 1.Engine打开一个网站,找到处理该网站的Spider,并向该Spider请求第一个要爬取得URL. 2.En ...
- Scrapy 框架 安装 五大核心组件 settings 配置 管道存储
scrapy 框架的使用 博客: https://www.cnblogs.com/bobo-zhang/p/10561617.html 安装: pip install wheel 下载 Twisted ...
随机推荐
- 钓鱼攻击之:OFFICE CVE-2017-11882
钓鱼攻击之:OFFICE CVE-2017-11882 目录 钓鱼攻击之:OFFICE CVE-2017-11882 1 环境准备 2 利用过程 2.1 生成验证POC 2.2 CVE-2017-11 ...
- div 元素内容超出可通过鼠标滚轮实现横向滚动
移动端中的元素内容超出时,对容器设置overflow-x: auto就可以通过手势水平移动.但是 PC 端只能通过鼠标滚轮上下滑动,而不能水平移动. 只需要给元素添加一个监听鼠标滚轮事件,上下滑动时修 ...
- mysql的数据操作
INSERT [INTO] 表名 [(字段名1,...)] {VALUES | VALUE} ({expr | DEFAULT},...),(...),... 说明:主键列是自动增长,但是在全列插入时 ...
- windows下搭建h5游戏小小火影教程【附安装包】
小小三国是一款很好玩的H5游戏.只需要用一台64位的windows电脑或服务器,你就可以和朋友们一起联机玩这个游戏了.本文将会教你如何搭建这个游戏,步骤如下. 1.下载好后你会看到该压缩包 2.解压到 ...
- Vue中qrcode的使用方法(生成二维码插件) / 前端页面根据URL链接生成二维码
1.下载 npm install qrcode --save-dev 2.引入(在所需要的页面中引入) import QRCode from "qrcode"; //引入生成二维码 ...
- 通过pxelinux引导管理器网络引导slax linux
前提条件 1.用于引导服务器具备tftp服务和http服务: 2.使用syslinux项目下lpxelinux.0做为pxe引导文件,原因:测试发现lpxelinux.0对http协议支持更好,可以更 ...
- nvm安装及使用(windon/mac)
有必要说一下nvm,因为大家做前端对node都很熟悉吧.前端的很多项目中都依赖node,还有可能每个项目依赖的node版本不一样,这样我们就上了nvm. nvm 是node Version Manag ...
- io流转换为Multipart文件
io流转换为Multipart文件 个人的话是运用到了minio文件服务器保存文件,前端(vue)异步上传文件后,由于要提升用户体验效果,先上传文件到后台服务器,返回视频在文件服务器的link()参数 ...
- Elasticsearch使用示例
简单示例 import cn.hutool.core.bean.BeanUtil; import com.baomidou.mybatisplus.extension.service.impl.Ser ...
- 浅谈dfs深度优先搜索
深度优先搜索(Depth First Search)是一种常见的暴力算法 此算法上限和下限较高,容易上手,适用情形多,学习性价比高 下限高于有固定的模板,且时间复杂度明显优于暴力枚举,容易拿到题目部分 ...