
python 下载小说
以下载官场风月小说为例:
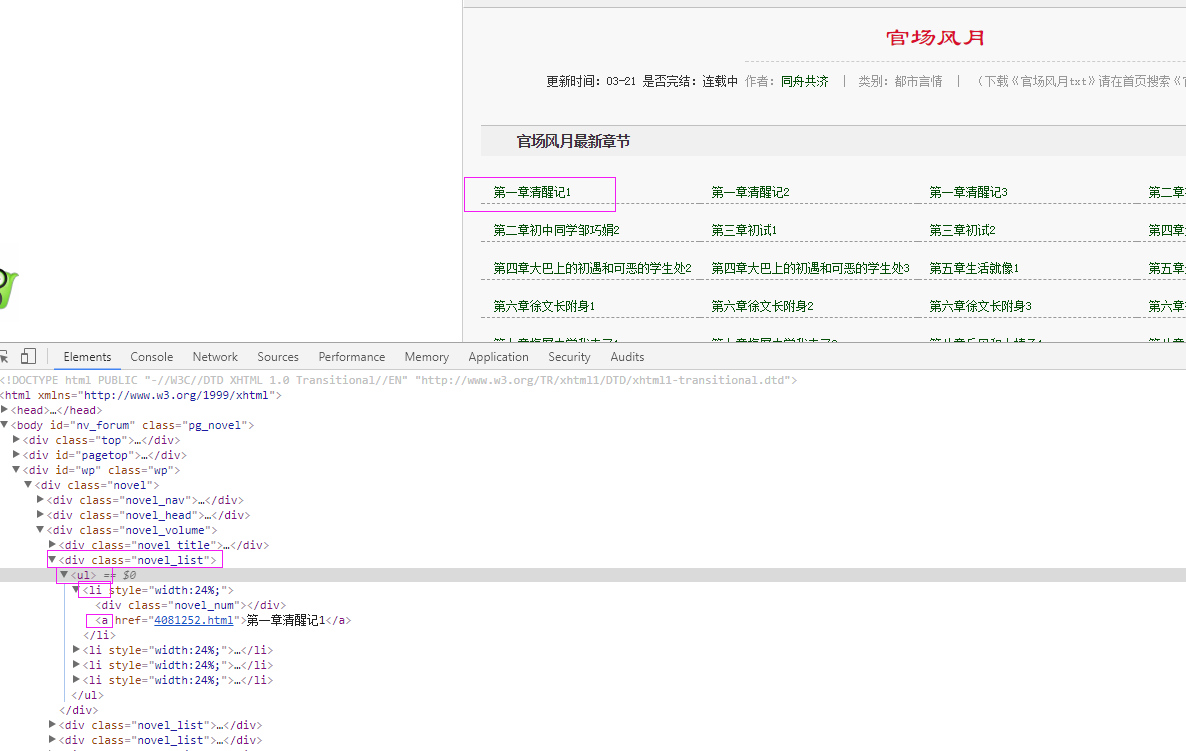
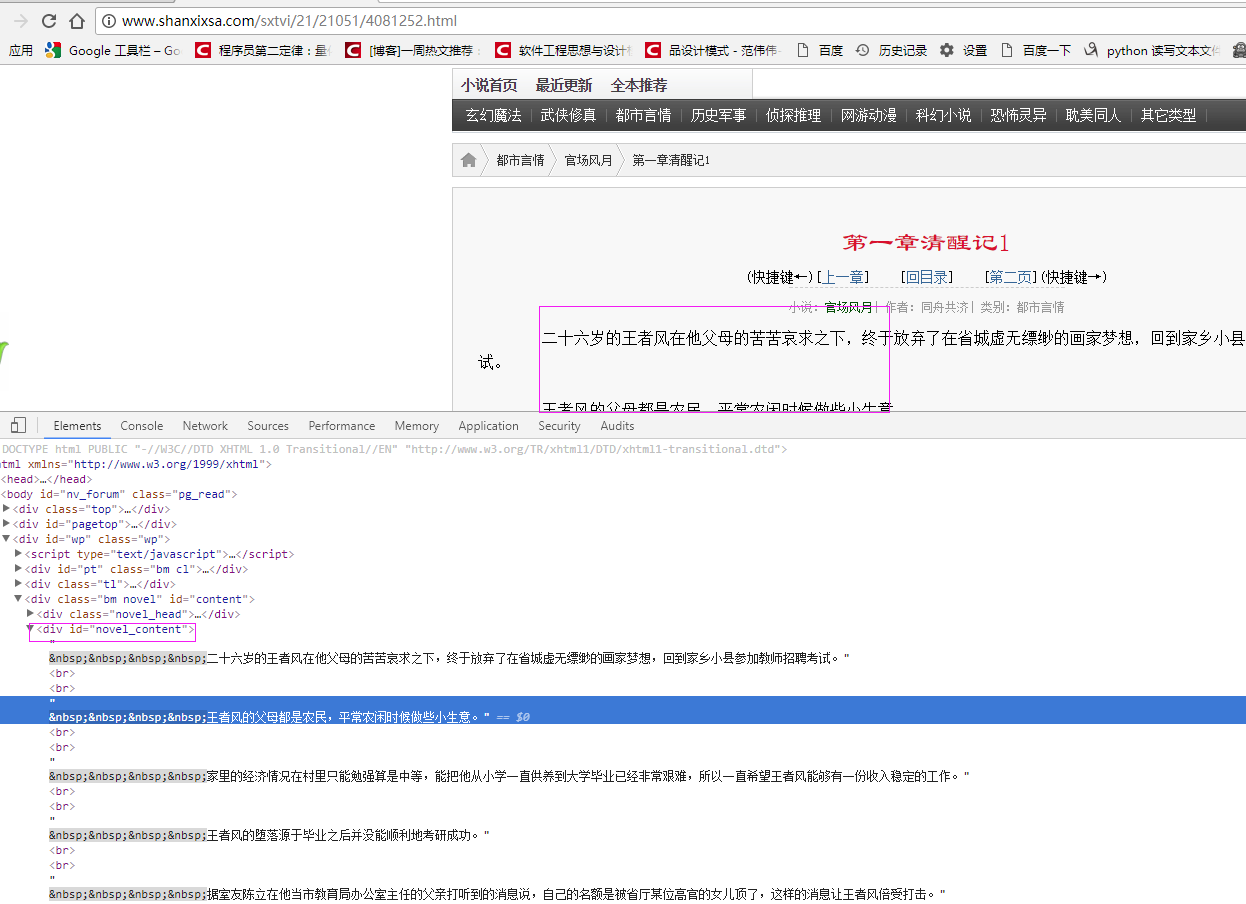
具体代码:
# coding=utf-8

import os

import re

from selenium import webdriver

from selenium.common.exceptions import TimeoutException

import selenium.webdriver.support.ui as ui

import time

from datetime import datetime

from selenium.webdriver.common.action_chains import ActionChains

# from threading import Thread

from pyquery import PyQuery as pq

import LogFile

import urllib

class downfile(object):

    def __init__(self,websearch_url,novelname):

        self.driver = webdriver.PhantomJS()

        # self.driver.set_page_load_timeout(10)

        self.driver.maximize_window()

        novel_name = unicode(novelname,'utf8')

        logfile = os.path.join(os.getcwd(), 'novel\\' + novel_name + '.txt')

        self.log = LogFile.LogFile(logfile)

        self.websearch_url = websearch_url

    def scroll_foot(self):

        '''

                滚动条拉到底部

                :return:

                '''

        js = ""

        # 如何利用chrome驱动或phantomjs抓取

        if self.driver.name == "chrome" or self.driver.name == 'phantomjs':

            js = "var q=document.body.scrollTop=10000"

        # 如何利用IE驱动抓取

        elif self.driver.name == 'internet explorer':

            js = "var q=document.documentElement.scrollTop=10000"

        return self.driver.execute_script(js)

    def scrapy_date(self):

        self.driver.get( self.websearch_url)

        htext = self.driver.execute_script("return document.documentElement.outerHTML")

        dochtml = pq(htext)

        Elements = dochtml('div[class="novel_list"]').find('ul').find('li').find('a')

        for e in Elements.items():

            url = 'http://www.shanxixsa.com/sxtvi/21/21051/'+e.attr('href')

            txt = e.text().encode('utf8').strip()

            print txt

            self.log.WriteLog(txt)

            self.driver.get(url)

            shtext = self.driver.execute_script("return document.documentElement.outerHTML")

            sdochtml = pq(shtext)

            sElements = sdochtml('div[ID="novel_content"]')

            for se in sElements.items():

                stxt = se.text().encode('utf8').strip()

                self.log.WriteLog(stxt)

obj = downfile('http://www.shanxixsa.com/sxtvi/21/21051/index.html','官场风月')

obj.scrapy_date()

# -*- coding: utf-8 -*-

import os

import codecs

import datetime

import time

import logging

#封装logging日志

class LogFile:

    # def __init__(self,fileName):

    #     self.fileName = os.path.join(os.getcwd(), fileName)

    # def WriteLog(self,message):

    #     strMessage = '\r\n%s: %s' % (time.strftime('%Y-%m-%d_%H-%M-%S'), message)

    #     with open(self.fileName, 'a') as f:

    #         f.write(strMessage)

    #构造函数 fileName:文件名

    def __init__(self,fileName,level=logging.INFO):

        fh = logging.FileHandler(fileName)

        self.logger = logging.getLogger()

        self.logger.setLevel(level)

        # formatter = logging.Formatter('%(asctime)s : %(message)s','%Y-%m-%d %H:%M:%S')

        formatter = logging.Formatter('%(message)s', '%Y-%m-%d %H:%M:%S')

        fh.setFormatter(formatter)

        self.logger.addHandler(fh)

    def WriteLog(self,message):

        self.logger.info(message)

    def WriteErrorLog(self,message):

        self.logger.setLevel(logging.ERROR)

        self.logger.error(message)
python 下载小说的更多相关文章
- 批量下载小说网站上的小说(python爬虫)
随便说点什么 因为在学python,所有自然而然的就掉进了爬虫这个坑里,好吧,主要是因为我觉得爬虫比较酷,才入坑的. 想想看,你可以批量自动的采集互联网上海量的资料数据,是多么令人激动啊! 所以我就被 ...
- python爬虫之小说网站--下载小说(正则表达式)
python爬虫之小说网站--下载小说(正则表达式) 思路: 1.找到要下载的小说首页,打开网页源代码进行分析(例:https://www.kanunu8.com/files/old/2011/244 ...
- 使用Python开发小说下载器,不再为下载小说而发愁 #华为云·寻找黑马程序员#
需求分析 免费的小说网比较多,我看的比较多的是笔趣阁.这个网站基本收费的章节刚更新,它就能同步更新,简直不要太叼.既然要批量下载小说,肯定要分析这个网站了- 在搜索栏输入地址后,发送post请求获取数 ...
- 【Python 爬虫系列】从某网站下载小说《鬼吹灯》,正则解析html
import re import urllib.request import urllib.parse import urllib.error as err import time # 下载 seed ...
- 从网上下载小说_keywords:python、multiprocess
# -*- coding: utf-8 -*- __author__ = "YuDian" from multiprocessing import Pool # Pool用来创建进 ...
- Python下载网页的几种方法
get和post方式总结 get方式:以URL字串本身传递数据参数,在服务器端可以从'QUERY_STRING'这个变量中直接读取,效率较高,但缺乏安全性,也无法来处理复杂的数据(只能是字符串,比如在 ...
- 【python 下载】-各种版本都有!
python 是一种全功能的语言,2.7很稳定,成熟的版本,且有很多开源的模块. 小编个人觉得python有一个很大的优点,就是语法简练,甚至可以说简单.比起pascal或者 C什么的,简单的难以置信 ...
- Python下载Yahoo!Finance数据
Python下载Yahoo!Finance数据的三种工具: (1)yahoo-finance package. (2)ystockquote. (3)pandas.
- [转] 三种Python下载url并保存文件的代码
原文 三种Python下载url并保存文件的代码 利用程序自己编写下载文件挺有意思的. Python中最流行的方法就是通过Http利用urllib或者urllib2模块. 当然你也可以利用ftplib ...
随机推荐
- 《linux下进程的创建,执行,监控和终止》
<linux下进程的创建,执行,监控和终止> http://blog.csdn.net/miss_acha/article/details/43671047 http://blog.csd ...
- springcloud+eureka简单入门案例
springcloud+eureka简单入门案例 一.服务提供者 直接提供服务,入门案例没有特别要设置的地方,注意下端口,由于要启动多个服务,可能会冲突 配置文件(src/main/resources ...
- [ python3 ] 基于zabbix 自动生成xlsx监控文档
准备做一个每周自动的巡检报告,数据来源于zabbix,通过python读取zabbix数据库获取数据并制作成excel表格, 本来打算直接邮件发送到指定邮箱,但是都被SMTP过滤掉了,试过126和QQ ...
- css左右箭头
.record-left{ content: ""; width: 0; height: 0; float: left; border-top: 10px solid transp ...
- 手工安装kubernetes
参考的URL是 http://www.cnblogs.com/zhenyuyaodidiao/p/6500830.html 安装kubernets本身比较顺利,只是作dashboard时,老是日文版, ...
- thinkphp5最美跳转页面
声明下:此教程来自TP官网,如果需要看原文,请点击一下链接 http://www.thinkphp.cn/code/3437.html 先给大家看下效果: 直接撸代码: 第一步:为了增加对移动设备 ...
- c#实现Form窗体始终在桌面最前端显示
方法一 //调用API [System.Runtime.InteropServices.DllImport("user32", CharSet = System.Runtime.I ...
- PHP的文件操作类
<?php class file { function file() { die("Class file can not instantiated!"); } //创建目录 ...
- uiautomator2 +Python进行Android原生应用UI测试
uiautomator2封装了google的uiautomator(只能用java),uiautomator2可以使用脚本语言python进行编写,更简单直观地修改.运行自动化测试代码: 不足为:仅支 ...
- oracle delete all index own by table
BEGIN FOR ind IN (SELECT index_name FROM user_indexes WHERE table_name = '') LOOP execute immediate ...