
深度学习常见的优化方法(Optimizer)总结:Adam,SGD,Momentum,AdaGard等
机器学习的常见优化方法在最近的学习中经常遇到,但是还是不够精通.将自己的学习记录下来,以备不时之需
基础知识:
机器学习几乎所有的算法都要利用损失函数 lossfunction 来检验算法模型的优劣,同时利用损失函数来提升算法模型.
这个提升的过程就叫做优化(Optimizer)
下面这个内容主要就是介绍可以用来优化损失函数的常用方法
常用的优化方法(Optimizer):
1.SGD&BGD&Mini-BGD:
SGD(stochastic gradient descent):随机梯度下降,算法在每读入一个数据都会立刻计算loss function的梯度来update参数.假设loss function为L(w),下同.\[w-=\eta \bigtriangledown_{w_{i}}L(w_{i}) \]
Pros:收敛的速度快;可以实现在线更新;能够跳出局部最优
Cons:很容易陷入到局部最优,困在马鞍点.
BGD(batch gradient descent):批量梯度下降,算法在读取整个数据集后累加来计算损失函数的的梯度
\[w-=\eta \bigtriangledown_{w}L(w)\]
Pros:如果loss function为convex,则基本可以找到全局最优解
Cons:数据处理量大,导致梯度下降慢;不能实时增加实例,在线更新;训练占内存
Mini-BGD(mini-batch gradient descent):顾名思义,选择小批量数据进行梯度下降,这是一个折中的方法.采用训练集的子集(mini-batch)来计算loss function的梯度.\[w-=\eta \bigtriangledown_{w_{i:i+n}}L(w_{i:i+n})\]
这个优化方法用的也是比较多的,计算效率高而且收敛稳定,是现在深度学习的主流方法.上面的方法都存在一个问题,就是update更新的方向完全依赖于计算出来的梯度.很容易陷入局部最优的马鞍点.能不能改变其走向,又保证原来的梯度方向.就像向量变换一样,我们模拟物理中物体流动的动量概念(惯性).引入Momentum的概念.
- 2.Momentum
在更新方向的时候保留之前的方向,增加稳定性而且还有摆脱局部最优的能力\[\Delta w=\alpha \Delta w- \eta \bigtriangledown L(w)\] \[w=w+\Delta w\]
若当前梯度的方向与历史梯度一致(表明当前样本不太可能为异常点),则会增强这个方向的梯度,若当前梯度与历史梯方向不一致,则梯度会衰减。一种形象的解释是:我们把一个球推下山,球在下坡时积聚动量,在途中变得越来越快,\(\eta\)可视为空气阻力,若球的方向发生变化,则动量会衰减。 - 3.Adagrad:(adaptive gradient)自适应梯度算法,是一种改进的随机梯度下降算法.
以前的算法中,每一个参数都使用相同的学习率\(\alpha\). Adagrad算法能够在训练中自动对learning_rate进行调整,出现频率较低参数采用较大的\(\alpha\)更新.出现频率较高的参数采用较小的\(\alpha\)更新.根据描述这个优化方法很适合处理稀疏数据.\[G=\sum ^{t}_{\tau=1}g_{\tau} g_{\tau}^{T} 其中 s.t. g_{\tau}=\bigtriangledown L(w_{i})\] 对角线矩阵\[G_{j,j}=\sum _{\tau=1}^{t} g_{\tau,j\cdot}^{2}\] 这个对角线矩阵的元素代表的是参数的出现频率.每个参数的更新\[w_{j}=w_{j}-\frac{\eta}{\sqrt{G_{j,j}}}g_{j}\] - 4.RMSprop:(root mean square propagation)也是一种自适应学习率方法.不同之处在于,Adagrad会累加之前所有的梯度平方,RMProp仅仅是计算对应的平均值.可以缓解Adagrad算法学习率下降较快的问题.\[v(w,t)=\gamma v(w,t-1)+(1-\gamma)(\bigtriangledown L(w_{i}))^{2} ,其中 \gamma 是遗忘因子\] 参数更新\[w=w-\frac{\eta}{\sqrt{v(w,t)}}\bigtriangledown L(w_{i})\]
5.Adam:(adaptive moment estimation)是对RMSProp优化器的更新.利用梯度的一阶矩估计和二阶矩估计动态调整每个参数的学习率.
优点:每一次迭代学习率都有一个明确的范围,使得参数变化很平稳.
\[m_{w}^{t+1}=\beta_{1}m_{w}^{t}+(1-\beta_{1}) \bigtriangledown L^{t} ,m为一阶矩估计\]
\[v_{w}^{t+1}=\beta_{2}m_{w}^{t}+(1-\beta_{2}) (\bigtriangledown L^{t})^{2},v为二阶矩估计\]
\[\hat{m}_{w}=\frac{m_{w}^{t+1}}{1-\beta_{1}^{t+1}},估计校正,实现无偏估计\]
\[\hat{v}_{w}=\frac{v_{w}^{t+1}}{1-\beta_{2}^{t+1}}\]
\[w^{t+1} \leftarrow=w^{t}-\eta \frac{\hat{m}_{w}}{\sqrt{\hat{v}_{w}}+\epsilon}\]
Adam是实际学习中最常用的算法
优化方法在实际中的直观体验
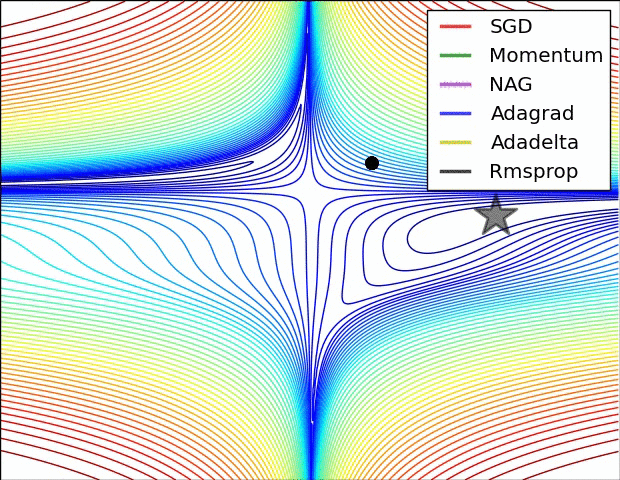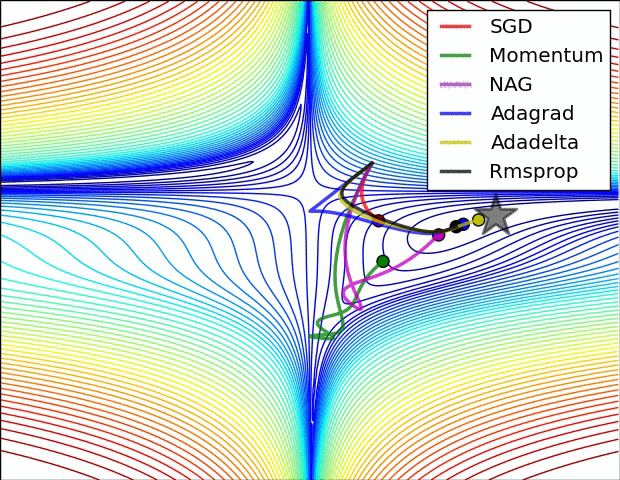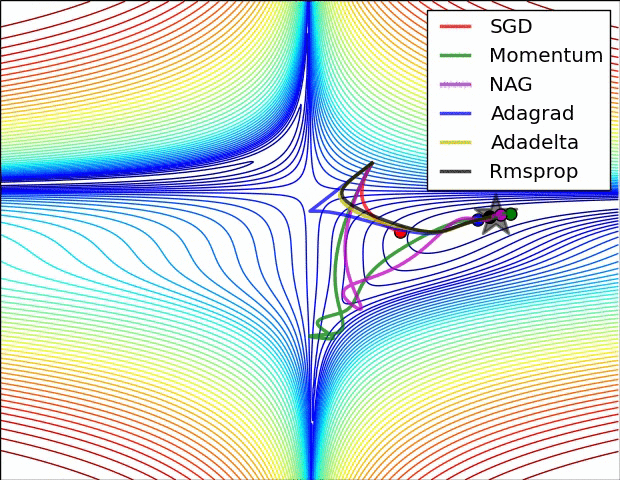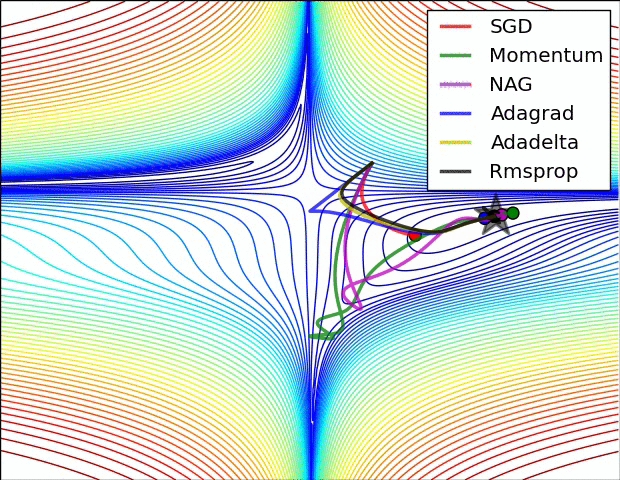
损失曲面的轮廓和不同优化算法的时间演化。 注意基于动量的方法的“过冲”行为,这使得优化看起来像一个滚下山的球
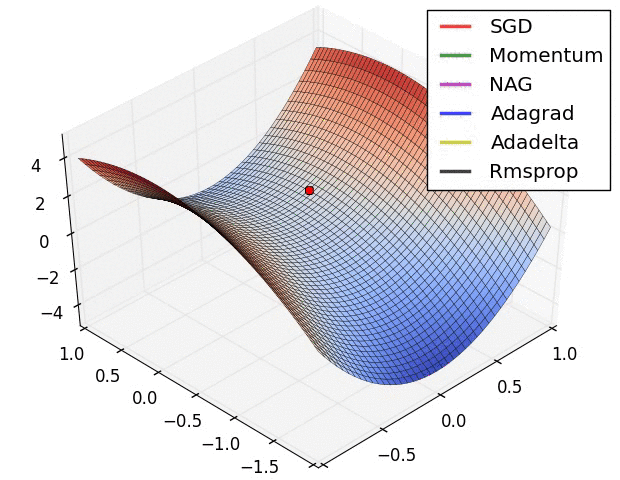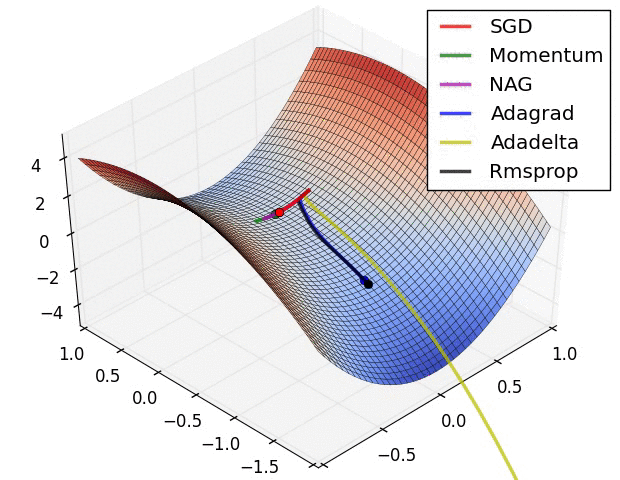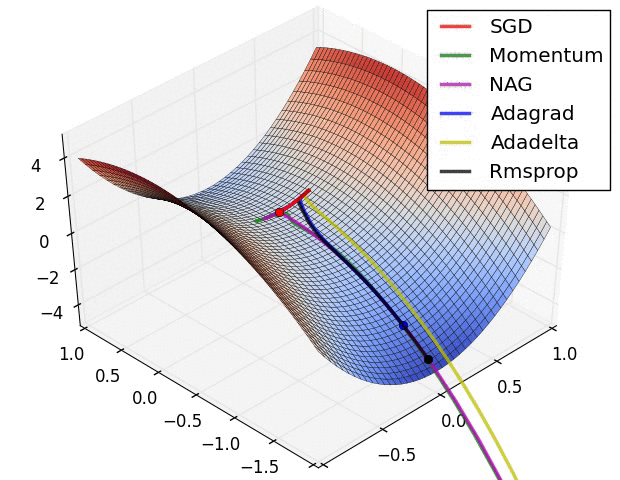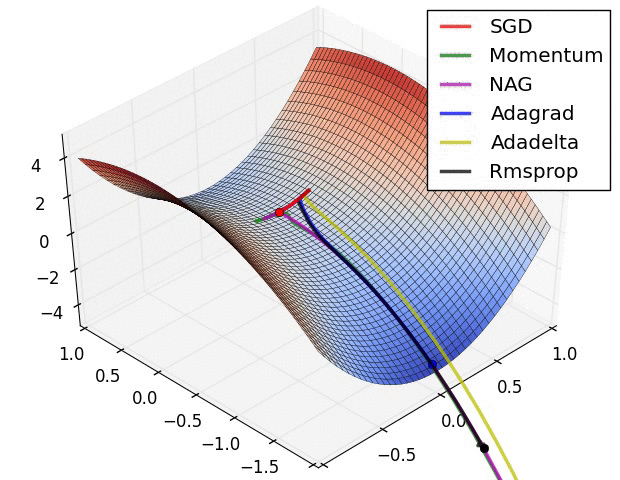
优化环境中鞍点的可视化,其中沿不同维度的曲率具有不同的符号(一维向上弯曲,另一维向下)。 请注意,SGD很难打破对称性并陷入困境。 相反,诸如RMSprop之类的算法将在鞍座方向上看到非常低的梯度。 由于RMSprop更新中的分母术语,这将提高此方向的有效学习率,从而帮助RMSProp继续进行.
参考文献:
深度学习常见的优化方法(Optimizer)总结:Adam,SGD,Momentum,AdaGard等的更多相关文章
- 深度学习笔记:优化方法总结(BGD,SGD,Momentum,AdaGrad,RMSProp,Adam)
深度学习笔记:优化方法总结(BGD,SGD,Momentum,AdaGrad,RMSProp,Adam) 深度学习笔记(一):logistic分类 深度学习笔记(二):简单神经网络,后向传播算法及实现 ...
- 各种优化方法总结比较(sgd/momentum/Nesterov/adagrad/adadelta)
前言 这里讨论的优化问题指的是,给定目标函数f(x),我们需要找到一组参数x,使得f(x)的值最小. 本文以下内容假设读者已经了解机器学习基本知识,和梯度下降的原理. SGD SGD指stochast ...
- 深度学习编译与优化Deep Learning Compiler and Optimizer
深度学习编译与优化Deep Learning Compiler and Optimizer
- 基于NVIDIA GPUs的深度学习训练新优化
基于NVIDIA GPUs的深度学习训练新优化 New Optimizations To Accelerate Deep Learning Training on NVIDIA GPUs 不同行业采用 ...
- Android中ListView的几种常见的优化方法
Android中的ListView应该算是布局中几种最常用的组件之一了,使用也十分方便,下面将介绍ListView几种比较常见的优化方法: 首先我们给出一个没有任何优化的Listview的Adapte ...
- 优化方法总结以及Adam存在的问题(SGD, Momentum, AdaDelta, Adam, AdamW,LazyAdam)
优化方法总结以及Adam存在的问题(SGD, Momentum, AdaDelta, Adam, AdamW,LazyAdam) 2019年05月29日 01:07:50 糖葫芦君 阅读数 455更多 ...
- 深度学习最全优化方法总结比较(SGD,Adagrad,Adadelta,Adam,Adamax,Nadam)(转)
转自: https://zhuanlan.zhihu.com/p/22252270 ycszen 另可参考: https://blog.csdn.net/llx1990rl/article/de ...
- 机器学习优化方法总结比较(SGD,Adagrad,Adadelta,Adam,Adamax,Nadam)
SGD: 此处的SGD指mini-batch gradient descent,关于batch gradient descent, stochastic gradient descent, 以及 mi ...
- 几种优化方法的整理(SGD,Adagrad,Adadelta,Adam)
参考自: https://zhuanlan.zhihu.com/p/22252270 常见的优化方法有如下几种:SGD,Adagrad,Adadelta,Adam,Adamax,Nadam 1. SG ...
随机推荐
- 《JSP数据交互总结》
1.1.1为什么需要动态网页 静态网页的内容是固定的,不能提供个性化和定制化的服务,因此,动态网页技术逐渐发展起来. 1.1.2什么是动态页面 动态网页是指在服务器端运行的使用程序语言设计的交互式网页 ...
- Shell基本语法---shell的变量以及常见符号
变量 1. 不同于其它语言需要先声明变量 2 .等号的两边不能有空格 3. 调用变量: $a 或者 ${a} a=; echo $a; echo ${a} 变量 变量意思 $? 判断上一条命令执行的 ...
- R语言学习笔记——C#中如何使用R语言setwd()函数
在R语言编译器中,设置当前工作文件夹可以用setwd()函数. > setwd("e://桌面//")> setwd("e:\桌面\")> s ...
- nginx 301跳转https后post请求失效问题解决
app本地请求是http端口,后来升级https强制301跳转,设置如下 server { listen 80; server name www.XXX.com; rewrite ^/(.*)$ ht ...
- java课堂_动手动脑4
1.请运行以下示例代码StringPool.java,查看其输出结果.如何解释这样的输出结果?从中你能总结出什么? 答:在Java中,内容相同的字串常量(“Hello”)只保存一份以节约内存,所以s0 ...
- Unity实现放大缩小以及相机位置平移实现拖拽效果
放大缩小功能是游戏开发中用到的功能,今天就来讲一下Unity中放大缩小怎么实现. 1.IDragHandler, IBeginDragHandler, IEndDragHandler这三个接口是Uni ...
- IBM实习工作(一)
2019.1.21 今天的任务是完成会计是否在岗配置表格增加操作记录,任务描述:1. [会计是否在岗配置] 查询结果界面: 修改人编码/修改人/修改时间 字段:2. 字段取值为[会计是否在 ...
- HTML文件上传与下载
文件下载 传统的文件下载有两种方法: 使用<a/>标签,href属性直接连接到服务器的文件路径 window.location.href="url" 这两种方法效果一样 ...
- Tomcat源码分析 (七)----- Tomcat 启动过程(二)
在上一篇文章中,我们分析了tomcat的初始化过程,是由Bootstrap反射调用Catalina的load方法完成tomcat的初始化,包括server.xml的解析.实例化各大组件.初始化组件等逻 ...
- error LNK2001: unresolved external symbol "__declspec(dllimport)
作为C++的小白,出现这个错误,是最头痛的.针对这种问题,我搜了网上的相关答案,很多都是在教Project ---> Settings中改动相关设置.我改了之后,问题依旧没有解决.后面查了这种问 ...