
selenium获取页面源码,判断是否存在指定内容,执行不同的操作
本案例用于解决selenium UI自动化,判断页面是否存在指定文字,执行后续不同的操作
主要用到browser.page_source
如,保存百度分享文件到自己的百度盘中,会出现文件被删除无法保存的情况
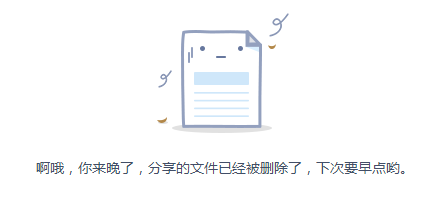
如果不做判断,脚本即停止
在脚本中加入下面的内容,即可解决这个问题。
browser.page_source获取当前页源码
if u"分享的文件已经被删除了" in browser.page_source:#如果文件被删除,跳过本次循环,重新一轮循环开始

   continue

else:
整个脚本如下:
def keep():

    for line in open('C:\\Users\\Beckham\\Desktop\\python\\1.txt'):#循环读取百度地址和提取码

        address = line[0:47]#分离出百度盘地址

        code = line[47:51]#分割出提取码

        browser.get(address)#打开链接

        if u"分享的文件已经被删除了" in browser.page_source:#如果文件被删除,跳过本次循环,重新一轮循环开始

            continue

        else:

            browser.find_element_by_id("ksrmwk1v").send_keys(code)#输入提取码

            time.sleep(2)

            browser.find_element_by_xpath("//span[contains(text(),'提取文件')]").click()

            time.sleep(2)

            browser.find_element_by_xpath("//span[contains(text(),'保存到网盘')]").click()

            time.sleep(2)

            browser.find_element_by_xpath("//span[contains(text(),'taotu8')]").click()

            time.sleep(2)

            browser.find_element_by_xpath("//span[contains(text(),'确定')]").click()

            time.sleep(5)

keep()
完
selenium获取页面源码,判断是否存在指定内容,执行不同的操作的更多相关文章
- UI自动化之特殊处理四(获取元素属性\爬取页面源码\常用断言)
获取元素属性\爬取页面源码\常用断言,最终目的都是为了验证我们实际结果是否等于预期结果 目录 1.获取元素属性 2.爬取页面源码 3.常用断言 1.获取元素属性 获取title:driver.titl ...
- 2.18 爬页面源码(page_source)
2.18 爬页面源码(page_source) 前言有时候通过元素的属性的查找页面上的某个元素,可能不太好找,这时候可以从源码中爬出想要的信息.selenium的page_source方法可以获取到页 ...
- Selenium2+python自动化37-爬页面源码(page_source)
前言 有时候通过元素的属性的查找页面上的某个元素,可能不太好找,这时候可以从源码中爬出想要的信息.selenium的page_source方法可以获取到页面源码. selenium的page_sour ...
- Selenium2+python自动化37-爬页面源码(page_source)【转载】
前言 有时候通过元素的属性的查找页面上的某个元素,可能不太好找,这时候可以从源码中爬出想要的信息.selenium的page_source方法可以获取到页面源码. selenium的page_sour ...
- selenium3 + python - page_source页面源码
前言: 有时候通过元素的属性的查找页面上的某个元素,可能不太好找,这时候可以从源码中爬出想要的信息.selenium的page_source方法可以获取到页面源码. 本次以博客园为例,先爬取页面源码, ...
- Python3+Selenium3+webdriver学习笔记10(元素属性、页面源码)
#!/usr/bin/env python# -*- coding:utf-8 -*-'''Selenium3+webdriver学习笔记10(元素属性.页面源码)'''from selenium i ...
- 在线制作微信跳转浏览器下载app/打开指定页面源码
微信自动跳转外部浏览器下载app/打开指定页面源码 源码说明: 适用安卓和苹果系统,支持任何网页链接.并且无论链接是否已经被微信拦截,均可实现微信内自动跳转浏览器打开. 生成的跳转链接具有极佳的防拦截 ...
- selenium3+python3.6爬页面源码的代码
from selenium import webdriver import unittest,time class my_test(unittest.TestCase): def setUp(self ...
- 简洁404页面源码 | 自适应404页面HTML好看的404源码下载
description:源码 源码下载 源码网 源码自适应 源码图片 页面源码 页面源码下载 错误页源码 php源码 html源码 动漫 源码 演示图如下: HTML代码片段: 1 <!DOCT ...
随机推荐
- sparksql 练习题两道
第一题:select '{"id":1,"name":{"url":"http://xxx/yyy/zz/test.js" ...
- JMeter FTP测试计划
为了演示测试目的,我们将使用公共可用的FTP位置,可以使用它来测试文件的下载. 您可以使用市场上现有的任何可用的演示FTP位置.我们使用URL下的FTP位置: https://dlptest.com/ ...
- 用VISA工具驱动继电器外设
1.驱动方式:TCP 2.开发过程 第一步:外设识别 TCP方式将继电器插上网线后,并不能像串口一样自动识别到这个外设,需要手动连接.打开NI MAX后,右击设备与接口,然后点击新建,双击VISA T ...
- Java面向对象程序设计第9章1-9
Java面向对象程序设计第9章1-9 1. 线程和进程的联系和区别是什么? 联系: 一个进程可以包括多个线程. 区别: 进程: 进程是一个具有一定独立功能的程序关于某个数据集合的一次运行活动,它是系统 ...
- 深入浅出ES6的标准内置对象Proxy
Proxy是ES6规范定义的标准内置对象,可以对目标对象的读取.函数调用等操作进行拦截.一般来说,通过Proxy可以让目标对象"可控",比如是否能调用对象的某个方法,能否往对象添加 ...
- ConcurrentHashMap 原理解析
为什么要用ConcurrentHashMap HashMap线程不安全,而Hashtable是线程安全,但是它使用了synchronized进行方法同步,插入.读取数据都使用了synchronized ...
- 20191024-3 互评Alpha阶段作品——构建之法组
此作业要求参见:https://edu.cnblogs.com/campus/nenu/2019fall/homework/9860 基于NABCD评论作品,及改进建议 1.根据(不限于)NABCD评 ...
- acwing 1250. 格子游戏 并查集
地址 https://www.acwing.com/problem/content/1252/ Alice和Bob玩了一个古老的游戏:首先画一个 n×nn×n 的点阵(下图 n=3n=3 ). 接着, ...
- jedis的scan操作要注意cursor数据类型
环境 jedis3.0.0 背景 在使用jedis的"scan"操作获取redis中某些key时,发现总是出现类型转换的异常--"java.lang.ClassCastE ...
- Redis内存碎片清理
当Redis中清理了大量的Key之后原先Redis申请的内存(used_memory_rss)将继续持有而不会释放,此时查看内存信息将会看到存在大量的内存碎片.那么,Redis的内存碎片可以清理么,该 ...