
hive grouping sets 等聚合函数
函数说明:
grouping sets
在一个 group by 查询中,根据不同的维度组合进行聚合,等价于将不同维度的 group by 结果集进行 union all
cube
根据 group by 的维度的所有组合进行聚合
rollup
是 cube 的子集,以最左侧的维度为主,从该维度进行层级聚合。
-- grouping sets

select

       order_id,

       departure_date,

       count(*) as cnt

  from ord_test

 where order_id=410341346

 group by order_id,

       departure_date

 grouping sets (order_id,(order_id,departure_date))

;

---- 等价于以下

group by order_id

union all

group by order_id,departure_date

-- cube

select

       order_id,

       departure_date,

       count(*) as cnt

  from ord_test

 where order_id=410341346

 group by order_id,

       departure_date

 with cube

 ;

---- 等价于以下

select count(*) as cnt from ord_test where order_id=410341346

union all

group by order_id

union all

group by departure_date

union all

group by order_id,departure_date

-- rollup

select

       order_id,

       departure_date,

       count(*) as cnt

  from ord_test

 where order_id=410341346

 group by order_id,

       departure_date

 with rollup

 ;

---- 等价于以下

select count(*) as cnt from ord_test where order_id=410341346

union all

group by order_id

union all

group by order_id,departure_date
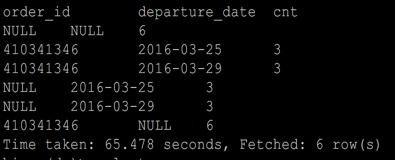
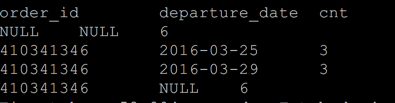
结果:grouping_sets, cube, rollup

hive grouping sets 等聚合函数的更多相关文章
- hive grouping sets 实现原理
先下结论: 看了hive 1.1.0 grouping sets 实现(从源码及执行计划都可以看出与kylin实现不一样),(前提是可累加,如sum函数)他并没有像kylin一样先按照group by ...
- 9.hive聚合函数,高级聚合,采样数据
本文主要使用实例对Hive内建的一些聚合函数.分析函数以及采样函数进行比较详细的讲解. 一.基本聚合函数 数据聚合是按照特定条件将数据整合并表达出来,以总结出更多的组信息.Hive包含内建的一些基本聚 ...
- 解析数仓OLAP函数:ROLLUP、CUBE、GROUPING SETS
摘要:GaussDB(DWS) ROLLUP,CUBE,GROUPING SETS等OLAP函数的原理解析. 本文分享自华为云社区<GaussDB(DWS) OLAP函数浅析>,作者: D ...
- Hive学习之自己定义聚合函数
Hive支持用户自己定义聚合函数(UDAF),这样的类型的函数提供了更加强大的数据处理功能. Hive支持两种类型的UDAF:简单型和通用型.正如名称所暗示的,简单型UDAF的实现很easy,但因为使 ...
- SQL Server里Grouping Sets的威力
在SQL Server里,你有没有想进行跨越多个列/纬度的聚集操作,不使用SSAS许可(SQL Server分析服务).我不是说在生产里使用开发版,也不是说安装盗版SQL Server. 不可能的任务 ...
- SQL Server里Grouping Sets的威力【转】
在SQL Server里,你有没有想进行跨越多个列/纬度的聚集操作,不使用SSAS许可(SQL Server分析服务).我不是说在生产里使用开发版,也不是说安装盗版SQL Server. 不可能的任务 ...
- Hive高阶聚合函数 GROUPING SETS、Cube、Rollup
-- GROUPING SETS作为GROUP BY的子句,允许开发人员在GROUP BY语句后面指定多个统计选项,可以简单理解为多条group by语句通过union all把查询结果聚合起来结合起 ...
- Hive高级聚合GROUPING SETS,ROLLUP以及CUBE
scala> import org.apache.spark.sql.hive.HiveContextimport org.apache.spark.sql.hive.HiveContext s ...
- Hive函数:GROUPING SETS,GROUPING__ID,CUBE,ROLLUP
参考:lxw大数据田地:http://lxw1234.com/archives/2015/04/193.htm 数据准备: CREATE EXTERNAL TABLE test_data ( mont ...
随机推荐
- 170623、springboot编程之JdbcTemplate操作数据库
使用JdbcTemplate操作mysql数据库! 1.在pom中引入jpa包 <dependency> <groupId>org.springframework.boot&l ...
- 常用meta标签及说明
1.charset 定义文档的字符编码 例如: <meta charset="UTF-8"> 2. name 把 content 属性关联到一个名称,其属性有 ...
- Oracle数据类型char与varchar的对比
使用scott用户连接数据库 新建一个表 create table stu01(name char(32)); 插入一条数据 insert into stu01 values('liuyueming' ...
- pta 习题集 5-17九宫格输入法
假设有九宫格输入法键盘布局如下: [ 1,.?! ] [ 2ABC ] [ 3DEF ] [ 4GHI ] [ 5JKL ] [ 6MNO ] [ 7PQRS ] [ 8TUV ] [ 9WXYZ ] ...
- 聊一聊goroutine stack
通过阅读这篇文章对内存的处理以及栈的扩容有了新的认识,我们在生产环境中也遇到了内存使用量超大的情况,现在怀疑也可能是由于栈扩容导致的 很好的一片文章: 推送在外卖订餐中扮演着重要的角色,为商家实时接单 ...
- CRM - 起步
一.crm简介 crm 客户关系管理软件 ( Customer Relationship Management ) 二.起步 models.py 表结构 from django.db import m ...
- Python开发【笔记】:为什么pymysql重连后才能查到新添加的数据
PyMysql操控 问题描述: 之前做数据库模块的时候用到了pymysql,测试中发现了一个问题,创建两个程序,select.py从数据库中不断的读取,insert.py在数据库中插入多条数据,但是s ...
- DrawLayout使用侧滑抽屉
布局:fg_left_drawer <?xml version="1.0" encoding="utf-8"?> <LinearLayout ...
- spring boot开启事务管理,使用事务的回滚机制,使两条插入语句一致
spring boot 事务管理,使用事务的回滚机制 1:配置事务管理 在springboot 启动类中添加 @EnableTransactionManagement //开启事务管理 @Enable ...
- Spark中RDD转换成DataFrame的两种方式(分别用Java和Scala实现)
一:准备数据源 在项目下新建一个student.txt文件,里面的内容为: ,zhangsan, ,lisi, ,wanger, ,fangliu, 二:实现 Java版: 1.首先新建一个s ...