
火山引擎ByteHouse:4000字总结,Serverless在OLAP领域应用的五点思考
更多技术交流、求职机会,欢迎关注字节跳动数据平台微信公众号,回复【1】进入官方交流群
作为云计算的下一个迭代,Serverless可以使开发者更专注于构建产品中的应用,而无需考虑底层堆栈问题。伴随着近年来相关技术成熟度的增加,市场对Serverless的接受程度也变得越来越高。可以说时至今日,Serverless已迈入了向成熟稳定方向发展的高速轨道。
作为一款火山引擎推出的云原生数据仓库,ByteHouse基于开源ClickHouse构建,并在字节跳动内外部场景的检验下,对OLAP引擎能力、性能、运维、架构进一步升级。除此之外,ByteHouse也在Serverless方向探索,基于cloud-native 云原生的理念构建了全新一代的数据仓库,架构上进行了三层解耦,期望在Serverless的加持下,提供更稳定、可靠、可信的分析服务,让开发人员时间精力从基础设施运维优化上解放,更聚焦在核心业务功能中。
本文来自于火山引擎ByteHouse产品负责人李群的分享,从场景选择、应用门槛、落地应用等5个方面,介绍Serverless在OLAP领域应用思考。
哪些应用场景适合选择Serverless架构?
在OLAP数据分析领域,我们先看哪些分析模式不适用于Serverless架构:
长任务,大Job:如果分析任务需要长时间运行(如超过20分钟),使用 Serverless 技术会受到限制。因为 Serverless 平台通常设置了最大运行时间的限制,超过限制时间会导致任务中断。
计算密集型:Serverless 技术通常适用于处理轻量级任务,而对于高计算密集型任务,需要更多计算资源,但行业上目前当前尚未有商用的Serverless 数据仓库能够提供超过2000 vcore的算力规模,而2000vcore折算成通用的物理机或裸金属,也不过是20台服务器的算力规模,往往一些中型的分析型系统的算力需求就远远超过这个规模。
高并发读写型:Serverless 技术特点是资源共享,对有高并发诉求的分析任务,很可能会出现性能瓶颈,一方面原因是共享资源池的规模上限,一方面是多租户对共享资源的争用。
负载模式稳定、波动少:Serverless 平台通常是按需运行,如果需要长时间运行的应用程序,则不适合使用 Serverless 技术。
总之,Serverless 技术适用于处理轻量级、耗时短、低并发型的分析业务,适用于负载模式有明显波动性特征的业务;也适用于管道型、中间件型的业务,如flink实时计算、kafka消息队列以及ETL任务执行等。
对于长时间运行、计算密集型、高并发读写、需要持续运行的分析业务则不适合使用 Serverless 技术。
应用Serverless技术存在哪些门槛
在OLAP领域,无论是经典的MPP架构向Serverless架构演进路径,还是基于Cloud-Native云原生理念全新构建的Serverless架构,都面临着同样的技术挑战:
存算分离
把计算和存储进行解耦,是Serverless架构关键的第一步,但其中的技术挑战非常大,例如:如何保障性能少劣化甚至不下降;近数据计算(NDP)技术,把哪些算子下推到存储侧;分布式缓存技术如何提高缓存的命中率,这些目的都是尽可能减少计算和存储之间的网络开销。
此外,从25GE网络,到RDMA/RoCE等高速网络,再到下一步的内存型网络的融合,如何减少延迟、提高吞吐也是业界在持续解决网络通信层面的难点之一。
计算无状态
计算侧通常还是采用经典的shared-nothing架构,具备良好的水平伸缩扩展性,但是计算侧的无状态化程度直接关系到弹性能力的优劣,这其中元数据的管理和同步、统计信息的自动化、优化器的智能化都是关键的技术难点。
形象一点描述,则是,在弹性过程中,背负东西越多,状态化越重,弹性效率就越低,用户体验越差。
全局资源调度
存储资源池化、计算池化、网络池化,未来还会实现内存池化等,而且理想的 Serverless 架构需要能够自动地根据用户请求的负载进行智能的动态伸缩,在不需要时自动释放资源,业务浪涌时自动分配更多资源。以上对全局的资源调度能力提出了更高的要求。
混合负载
在Serverless架构下,不同的租户在同一个计算资源池里提交各种类型的分析任务,如何给上层应用提供稳定可靠的SLA保障,混合负载管理的难度被进一步放大。
基于静态化的配额负载策略很难在Serverless的多租户模式下落地,需要逾越智能、动态的资源分配、限流、熔断等负载管理的技术难点。
如,“低效SQL耗尽资源”的老大难问题的影响半径在Serverless模式下会被放大,甚至是灾难性影响。
资源池上限
Serverless模式下,多租户都在共用一个资源池,理想上这个资源池应该可以无限扩展,但当前只有存储侧基本上做到这一点,计算侧资源池还是受限于软件能力会有一个天花板上限,比如说目前几款主流云厂商的Serverless的数据仓库还没有超过2000vcpu的算力规模。如果再叠加多租户并发的因素,将导致当前的Serverless架构在OLAP分析领域还比较难以大规模推广使用。
此外,旨在进一步降低计算侧负载而引入新硬件并提供池化服务,比如FPGA资源池,也是当前云场景的发力方向。围绕Serverless架构下的全场景多层级的数据安全也是要考虑的关键问题。
这里简单给大家分享一下ByteHouse在这方面的一些思考和实践:
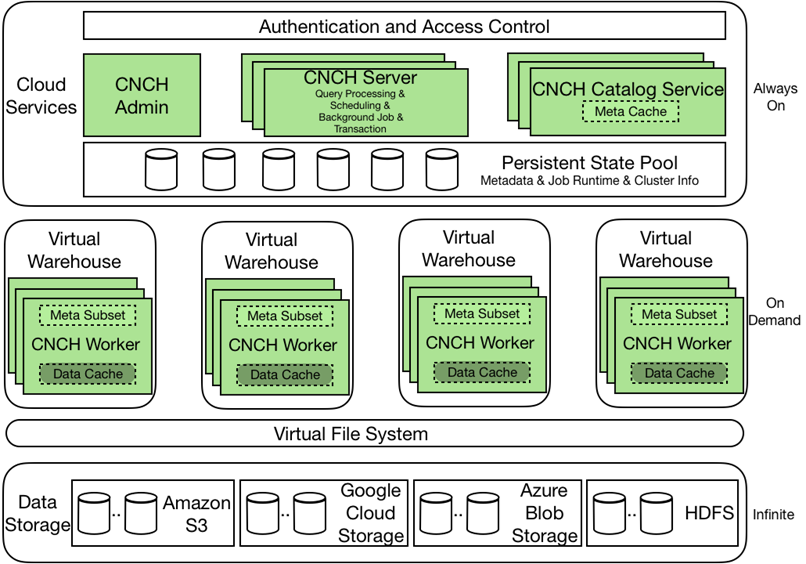
ByteHouse 基于cloud-native 云原生的理念构建了全新一代的数据仓库,架构上进行了三层解耦。由下向上看,
在存储层,ByteHouse 已经实现了Serverless化、弹性伸缩、容量无限扩展。为提升存算分离架构下的性能问题,在存储侧做了一系列的技术优化,比如
针对HDFS语义,合并小文件减少文件数、改进的Hedge Read、Fast Switch Read等使得带宽仅增加10%的情况下,延迟减少3倍;
针对S3语义,通过memory cache、独立IO线程池等技术提升数据的存取性能。
在网络通信上, 连接复用、RDMA、传输压缩等技术,大幅缓解了网络放大问题。
在中间的计算层,ByteHouse是通过virtual warehouse为用户提供弹性的计算服务,提供pay as you go的记账模式,为用户节省成本。
在技术上,ByteHouse实现了无状态化,基于容器化部署、秒级弹性伸缩、秒级按需启停。ByteHouse增强的本地缓存技术,使得数据预热、预取更加智能高效,缓存数据的命中率也更高。
在计算层,ByteHouse通过不同的VW来做负载隔离,如按读写进行隔离、按应用类别进行隔离,这种tenent-aware 租户感知的负载隔离模式虽然还不是Serverless模式,但是能在一定程度上满足用户的需求,也是向Serverless架构演进的路径之一。
在最上层的cloud services 云服务层,ByteHouse提供集中化的catalog 元数据服务、集群管理服务等。我们把元数据从计算层解耦出来,让计算层实现了无状态化,获得了秒级的弹性伸缩和启停能力。基于分布式 KV 的元数据存储,通过高效的part缓存技术,也进一步提升了元数据的访问性能。
如何看待可观测性和Serverless哲学相悖的问题?
随着Serverless的深入,人们发现Serverless架构下的问题定位比传统应用更困难。对此,一部分人认为应该支持可观测性的需求,另一部分人则认为可观测性与Serverless本质相悖,Serverless就是为了让用户不需要关心底层计算资源情况。
我认为,这个问题本质上是跟当前Serverless技术成熟度相关。举个例子,现在我们每天都在用水、用电,但是很少有人会再去关注怎么发电、如何配送,饮用水的处理环节等等,因为我们得到的用水、用电的服务标准是稳定的、可信的和可靠的,所以不再关注过程细节。
与此类似,Serverless 要实现的目标就是提供稳定、可靠和可信的分析服务,让开发人员不再把时间和精力花费在下层的基础设施和运维优化上,而是聚焦在业务功能的实现上面。
但是当前OLAP 数据分析领域的Serverless技术成熟度还远未达到这个目标,前面提到的一系列技术难点尚未完全解决,最简单的例子是如何解决困扰业界40多年的“低效SQL耗尽资源”的老大难问题,在 Serverless 模式下,账单跟资源用量紧密相关,账单上资源用量的合理性、可信性是客户当前的最大疑虑。
此外,通过日志记录、 跟踪监控、可视化指标等技术工具为用户提供过程中的可观测性,也是Serverless平台应该具备的能力,也能够增加用户对系统的信任感。
因此,两者并非相悖。我们相信会有一天Serverless会给用户带来标准、稳定、可靠、可信的分析服务,就像我们今天用水、用电一样。
落地Serverless,自研和云厂商方案如何选择?
21世纪最宝贵的还是人才。对企业来说,每一笔投入的目标都是围绕着如何去获取更深入本质的分析洞察、更灵敏的风控感知和预警、更快速的用户增长,所以说,企业的IT更多的是站在开发的视角去看待投入决策,使能业务,并能更近一步,让IT从传统的成本中心向赋能中心、盈利中心去演进,人才储备的重点是技术开发方向。
而云厂商的商业逻辑是为用户提供标准的云计算技术服务,通过持续、高强度的研发投入,为用户提供差异化的云服务,人才储备的重点是技术研发方向。开发和研发,仅一字之差,但含义迥异。
特别是对于OLAP 领域的Serverless技术实现来说,涉及到存储、网络、操作系统、数据库、AI等IT领域几乎全栈的技术点,更需要厂商做持续的、高成本的研发投入,而且这些投入短期内难见市场回报,一旦中途停顿则意味着前期的投入全都“打水漂”。
所以,对中小企业来说,还是建议在OLAP 领域的Serverless技术投入上保持慎重态度,对Serverless的技术研发、演进迭代还是交给技术人才储备更雄厚、技术投入也更专业的大型云厂商来做。
Serverless距离大规模应用还有多远?
在OLAP数据分析领域,虽然已经有几款商用的Serverless架构的数据仓库,但是前面提到的技术难点依然存在、尚未逾越,并且期提供的算力规模也很难支撑中大型规模的数据仓库或者分析平台的需求。
但是,Serverless的架构理念还是面向未来的,而且技术挑战也会随着时间的推移会有更好的应对方案和措施,并且当前也能够在部分中小型分析负载场景中适用和推广。
最后想提一点,影响Serverless大规模应用的因素,除了技术层面持续演进和迭代之外,另外一个非常关键的就是Serverless服务的标准化,尤其是对OLAP 分析领域。Serverless的初衷是让用户聚焦在业务实现上,但没有一个标准化的规范会导致用户被平台锁定,无法实现应用的平移、无缝搬迁,比如,用户无法把基于MySQL的应用无缝搬迁到PostgreSQL,因为下面的数据库是Serverless了,但是与业务逻辑进行交互的接口还没有标准化。因此,Serverless的规模化应用,还需要有与之配套的标准和规范体系。
总而言之,Serverless架构已经越来越受到欢迎,随着云计算和Serverless技术的进一步发展和完善,Serverless架构将在未来成为更多大规模应用的首选架构之一,用户会像今天用水、用电一样,方便、快捷地享用Serverless化的OLAP 数据分析服务。
点击跳转ByteHouse了解更多
火山引擎ByteHouse:4000字总结,Serverless在OLAP领域应用的五点思考的更多相关文章
- 高性能、快响应!火山引擎 ByteHouse 物化视图功能及入门介绍
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,回复[1]进入官方交流群 物化视图是指将视图的计算结果存储在数据库中的一种技术.当用户执行查询时,数据库会直接从已经预计算好的结果中获取数据 ...
- 火山引擎 DataLeap 的 Data Catalog 系统公有云实践
Data Catalog 通过汇总技术和业务元数据,解决大数据生产者组织梳理数据.数据消费者找数和理解数的业务场景.本篇内容源自于火山引擎大数据研发治理套件 DataLeap 中的 Data Ca ...
- JuiceFS 在火山引擎边缘计算的应用实践
火山引擎边缘云是以云计算基础技术和边缘异构算力结合网络为基础,构建在边缘大规模基础设施之上的云计算服务,形成以边缘位置的计算.网络.存储.安全.智能为核心能力的新一代分布式云计算解决方案. 01- 边 ...
- 火山引擎MARS-APM Plus x 飞书 |降低线上OOM,提高App性能稳定性
通过使用火山引擎MARS-APM Plus的memory graph功能,飞书研发团队有效分析定位问题线上case多达30例,线上OOM率降低到了0.8‰,降幅达到60%.大幅提升了用户体验,为飞书的 ...
- 还原火山引擎 A/B 测试产品——DataTester 私有化部署实践经验
作为一款面向ToB市场的产品--火山引擎A/B测试(DataTester)为了满足客户对数据安全.合规问题等需求,探索私有化部署是产品无法绕开的一条路. 在面向ToB客户私有化的实际落地中,火 ...
- 火山引擎DataLeap数据调度实例的 DAG 优化方案
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,并进入官方交流群 实例 DAG 介绍 DataLeap 是火山引擎自研的一站式大数据中台解决方案,集数据集成.开发.运维.治理.资产管理能力 ...
- 如何又快又好实现 Catalog 系统搜索能力?火山引擎 DataLeap 这样做
摘要 DataLeap 是火山引擎数智平台 VeDI 旗下的大数据研发治理套件产品,帮助用户快速完成数据集成.开发.运维.治理.资产.安全等全套数据中台建设,降低工作成本和数据维护成本.挖掘数据价 ...
- 火山引擎 DataLeap:3 个关键步骤,复制字节跳动一站式数据治理经验
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,并进入官方交流群 DataLeap 是火山引擎数智平台 VeDI 旗下的大数据研发治理套件产品,帮助用户快速完成数据集成.开发.运维.治理. ...
- 火山引擎 DataLeap:揭秘字节跳动数据血缘架构演进之路
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,回复[1]进入官方交流群 DataLeap 是火山引擎数智平台 VeDI 旗下的大数据研发治理套件产品,帮助用户快速完成数据集成.开发.运维 ...
- 火山引擎 DataLeap:一家企业,数据体系要怎么搭建?
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,回复[1]进入官方交流群 导读:经过十多年的发展,数据治理在传统行业以及新兴互联网公司都已经产生落地实践.字节跳动也在探索一种分布式的数据治 ...
随机推荐
- animate.css 动画库的下载与使用
作者:WangMin 格言:努力做好自己喜欢的每一件事 animate.css是什么? animate.css 是一个有趣,酷炫的,跨浏览器的动画库,里面包含了许多常用的css动画.你可以将它用于你的 ...
- 23. 从零用Rust编写正反向代理,流控小姐姐的温柔一刀!
wmproxy wmproxy已用Rust实现http/https代理, socks5代理, 反向代理, 静态文件服务器,四层TCP/UDP转发,内网穿透,后续将实现websocket代理等,会将实现 ...
- dmd-50
按r键将其转换为字符 再将其拷贝下来 将其md5解密 得到一串英文,根据wp需要再将其加密一下,不知道为啥,得到的md5即为flag
- Kernel Memory 入门系列:Kernel Memory Service
Kernel Memory 入门系列:Kernel Memory Service 在 Kernel Memory 的 GitHub 仓库中有一个单独的项目 Service , 用于提供独立的Kerne ...
- 如何通过port-forward命令在本地访问 k8s 集群服务
公众号「架构成长指南」,专注于生产实践.云原生.分布式系统.大数据技术分享 概述 在我们访问k8s中的pod服务时,一般通过node port映射pod端口进行访问,还有一种是通过ingress或者i ...
- 多维数组、Arrays类、稀疏数组、冒泡排序
多维数组 多维数组可以看成是数组的数组 比如二维数组就是一个特殊的一堆数组 其中每个元素就是一个数组. 二维数组: int a[][] = new int[2][5]; 解析:二维数组a可以看成一个两 ...
- ElasticSearch之Close index API
关闭指定的索引. 索引关闭之后: 停止对读.写操作的响应. 停止检索操作的响应. 在索引关闭前,允许执行的操作,关闭之后均不允许执行. ElasticSearch取消对索引的相关维护操作,包含内存中的 ...
- 案例分享-Exception.getMessage突然为null
背景 之前做的小工具一个jsqlparse+git做的小工具帮我节省时间摸鱼昨天突然停止工作,看了下jvm并没有退出,但是看日志确实有不少Error输出,虽说是一个普通的NPE,但是分析了一下却疑点重 ...
- K8s和声明式编程
转载:原文链接 认识k8s之后,他的操作模式对我来说是一种很不错的体验.他提供了更接近现实世界的面向对象接口. 什么是k8s? Kubernetes(K8s)是一种开源容器编排平台,用于自动化部署.扩 ...
- 微信小程序实时噪声分贝
为了做一个能够检测实时噪声分贝的小程序,网上找了很多例子,基本没有完整的代码,手写了一个,话不多说直接上效果图 实现实时录音的功能,并且能够根据声音分贝大小转动仪表盘显示实时的分贝,运用echart实 ...