
Pytorch多GPU训练
Pytorch多GPU训练
临近放假, 服务器上的GPU好多空闲, 博主顺便研究了一下如何用多卡同时训练
原理
多卡训练的基本过程
- 首先把模型加载到一个主设备
- 把模型只读复制到多个设备
- 把大的batch数据也等分到不同的设备
- 最后将所有设备计算得到的梯度合并更新主设备上的模型参数
代码实现(以Minist为例)
#!/usr/bin/python3

# coding: utf-8

import torch

from torchvision import datasets, transforms

import torchvision

from tqdm import tqdm

device_ids = [3, 4, 6, 7]

BATCH_SIZE = 64

transform = transforms.Compose([transforms.ToTensor(),

                               transforms.Normalize(mean=[0.5,0.5,0.5],std=[0.5,0.5,0.5])])

data_train = datasets.MNIST(root = "./data/",

                            transform=transform,

                            train = True,

                            download = True)

data_test = datasets.MNIST(root="./data/",

                           transform = transform,

                           train = False)

data_loader_train = torch.utils.data.DataLoader(dataset=data_train,

                                                # 这里注意batch size要对应放大倍数

                                                batch_size = BATCH_SIZE * len(device_ids),

                                                shuffle = True,

                                                 num_workers=2)

data_loader_test = torch.utils.data.DataLoader(dataset=data_test,

                                               batch_size = BATCH_SIZE * len(device_ids),

                                               shuffle = True,

                                                num_workers=2)

class Model(torch.nn.Module):

    def __init__(self):

        super(Model, self).__init__()

        self.conv1 = torch.nn.Sequential(

        torch.nn.Conv2d(1, 64, kernel_size=3, stride=1, padding=1),

        torch.nn.ReLU(),

        torch.nn.Conv2d(64, 128, kernel_size=3, stride=1, padding=1),

        torch.nn.ReLU(),

        torch.nn.MaxPool2d(stride=2, kernel_size=2),

    )

        self.dense = torch.nn.Sequential(

            torch.nn.Linear(14 * 14 * 128, 1024),

            torch.nn.ReLU(),

            torch.nn.Dropout(p=0.5),

            torch.nn.Linear(1024, 10)

    )

    def forward(self, x):

        x = self.conv1(x)

        x = x.view(-1, 14 * 14 * 128)

        x = self.dense(x)

        return x

model = Model()

model = torch.nn.DataParallel(model, device_ids=device_ids) # 声明所有可用设备

model = model.cuda(device=device_ids[0])  # 模型放在主设备

cost = torch.nn.CrossEntropyLoss()

optimizer = torch.optim.Adam(model.parameters())

n_epochs = 50

for epoch in range(n_epochs):

    running_loss = 0.0

    running_correct = 0

    print("Epoch {}/{}".format(epoch, n_epochs))

    print("-"*10)

    for data in tqdm(data_loader_train):

        X_train, y_train = data

        # 注意数据也是放在主设备

        X_train, y_train = X_train.cuda(device=device_ids[0]), y_train.cuda(device=device_ids[0])

        outputs = model(X_train)

        _,pred = torch.max(outputs.data, 1)

        optimizer.zero_grad()

        loss = cost(outputs, y_train)

        loss.backward()

        optimizer.step()

        running_loss += loss.data.item()

        running_correct += torch.sum(pred == y_train.data)

    testing_correct = 0

    for data in data_loader_test:

        X_test, y_test = data

        X_test, y_test = X_test.cuda(device=device_ids[0]), y_test.cuda(device=device_ids[0])

        outputs = model(X_test)

        _, pred = torch.max(outputs.data, 1)

        testing_correct += torch.sum(pred == y_test.data)

    print("Loss is:{:.4f}, Train Accuracy is:{:.4f}%, Test Accuracy is:{:.4f}".format(running_loss/len(data_train),

                                                                                      100*running_correct/len(data_train),

                                                                                      100*testing_correct/len(data_test)))

torch.save(model.state_dict(), "model_parameter.pkl")
结果分析
可以通过nvidia-smi清楚地看到3, 4, 6, 7卡在计算/usr/bin/python3进程(进程号都为34930)
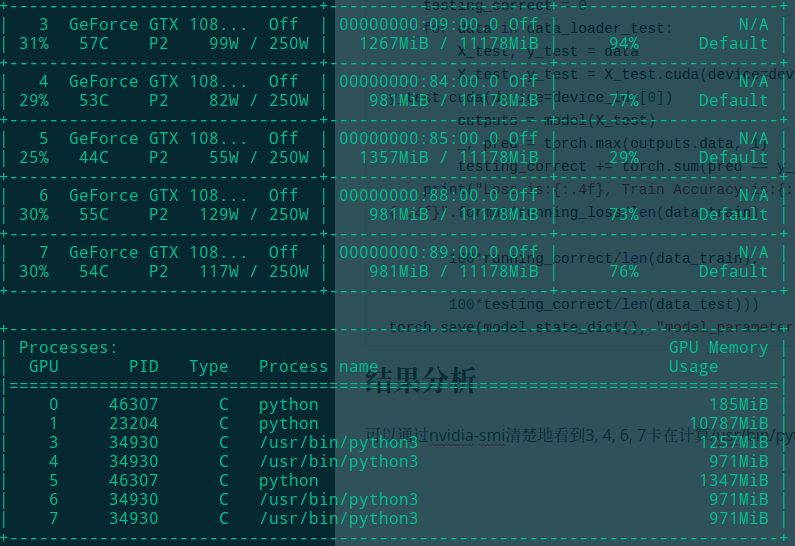
从实际加速效果来看, 由于minist是小数据集, 可能调度带来的overhead反而比计算的开销大, 因此加速不明显. 但是到大数据集上训练时, 多卡的优势就会体现出来了
Pytorch多GPU训练的更多相关文章
- pytorch 多GPU训练总结(DataParallel的使用)
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明.本文链接:https://blog.csdn.net/weixin_40087578/artic ...
- pytorch 指定GPU训练
# 1: torch.cuda.set_device(1) # 2: device = torch.device("cuda:1") # 3:(官方推荐)import os os. ...
- pytorch 多GPU训练过程中出现ap=0情况
原因可能是pytorch 自带的BN bug:安装nvidia apex 可以解决: $ git clone https://github.com/NVIDIA/apex $ cd apex $ pi ...
- Pytorch中多GPU训练指北
前言 在数据越来越多的时代,随着模型规模参数的增多,以及数据量的不断提升,使用多GPU去训练是不可避免的事情.Pytorch在0.4.0及以后的版本中已经提供了多GPU训练的方式,本文简单讲解下使用P ...
- PyTorch Tutorials 4 训练一个分类器
%matplotlib inline 训练一个分类器 上一讲中已经看到如何去定义一个神经网络,计算损失值和更新网络的权重. 你现在可能在想下一步. 关于数据? 一般情况下处理图像.文本.音频和视频数据 ...
- Pytorch使用分布式训练,单机多卡
pytorch的并行分为模型并行.数据并行 左侧模型并行:是网络太大,一张卡存不了,那么拆分,然后进行模型并行训练. 右侧数据并行:多个显卡同时采用数据训练网络的副本. 一.模型并行 二.数据并行 数 ...
- MinkowskiEngine多GPU训练
MinkowskiEngine多GPU训练 目前,MinkowskiEngine通过数据并行化支持Multi-GPU训练.在数据并行化中,有一组微型批处理,这些微型批处理将被送到到网络的一组副本中. ...
- 使用Deeplearning4j进行GPU训练时,出错的解决方法
一.问题 使用deeplearning4j进行GPU训练时,可能会出现java.lang.UnsatisfiedLinkError: no jnicudnn in java.library.path错 ...
- tensorflow使用多个gpu训练
关于多gpu训练,tf并没有给太多的学习资料,比较官方的只有:tensorflow-models/tutorials/image/cifar10/cifar10_multi_gpu_train.py ...
随机推荐
- 开发一个项目之npm
npm (nodejs平台上写的js模块的管理工具 下载.互相依赖等) npm install 本地项目的node_modules文件夹 , -g npm config prefix 目录eg: ...
- ssh远程访问失败 Centos7
ssh远程访问失败 Centos7 命令ssh远程访问另外一台主机hadoop.master失败 #ssh hadoop.master 报以下信息 [root@hadoop ~]# ssh hadoo ...
- 2018-2019-2 20165325 《网络对抗技术》 Exp6 信息搜集与漏洞扫描
2018-2019-2 20165325 <网络对抗技术> Exp6 信息搜集与漏洞扫描 实验内容(概要) 1 各种搜索技巧的应用: 2 DNS IP注册信息的查询: 3 基本的扫描技术 ...
- 通过hook实现禁止shift+delete快捷键
实现全局hook必须要将hook代码封装在dll里,所以此程序有两个文件:noShiftDeleteHook.dll和noShiftDelete.exe noShiftDeleteHook.dll / ...
- Win10如何彻底禁用小娜?彻底禁用小娜的方法
原文地址:https://www.cnblogs.com/zhuimengle/p/5949152.html 小娜是Win10系统中的一款强大功能,有了它,我们对电脑的操作将更加方便.Win10系统有 ...
- npm vue ivew vue-cli3
2019-4-10 10:56:20 星期三 学习iview时需要搭建一套node环境, 这里记录下来 1. 下载安装nodejs //自带了npm包管理器 2. 设置npm的全局配置: 全局包默认 ...
- 如何用java实现一个p2p种子搜索(4)-种子获取
种子获取 在上一篇中我们已经可以获取到dht网络中的infohash了,所以我们只需要通过infohash来获取到种子,最后获取种子里面的文件名,然后和获取到的infohash建立对应关系,那么我们的 ...
- 链表详解(C语言)
链表是一种常见的基础数据结构,结构体指针在这里得到了充分的利用. 链表可以动态的进行存储分配,也就是说,链表是一个功能极为强大的数组,他可以在节点中定义多种数据类型,还可以根据需要随意增添,删除,插入 ...
- docker启动,重启,停止容器
docker 启动已经停止的容器 docker start 容器ID或容器名 docker 停止容器 docker stop 容器ID或容器名 docker 启动一个容器 -d:后台运行 -p:端口映 ...
- python3 函数注意要点
一.定义一个函数: def test(): #用def关键词开头 print('*****') def test2(a,b): #a,b为形参 print(a,b) return a,b # retu ...