
强化学习-学习笔记9 | Multi-Step-TD-Target
这篇笔记依然属于TD算法的范畴。Multi-Step-TD-Target 是对 TD算法的改进。
9. Multi-Step-TD-Target
9.1 Review Sarsa & Q-Learning
- Sarsa
- 训练 动作价值函数 \(Q_\pi(s,a)\);
- TD Target 是 \(y_t = r_t + \gamma\cdot Q_\pi(s_{t+1},a_{t+1})\)
- Q-Learning
- 训练 最优动作价值函数 Q-star;
- TD Target 是 \(y_t = r_t +\gamma \cdot \mathop{max}\limits_{a} Q^*({s_{t+1}},a)\)
- 注意,两种算法的 TD Target 的 r 部分 都只有一个奖励 \(r_t\)
- 如果用多个奖励,那么 RL 的效果会更好;Multi-Step-TD-Target就是基于这种考虑提出的。
在第一篇强化学习的基础概念篇中,就提到过,agent 会观测到以下这个轨迹:
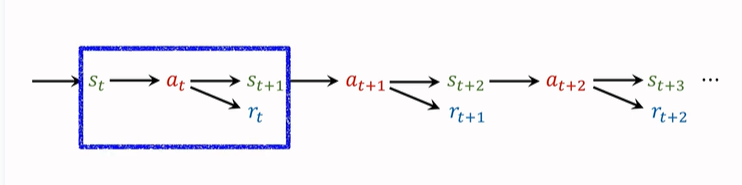
我们之前只使用一个 transition 来记录动作、奖励,并且更新 TD-Target。一个 transition 包括\((s_t,a_t,s_{t+1},r_t)\),只有一个奖励 \(r_t\)。(如上图蓝框所示)。
这样算出来的 TD Target 就是 One Step TD Target。
其实我们也可以一次使用多个 transition 中的奖励,得到的 TD Target 就是 Multi-Step-TD-Target。如下图蓝框选择了两个 transition,同理接下来可以选后两个 transition 。

9.2 多步折扣回报
Multi-Step Return.
折扣回报公式为:\(U_t=R_t+\gamma\cdot{U_{t+1}}\);
这个式子建立了 t 时刻和 t+1 时刻的 U 的关系,为了得到多步折扣回报,我们递归使用这个式子:
\(U_t=R_t+\gamma\cdot{U_{t+1}}\\=R_t+\gamma\cdot(R_{t+1}+\gamma\cdot{U_{t+2}})\\=R_t+\gamma\cdot{R_{t+1}}+\gamma^2\cdot{U_{t+2}}\)
这样,我们就可以包含两个奖励,同理我们可以有三个奖励......递归下去,包含 m个奖励为:
\(U_t=\sum_{i=0}^{m-1}\gamma^i\cdot{R_{t+i}}+\gamma^m\cdot{U_{t+m}}\)
即:回报 \(U_t\) 等于 m 个奖励的加权和,再加上 \(\gamma^m\cdot{U_{t+m}}\),后面这一项称为 多步回报。
现在我们推出了 多步的 \(U_t\) 的公式,进一步可以推出 多步 \(y_t\) 的公式,即分别对等式两侧求期望,使随机变量具体化:
Sarsa 的 m-step TD target:
\(y_t=∑_{i=0}^{m−1}\gamma^i\cdot r_{t+i}+\gamma^m\cdot{Q_\pi}(s_{t+m},a_{t+m})\)
注意:m=1 时,就是之前我们熟知的标准 TD Target。
多步的 TD Target 效果要比 单步 好。
Q-Learning 的 m-step TD target:
\(y_t = \sum_{i=0}^{m-1}\gamma^i{r_{t+i}}+\gamma^m\cdot\mathop{max}\limits_{a} Q^*({s_{t+m}},a)\)
同样,m=1时,就是之前的TD Target。
9.3 单步 与 多步 的对比
单步 TD Target 中,只使用一个奖励 \(r_t\);
如果用多步TD Target,则会使用多个奖励:\(r_t,r_{t+1},...,r_{t+m-1}\)
联想一下第二篇 价值学习 的旅途的例子,如果真实走过的路程占比越高,不考虑 “成本” 的情况下,对于旅程花费时间的估计可靠性会更高。
m 是一个超参数,需要手动调整,如果调的合适,效果会好很多。
x. 参考教程
- 视频课程:深度强化学习(全)_哔哩哔哩_bilibili
- 视频原地址:https://www.youtube.com/user/wsszju
- 课件地址:https://github.com/wangshusen/DeepLearning
强化学习-学习笔记9 | Multi-Step-TD-Target的更多相关文章
- 强化学习读书笔记 - 06~07 - 时序差分学习(Temporal-Difference Learning)
强化学习读书笔记 - 06~07 - 时序差分学习(Temporal-Difference Learning) 学习笔记: Reinforcement Learning: An Introductio ...
- 强化学习读书笔记 - 09 - on-policy预测的近似方法
强化学习读书笔记 - 09 - on-policy预测的近似方法 参照 Reinforcement Learning: An Introduction, Richard S. Sutton and A ...
- 强化学习读书笔记 - 02 - 多臂老O虎O机问题
# 强化学习读书笔记 - 02 - 多臂老O虎O机问题 学习笔记: [Reinforcement Learning: An Introduction, Richard S. Sutton and An ...
- 强化学习读书笔记 - 13 - 策略梯度方法(Policy Gradient Methods)
强化学习读书笔记 - 13 - 策略梯度方法(Policy Gradient Methods) 学习笔记: Reinforcement Learning: An Introduction, Richa ...
- 强化学习读书笔记 - 12 - 资格痕迹(Eligibility Traces)
强化学习读书笔记 - 12 - 资格痕迹(Eligibility Traces) 学习笔记: Reinforcement Learning: An Introduction, Richard S. S ...
- 强化学习读书笔记 - 10 - on-policy控制的近似方法
强化学习读书笔记 - 10 - on-policy控制的近似方法 学习笔记: Reinforcement Learning: An Introduction, Richard S. Sutton an ...
- 强化学习-学习笔记4 | Actor-Critic
Actor-Critic 是价值学习和策略学习的结合.Actor 是策略网络,用来控制agent运动,可以看做是运动员.Critic 是价值网络,用来给动作打分,像是裁判. 4. Actor-Crit ...
- 强化学习-学习笔记8 | Q-learning
上一篇笔记认识了Sarsa,可以用来训练动作价值函数\(Q_\pi\):本篇来学习Q-Learning,这是另一种 TD 算法,用来学习 最优动作价值函数 Q-star,这就是之前价值学习中用来训练 ...
- 强化学习-学习笔记14 | 策略梯度中的 Baseline
本篇笔记记录学习在 策略学习 中使用 Baseline,这样可以降低方差,让收敛更快. 14. 策略学习中的 Baseline 14.1 Baseline 推导 在策略学习中,我们使用策略网络 \(\ ...
随机推荐
- Go 语言 结构体和方法
@ 目录 1. 结构体别名定义 2. 工厂模式 3. Tag 原信息 4. 匿名字段 5. 方法 1. 结构体别名定义 变量别名定义 package main import "fmt&quo ...
- Linux:文件解压、复制和移动的若干坑
Linux下进行文件的解压.复制.移动应该是最常见的操作了.尤其是我们在项目中使用大量的数据集文件(比如机器学习)时.然而使用这些命令时一不留神就会掉进坑里,这篇文章我们就来细数用Shell进行文件操 ...
- day01-从一个基础的socket服务说起
首发地址:day01-从一个基础的socket服务说起 教程说明:C++高性能网络服务保姆级教程 本节目的 实现一个基于socket的echo服务端和客户端 服务端监听流程 第一步:使用socket函 ...
- XCTF练习题---MISC---ext3
XCTF练习题---MISC---ext3 flag:flag{sajbcibzskjjcnbhsbvcjbjszcszbkzj} 解题步骤: 1.下载附件,观察题目,发现题目跟Linux有关,我们换 ...
- XCTF练习题---CRYPTO---Broadcast
XCTF练习题---CRYPTO---Broadcast flag:flag{fa0f8335-ae80-448e-a329-6fb69048aae4} 解题步骤: 1.观察题目,下载附件 2.下载完 ...
- [AcWing 756] 蛇形矩阵
点击查看代码 #include<iostream> using namespace std; const int N = 110; int n, m; int dx[] = {-1, 0, ...
- vuepress搭建UI组件库文档踩坑篇
为了实现组件效果预览及代码展示可折叠功能,使用了插件vuepress-plugin-demo-container 相关配置可参考官网说明文档 第一步 安装插件 npm i - D vuepress-p ...
- 重修 Slope Trick(看这篇绝对够!)
Slope Trick 算法存在十余载了,但是我没有找到多少拍手叫好的讲解 blog,所以凭借本人粗拙的理解来写这篇文章. 本文除标明外所有图片均为本人手绘(若丑见谅),画图真的不容易啊 qwq(无耻 ...
- Flutter网络请求和数据解析
一:前言 - 什么是反射机制,Flutter为什么禁用反射机制? 在Flutter中它的网络请求和数据解析稍微的比较麻烦一点,因为Flutter不支持反射机制.相信大家都看到这么一条,就是Flutte ...
- 详解TCP三次握手(建立TCP连接过程)
在讲述TCP三次握手,即建立TCP连接的过程之前,需要先介绍一下TCP协议的包结构. 这里只对涉及到三次握手过程的字段做解释 (1) 序号(Sequence number) 我们通过 TCP 协议将数 ...