
redis的缓存穿透、击穿、雪崩以及实用解决方案
今天来聊聊redis的缓存穿透、击穿、雪崩以及解决方案,其中解决方案包括类似于布隆过滤器这种网上一搜一大片但是实际生产部署有一定复杂度的,也有基于spring注解通过一行代码就能解决的,其中各有优劣,咱们根据实际需要选型;
接下来会从穿透、击穿、雪崩的基本概念、各种问题对应的解决方案以及方案的具体实施来一一介绍
缓存穿透
概念
- 缓存穿透指某一特定时间批量请求打进来并访问了缓存和数据库都没有的key,此时会直接穿透缓存直达数据库,从而造成数据库瞬时压力倍增导致响应速度下降甚至崩溃的风险;
解决方案
一、通过布隆过滤器解决
原理:将所有需要缓存的key通过hash算法全部放到布隆过滤器将对应下标对应的值置成1,这样当请求进来时先去布隆过滤器里找,发现对应index的key是1则去缓存拿数据为0则直接返回,这样就避免了去数据库查询
优缺点:布隆过滤器底层通过redis的bitMap实现是基于位的操作,所以效率高;但是需要提前将key存入过滤器,这大大增加了前置成本;并且key到index的映射通过hash算法,那么必然会出现hash碰撞的问题;
二、通过key-null
- 原理:当请求进来从数据库查询回来的值为空时,将对应的null值也存入redis,这样下次请求时redis里已经有数据了就不会再怼到数据库了
- 优缺点:思路清晰,操作简单,但是极端情况下会有N多key在数据库和缓存中都没有,那这种实现就造成了redis里有过多的垃圾数据,浪费了内存空间
三、增强前置判断
- 原理:查询前在接口层做权限、逻辑校验,尽可能多的判断key的合法性
- 优缺点:使用成本低但并不足以规避掉缓存穿透的风险,所以建议只做附加的解决方案使用
缓存击穿
概念
- 缓存击穿指某一特定时间批量请求打进来对一个特定的值进行查询并访问了缓存中没有但是数据库里存在的key,此时会直接击穿缓存直达数据库,从而造成数据库瞬时压力倍增导致响应速度下降甚至崩溃的风险;需要注意的是,这里说的缓存中没有包含两层意思,一是缓存中本身没有,二十缓存中有但是过期了(少量热点key过期)
解决方案
一、设置key的过期时间随机
- 原理:在像redis批量设置key的时候尽量做到过期时间的随机性,以此避免某一时间会有批量key过期导致的缓存击穿
- 优缺点:虽然解决了缓存中同一时间批量key过期导致的击穿问题但是并不能解决缓存中压根就不存在key而造成的击穿
二、通过分布式锁解决
- 原理:在查询数据库的时候加一个分布式锁,使得某一特定时间内只有一个请求访问数据库,访问成功后将查询到的值缓存近redis,这样在下次访问时就不会造成击穿的现象了;
需要注意的是,针对非海量请求的业务这里加单机锁也问题不大,无非就是将同一时间只有一个请求到数据改成了同一时间只有集群数量的请求到数据库,问题应该也不大
- 优缺点:无论是缓存中本身就没有还是缓存中的key过期了使用加锁的方式都能解决缓存击穿的问题,但是却增加了加锁的成本
三、设置热点key永不过期
- 原理:针对热点key批量过期造成的穿透问题,将key设置成永不过期就能解决
- 优缺点:与一一样只能解决key过期造成的击穿不能解决缓存中没有key造成的击穿,并且热点key的确认也是门学问,并不总能保证设置的热点key不遗漏
四、将key部署在不同的实例
- 原理:针对集群部署的redis,将热点key分开部署也能避免过期造成的击穿问题
- 优缺点:只有集群才能使用,且也只能解决key过期造成的击穿问题,并不总能保证设置的热点key不遗漏
缓存雪崩
概念
- 与击穿相比雪崩表示过期或压根不存在的key是大量而不是一个或少量,导致大量请求落到数据库;
解决方案
一、通过设置过期时间随机来解决
- 设置key的时候加上随机过期时间,尽量减少同一时间过期key的数量;
二、设置锁
- 从缓存访问key开始就加锁,当缓存没有则去数据库查,查完塞入缓存最后释放锁;如果是单机应用则直接加虚拟机锁,集群部署的话则需使用分布式锁
小结
以上的实现方案可根据自己的业务需求灵活实现,其中个人认为布隆过滤器的落地相对复杂,成本也会更高,所以我们实际工作中并没有使用,而是用了基于spring-cache的@Cacheable注解,某种程度上可以说是一行代码解决了缓存击穿、穿透问题,下面说下@Cacheable注解
@Cacheable注解
一、介绍
- @Cacheable注解是一个spring3.1后引入的缓存技术,可通过在业务代码添加spring的缓存注解来实现缓存对象和方法的效果;而不用在业务代码里显示的进行set操作,大大方便了我们的日常开发
二、使用
- 1、在springboot的启动类添加
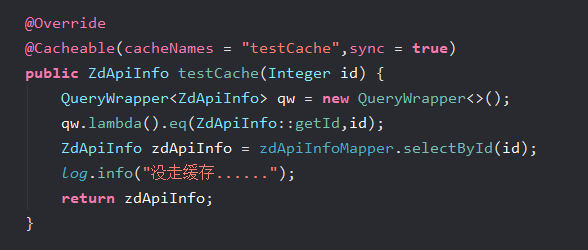
@EnableCaching注解开启缓存,否则下面的注解不会生效 - 2、直接上图,结合图来说明则一清二楚
说明
1、通过在方法上添加@Cacheable注解表示此方法需要走缓存,其中cacheNames的值加上方法的入参为唯一标识作为缓存中的key,而value则为方法的返回值;需要注意的是,当方法的入参和返回值是对象时则需要实现序列化(Serializable)接口
2、sync参数默认缺省值为false,表示是否是一个线程去数据库查询;所以当值为true时表示只有一个线程会打到数据库,这就解决了缓存击穿的问题;而针对缓存穿透,之前看到资料说需要添加spring.cache.redis.cache-null-values=true的配置才可以缓存空值,但我通过测试发现不论方法返回值是对象还是普通类型空值均可被缓存,我使用的spring版本是5.3.12;所以上面的代码也顺带解决了缓存穿透的问题
3、如果项目并发量小,不需要考虑穿透、击穿这些问题,可以直接写成@Cacheable("testCache")使sync缺省即可
三、总结
- 个人认为,针对@Cacheable已经足以解决实际开发中穿透、击穿的问题了;当然,如果假设一个集群有10000个实例,使用sync理论上也会有10000个请求同时抵达数据库从而影响数据库性能甚至崩溃,但是这种情况被我们碰到的情况很少,甚至可以说接触不到;但是如果真接触到了只能通过添加分布式锁去解决了
redis的缓存穿透、击穿、雪崩以及实用解决方案的更多相关文章
- Redis中几个简单的概念:缓存穿透/击穿/雪崩,别再被吓唬了
Redis中几个“看似”高大上的概念,经常有人提到,某些好事者喜欢死扣概念,实战没多少,嘴巴里冒出来的全是高大上的名词,个人一向鄙视概念党,呵呵! 其实这几个概念:缓存穿透/缓存击穿/缓存雪崩,有一个 ...
- NoSQL & Redis 介绍、缓存穿透 & 击穿 & 雪崩
1. NoSql 简介 2. Redis 简介 2.1 Redis 的起源 2.2 缓存过期 & 缓存淘汰 3. 缓存异常 1)缓存穿透 2)缓存击穿 3)缓存雪崩 4)总结 1. NoSQL ...
- 深入了解Redis(7)-缓存穿透,雪崩,击穿
redis作为一个内存数据库,在生产环境中使用会遇到许多问题,特别是像电商系统用来存储热点数据,容易出现缓存穿透,雪崩,击穿等问题.所以实际运用中需要做好前期处理工作. 一.缓存雪崩 1.概念 缓存雪 ...
- Redis作为缓存可能会出现的问题及解决方案
Redis是个大话题,只要是去面试Java开发,几乎必问.基础一点的问Redis是什么东西?用来做什么?Redis支持哪些数据类型?Redis的性能为什么那么好?复杂一点的就会问到缓存穿透.缓存击穿. ...
- Redis 17 缓存穿透 缓存击穿 缓存雪崩
参考源 https://www.bilibili.com/video/BV1S54y1R7SB?spm_id_from=333.999.0.0 版本 本文章基于 Redis 6.2.6 使用缓存的问题 ...
- redis:缓存穿透、缓存击穿、缓存雪崩
缓存穿透的解决方案(空标记) 缓存穿透是指,在数据存储系统中不存在的记录,不会被存储到缓存中.这种记录每次的查询流量都会穿透到数据存储层.在高流量的场景下,不断查询空结果会大量消耗数据查询服务的资源, ...
- 《Redis - 穿透/击穿/雪崩/集中失效》
一:什么是缓存穿透? - 定义 - 正常情况下,我们在理想的条件下去查询缓存数据都是存在的. - 那么请求去查询一条数据库中不存在的数据,也就是缓存和数据库都查询不到这条数据. - 所以请求每次都会打 ...
- Redis缓存穿透和雪崩
缓存穿透 用户想要查询一个数据 在redis缓存数据库中没有获取到 就会向后端的数据库中查询. 当用户很多 都去访问后端数据库的话,这就会给数据库带来很大的压力. 常见场景:秒杀活动 等 解决方法: ...
- Redis 穿透 & 击穿 & 雪崩
原文:https://www.cnblogs.com/binghe001/p/13661381.html 缓存穿透 如果在请求数据时,在缓存层和数据库层都没有找到符合条件的数据,也就是说,在缓存层和数 ...
随机推荐
- [JOI 2017 Final] 足球 (建图,最短路)
题面 题解 我们可以总结出球的两种状态,要么自己飞,要么在球员脚下被带飞. 自己飞的情况下,他只能单向直线运动,每一步代价为A,被带飞可以乱走,每一步代价为C. 从自己飞到被带飞需要一个距离自己最近的 ...
- 【C标准库】详解strerror函数
创作不易,感谢支持 strerror 头文件:string.h 描述: strerror() 函数接受一个参数:errnum,它是一个表示错误代码的整数值.此函数将错误代码转换为说明错误的合适字符串指 ...
- WebGPU实现Ray Packet
大家好~本文在如何用WebGPU流畅渲染百万级2D物体?基础上进行优化,使用WebGPU实现了Ray Packet,也就是将8*8=64条射线作为一个Packet一起去访问BVH的节点.这样做的好处是 ...
- 从零教你使用MindStudio进行Pytorch离线推理全流程
摘要:MindStudio的是一套基于华为自研昇腾AI处理器开发的AI全栈开发工具平台,该IDE上功能很多,涵盖面广,可以进行包括网络模型训练.移植.应用开发.推理运行及自定义算子开发等多种任务. 本 ...
- angr原理与实践(二)—— 各类图的生成(CFG CG ACFG DDG等)
本文系原创,转载请说明出处 Please Subscribe Wechat Official Account:信安科研人,获取更多的原创安全资讯 上一篇文章介绍了angr的原理,自此篇文章开始, ...
- kettle通过SSH连接Mysql数据库(SSH隧道)
kettle通过SSH连接Mysql数据库(SSH隧道) Kettle无法直接连接使用SSH通道的MySQL,通过SSH隧道(推荐)或者需要借助工具PuTTY(不用时需要注销不推荐),具体操作如下所示 ...
- JS作用域、变量提升和闭包
作用域 作用域可以理解为JS引擎执行代码的时候,查找变量的规则. 从确定变量访问范围的阶段的角度,可以分为2类,词法作用域和动态作用域.js是词法作用域. 从变量查找的范围的角度,可以分为3类,全局作 ...
- windows下 Rust 环境配置
搭建 Visual Studio Code 开发环境 首先,需要安装最新版的 Rust 编译工具和 Visual Studio Code. Rust 编译工具:https://www.rust-lan ...
- kubeadm join 命令执行流程
- Solutions:网站搜索 - Elastic Site Search