
Elasticsearch(ES)分词器的那些事儿
1. 概述
分词器是Elasticsearch中很重要的一个组件,用来将一段文本分析成一个一个的词,Elasticsearch再根据这些词去做倒排索引。
今天我们就来聊聊分词器的相关知识。
2. 内置分词器
2.1 概述
Elasticsearch 中内置了一些分词器,这些分词器只能对英文进行分词处理,无法将中文的词识别出来。
2.2 内置分词器介绍
standard:标准分词器,是Elasticsearch中默认的分词器,可以拆分英文单词,大写字母统一转换成小写。
simple:按非字母的字符分词,例如:数字、标点符号、特殊字符等,会去掉非字母的词,大写字母统一转换成小写。
whitespace:简单按照空格进行分词,相当于按照空格split了一下,大写字母不会转换成小写。
stop:会去掉无意义的词,例如:the、a、an 等,大写字母统一转换成小写。
keyword:不拆分,整个文本当作一个词。
2.3 查看分词效果通用接口
GET http://192.168.1.11:9200/_analyze
参数:
{

    "analyzer": "standard",

    "text": "I am a man."

}
响应:
{

    "tokens": [

        {

            "token": "i",

            "start_offset": 0,

            "end_offset": 1,

            "type": "<ALPHANUM>",

            "position": 0

        },

        {

            "token": "am",

            "start_offset": 2,

            "end_offset": 4,

            "type": "<ALPHANUM>",

            "position": 1

        },

        {

            "token": "a",

            "start_offset": 5,

            "end_offset": 6,

            "type": "<ALPHANUM>",

            "position": 2

        },

        {

            "token": "man",

            "start_offset": 7,

            "end_offset": 10,

            "type": "<ALPHANUM>",

            "position": 3

        }

    ]

}
3. IK分词器
3.1 概述
Elasticsearch中内置的分词器不能对中文进行分词,因此我们需要再安装一个能够支持中文的分词器,IK分词器就是个不错的选择。
3.2 下载IK分词器
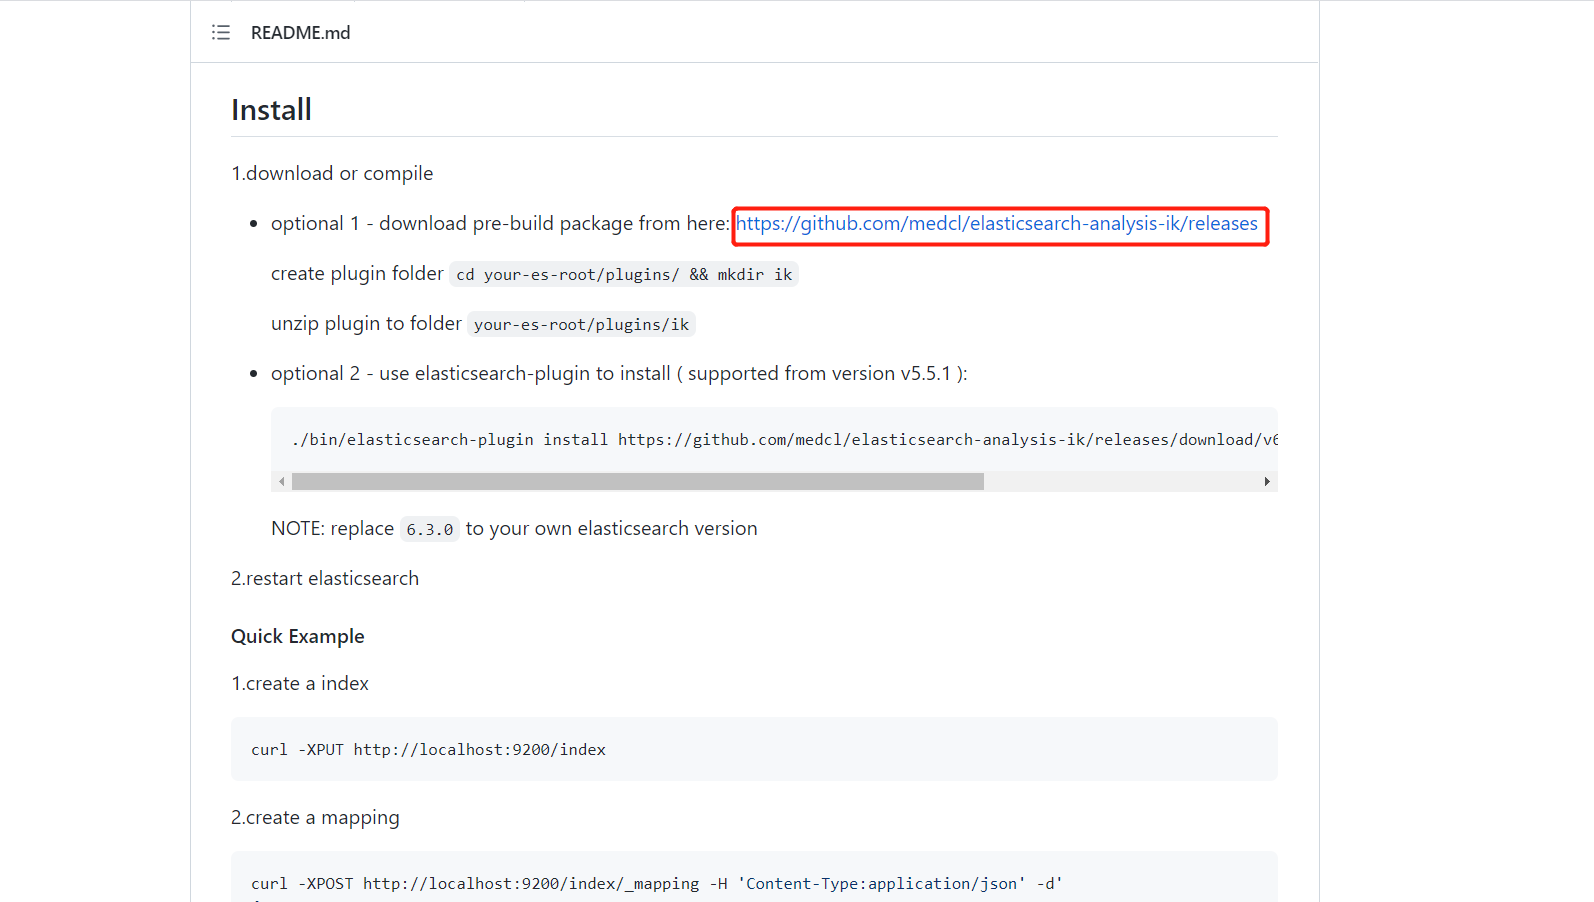
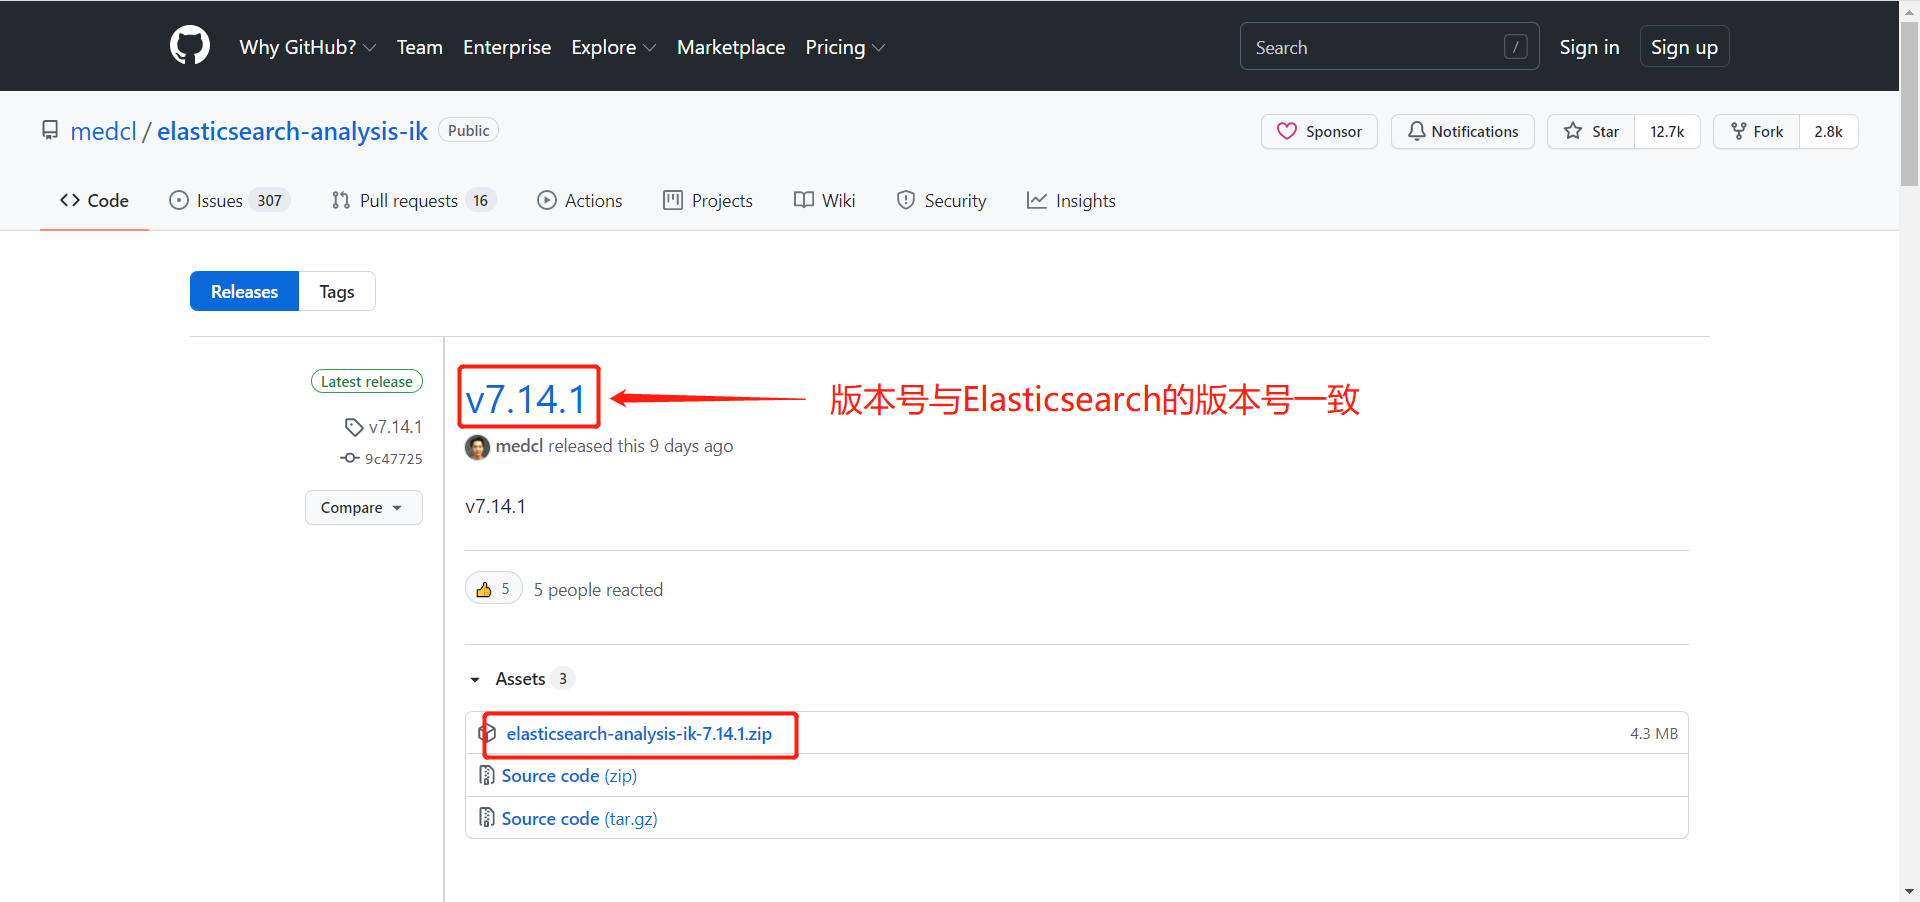
下载网址:https://github.com/medcl/elasticsearch-analysis-ik
3.3 IK分词器的安装
1)为IK分词器创建目录
# cd /usr/local/elasticsearch-7.14.1/plugins
# mkdir ik
2)将IK分词器压缩包拷贝到CentOS7的目录下,例如:/home
3)将压缩包解压到刚刚创建的目录
# unzip elasticsearch-analysis-ik-7.14.1.zip -d /usr/local/elasticsearch-7.14.1/plugins/ik/
4)重启Elasticsearch
3.4 IK分词器介绍
ik_max_word: 会将文本做最细粒度的拆分,适合 Term Query;
ik_smart: 会做最粗粒度的拆分,适合 Phrase 查询。
IK分词器介绍来源于GitHub:https://github.com/medcl/elasticsearch-analysis-ik
3.5 分词效果
GET http://192.168.1.11:9200/_analyze
参数:
{

    "analyzer": "ik_max_word",

    "text": "我是一名Java高级程序员"

}
响应:
{

    "tokens": [

        {

            "token": "我",

            "start_offset": 0,

            "end_offset": 1,

            "type": "CN_CHAR",

            "position": 0

        },

        {

            "token": "是",

            "start_offset": 1,

            "end_offset": 2,

            "type": "CN_CHAR",

            "position": 1

        },

        {

            "token": "一名",

            "start_offset": 2,

            "end_offset": 4,

            "type": "CN_WORD",

            "position": 2

        },

        {

            "token": "一",

            "start_offset": 2,

            "end_offset": 3,

            "type": "TYPE_CNUM",

            "position": 3

        },

        {

            "token": "名",

            "start_offset": 3,

            "end_offset": 4,

            "type": "COUNT",

            "position": 4

        },

        {

            "token": "java",

            "start_offset": 4,

            "end_offset": 8,

            "type": "ENGLISH",

            "position": 5

        },

        {

            "token": "高级",

            "start_offset": 8,

            "end_offset": 10,

            "type": "CN_WORD",

            "position": 6

        },

        {

            "token": "程序员",

            "start_offset": 10,

            "end_offset": 13,

            "type": "CN_WORD",

            "position": 7

        },

        {

            "token": "程序",

            "start_offset": 10,

            "end_offset": 12,

            "type": "CN_WORD",

            "position": 8

        },

        {

            "token": "员",

            "start_offset": 12,

            "end_offset": 13,

            "type": "CN_CHAR",

            "position": 9

        }

    ]

}
4. 自定义词库
4.1 概述
在进行中文分词时,经常出现分析出的词不是我们想要的,这时我们就需要在IK分词器中自定义我们自己词库。
例如:追风人,分词后,只有 追风 和 人,而没有 追风人,导致倒排索引后查询时,用户搜 追风 或 人 可以搜到 追风人,搜 追风人 反而搜不到 追风人。
4.2 自定义词库
# cd /usr/local/elasticsearch-7.14.1/plugins/ik/config
# vi IKAnalyzer.cfg.xml
在配置文件中增加自己的字典

# vi my.dic
在文本中加入 追风人,保存。
重启Elasticsearch即可。
5. 综述
今天简单聊了一下 Elasticsearch(ES)分词器的相关知识,希望可以对大家的工作有所帮助。
欢迎大家帮忙点赞、评论、加关注 :)
关注追风人聊Java,每天更新Java干货。
Elasticsearch(ES)分词器的那些事儿的更多相关文章
- elasticsearch kibana + 分词器安装详细步骤
elasticsearch kibana + 分词器安装详细步骤 一.准备环境 系统:Centos7 JDK安装包:jdk-8u191-linux-x64.tar.gz ES安装包:elasticse ...
- Elasticsearch之分词器的作用
前提 什么是倒排索引? Analyzer(分词器)的作用是把一段文本中的词按一定规则进行切分.对应的是Analyzer类,这是一个抽象类,切分词的具体规则是由子类实现的,所以对于不同的语言,要用不同的 ...
- Elasticsearch之分词器的工作流程
前提 什么是倒排索引? Elasticsearch之分词器的作用 Elasticsearch的分词器的一般工作流程: 1.切分关键词 2.去除停用词 3.对于英文单词,把所有字母转为小写(搜索时不区分 ...
- Elasticsearch修改分词器以及自定义分词器
Elasticsearch修改分词器以及自定义分词器 参考博客:https://blog.csdn.net/shuimofengyang/article/details/88973597
- ES 09 - 定制Elasticsearch的分词器 (自定义分词策略)
目录 1 索引的分析 1.1 分析器的组成 1.2 倒排索引的核心原理-normalization 2 ES的默认分词器 3 修改分词器 4 定制分词器 4.1 向索引中添加自定义的分词器 4.2 测 ...
- 【分词器及自定义】Elasticsearch中文分词器及自定义分词器
中文分词器 在lunix下执行下列命令,可以看到本来应该按照中文”北京大学”来查询结果es将其分拆为”北”,”京”,”大”,”学”四个汉字,这显然不符合我的预期.这是因为Es默认的是英文分词器我需要为 ...
- elasticsearch中文分词器(ik)配置
elasticsearch默认的分词:http://localhost:9200/userinfo/_analyze?analyzer=standard&pretty=true&tex ...
- elasticsearch 分析器 分词器
参考:https://www.elastic.co/guide/en/elasticsearch/reference/current/analysis-tokenizers.html 在全文搜索(Fu ...
- ElasticSearch中分词器组件配置详解
首先要明确一点,ElasticSearch是基于Lucene的,它的很多基础性组件,都是由Apache Lucene提供的,而es则提供了更高层次的封装以及分布式方面的增强与扩展. 所以要想熟练的掌握 ...
随机推荐
- html 去除重复边框
<!DOCTYPE html><html> <head> <meta charset="utf-8"> <title>& ...
- Git-02-版本回退
环境准备 1 修改readme.txt内容 Git is a distributed version control system. Git is free software. 2 git statu ...
- Python 应用爬虫下载酷狗音乐
应用爬虫下载酷狗音乐 首先我们需要进入到这个界面 想要爬取这些歌曲链接,然而这个是一个假的网站,虽然单机右键进行检查能看到这些歌曲的链接,可进行爬取时,却爬取不到这些信息. 这个时候我们就应该换一种思 ...
- weblogicSSRF漏洞复现
一.关于SSRF 1.1 简介: SSRF(Server-Side Request Forgery)服务端请求伪造,是一种由攻击者构造形成由服务器端发起请求的一个漏洞,一般情况下,SSRF 攻击的目标 ...
- NOIP 模拟 $34\; \rm Merchant$
题解 \(by\;zj\varphi\) 对于选的物品,总值一定有在前一段区间递减,后一段递增的性质,那么就可以二分. check()时只递归归并大的一段,用nth_element即可 Code #i ...
- 【译】JavaScript async / await:好的部分,陷阱和如何使用
async/await提供了一种使用同步样式代码异步访问资源的选项,而不会阻塞主线程.然而,使用它有点棘手.在本文中,我们将从不同的角度探讨async / await,并将展示如何正确有效地使用它们. ...
- 【转】java内存溢出的场景及解决办法
参考: https://blog.csdn.net/qq_32671287/article/details/86063396 https://www.cnblogs.com/snowwhite/p/9 ...
- 徒手撸一个简单的RPC框架
来源:https://juejin.im/post/5c4481a4f265da613438aec3 之前在牛逼哄哄的 RPC 框架,底层到底什么原理得知了RPC(远程过程调用)简单来说就是调用远程的 ...
- linux系统下深度学习环境搭建和使用
作为一个AI工程师,对Linux的一些技能的掌握也能从一定层面反应工程师的资深水平. 要求1:基于SSH的远程访问(本篇文章) 能用一台笔记本电脑,远程登陆一台linux服务器 能随时使用笔记本电脑启 ...
- canvas——离屏
离屏操作: 1.创建一个新的离屏canvas; 2.把一些复杂额绘画操作(背景),画在离屏canvas上: 3.将离屏canvas通过drawImage(离屏canvas对象,x1,y1,offcan ...