
【python爬虫】用python编写LOL战绩查询
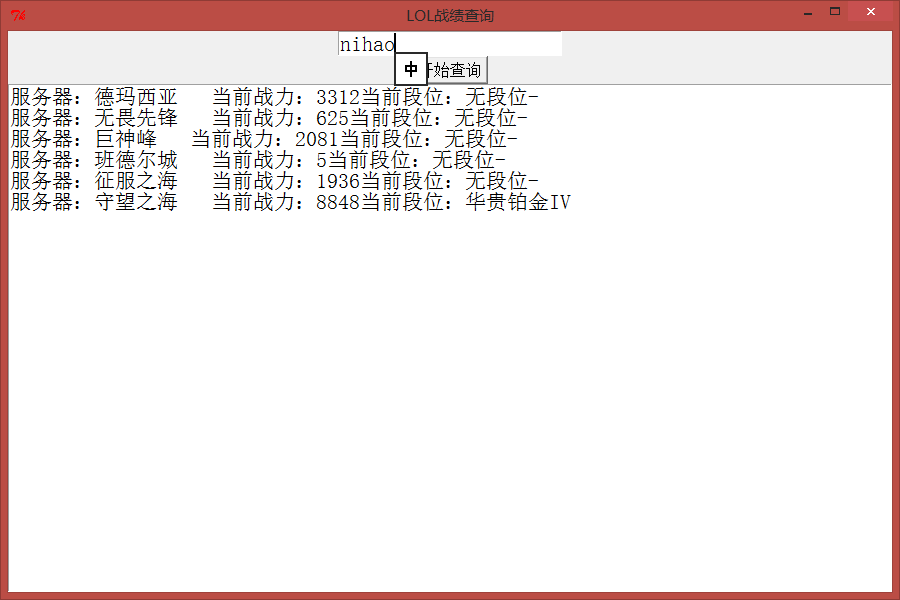
介绍一个简单的python爬虫,通过Tkinter创建一个客户端,当输入要查询的LOL用户名称的时候,可以显示出当前用户的所在服务器,当前战力和当前段位。
爬取网页地址:http://lol.duowan.com/zdl/
python版本:2.7
需要用到的模块:Tkinter urllib2 json sys
实例代码:
import urllib2, json, threading

from Tkinter import *

import sys

reload(sys)

sys.setdefaultencoding('utf-8')

def get_zhanji():

    name = str(et.get())

    url = 'http://api.lolbox.duowan.com/api/v2/player/search/?player_name_list=%s&callback=jQuery111200161216930093' \

          '95033_1470488155157&_=1470488155158' % name

    res = urllib2.urlopen(url)

    html = res.read()[44:-1]

    print html

    zhanji = json.loads(html)[u'player_list']

    t.delete(0.0, END)

    for i in zhanji:

        print '服务器:%s   当前战力:%s' % (i['game_zone']['alias'], i['box_score'])

        print '当前段位:%s' % (i['tier_rank']['tier']['full_name_cn'] + i['tier_rank']['rank']['name'])

        # print i['game_zone']['alias']

        # print zhangji

        # print html

        t.insert(END, '服务器:%s   当前战力:%s' % (i['game_zone']['alias'], i['box_score']))

        t.insert(END, '当前段位:%s\n' % (i['tier_rank']['tier']['full_name_cn'] + i['tier_rank']['rank']['name']))

def rukou():

    if et.get() == '':

        print '请输入召唤师名称'

    else:

        get_zhanji()

# def qidong():

#     t1 = threading.Thread(target=rukou)

#     t1.start()

# get_zhanji()

# print len(jQuery11120016121693009395033_1470488155157()

root = Tk()

root.title('LOL战绩查询')

root.geometry()

et = Entry(root, font=('宋体, 16'))

et.grid()

b = Button(root, text='开始查询', font=('宋体, 12'), command=rukou)

b.grid()

t = Text(root, font=('宋体, 16'))

t.grid()

root.mainloop()
界面效果展示:
【python爬虫】用python编写LOL战绩查询的更多相关文章
- python爬虫之12306网站--火车票信息查询
python爬虫之12306网站--火车票信息查询 思路: 1.火车票信息查询是基于车站信息查询,先完成车站信息查询,然后根据车站信息查询生成的url地址去查询当前已知出发站和目的站的所有车次车票信息 ...
- 零基础学习Python web开发、Python爬虫、Python数据分析,从基础到项目实战!
随着大数据和人工智能的发展,目前Python语言的上升趋势比较明显,而且由于Python语言简单易学,所以不少初学者往往也会选择Python作为入门语言. Python语言目前是IT行业内应用最为广泛 ...
- python爬虫之12306网站--车站信息查询
python爬虫查询车站信息 目录: 1.找到要查询的url 2.对信息进行分析 3.对信息进行处理 python爬虫查询全拼相同的车站 目录: 1.找到要查询的url 2.对信息进行分析 3.对信息 ...
- Python爬虫《Python网络爬虫相关基础概念》
引入 之前在授课过程中,好多同学都问过我这样的一个问题:为什么要学习爬虫,学习爬虫能够为我们以后的发展带来那些好处?其实学习爬虫的原因和为我们以后发展带来的好处都是显而易见的,无论是从实际的应用还是从 ...
- Python 爬虫+tkinter界面 实现历史天气查询
文章目录 一.实现效果 1. python代码 2. 运行效果 二.基本思路 1. 爬虫部分 2. tkinter界面 一.实现效果 很多人学习python,不知道从何学起.很多人学习python,掌 ...
- 【Python爬虫】第四课(查询照片拍摄地址)
首先,要能够查询到照片地址,查询的照片必须要开GPS拍,且上传时用原图…… 查询图片的exif信息,使用exifread包 import exifread img = exifread.process ...
- [Python爬虫]使用Selenium操作浏览器订购火车票
这个专题主要说的是Python在爬虫方面的应用,包括爬取和处理部分 [Python爬虫]使用Python爬取动态网页-腾讯动漫(Selenium) [Python爬虫]使用Python爬取静态网页-斗 ...
- 一个Python爬虫工程师学习养成记
大数据的时代,网络爬虫已经成为了获取数据的一个重要手段. 但要学习好爬虫并没有那么简单.首先知识点和方向实在是太多了,它关系到了计算机网络.编程基础.前端开发.后端开发.App 开发与逆向.网络安全. ...
- python 爬虫使用
python爬虫架构 Python 爬虫架构主要由五个部分组成,分别是 调度器.URL管理器.网页下载器.网页解析器.应用程序. 调度器:相当于一台电脑的CPU,主要负责调度URL管理器.下载器.解析 ...
随机推荐
- Go语言最佳实践——通道和并发
何时关闭通道: 第一,只有在后面要检查通道是否关闭的时候才需要显式地关闭通道: 第二,应该由发送端的goroutine关闭通道,而不是由接收端的goroutine来完成: 第三,如果通道并不需要检查是 ...
- SQL SERVER2008 R2修改Server Collation--文檔沒細看先存下來.
HOW TO: RESTORE THE MASTER DATABASE IN SQL SERVER 2012 by Thomas LaRock | Jan 14, 2014 | MSSQL, SQL ...
- 5种banner
<!DOCTYPE html><html> <head> <meta charset="UTF-8"> <tit ...
- NFS4 挂载同主机多个目录
写在前面的话 事情是酱婶儿的,前两天实在是帮他们查日志查的心里交瘁了,而且有些时候下班了,也就不想再接到这样的需求,于是想基于 Nginx 做一个文件下载中心,在这个文件下载中心里面存有各个服务的日志 ...
- nginx负载均衡tomcat和配置ssl
目录 tomcat 组件功能 engine host context connector service server valve logger realm UserDatabaseRealm 工作流 ...
- 【转】OracleOraDb11g_home1TNSListener服务启动后又停止了
源地址:https://www.cnblogs.com/Asa-Zhu/p/3819605.html 一.错误描述 登陆PL/SQL Developer登陆本地数据库时先报没有监听程序,查看服务发现O ...
- loj#6437. 「PKUSC2018」PKUSC(计算几何)
题面 传送门 题解 计算几何的东西我好像都已经忘光了-- 首先我们可以把原问题转化为另一个等价的问题:对于每一个敌人,我们以原点为圆心,画一个经过该点的圆,把这个圆在多边形内部的圆弧的度数加入答案.求 ...
- 八大排序算法的python实现(三)冒泡排序
代码: #coding:utf-8 #author:徐卜灵 #交换排序.冒泡排序 L = [1, 3, 2, 32, 5, 4] def Bubble_sort(L): for i in range( ...
- 12、OpenCV Python 图像梯度
__author__ = "WSX" import cv2 as cv import numpy as np def lapalian_demo(image): #拉普拉斯算子 # ...
- 'javac' 不是内部或外部命令,也不是可运行的程序
win10 系统下'javac' 不是内部或外部命令,也不是可运行的程序 1.在系统变量下面配置 JAVA_HOME:你自己的jdk的路径 CLASSPATH= .;%JAVA_HOME%libdt. ...