
大数据学习——点击流日志每天都10T,在业务应用服务器上,需要准实时上传至(Hadoop HDFS)上
点击流日志每天都10T,在业务应用服务器上,需要准实时上传至(Hadoop HDFS)上
1需求说明
点击流日志每天都10T,在业务应用服务器上,需要准实时上传至(Hadoop HDFS)上
2需求分析
一般上传文件都是在凌晨24点操作,由于很多种类的业务数据都要在晚上进行传输,为了减轻服务器的压力,避开高峰期。
如果需要伪实时的上传,则采用定时上传的方式
3技术分析
HDFS SHELL: hadoop fs –put xxxx.log /data 还可以使用 Java Api
满足上传一个文件,不能满足定时、周期性传入。
定时调度器:
Linux crontab
crontab -e
*/5 * * * * $home/bin/command.sh //五分钟执行一次
系统会自动执行脚本,每5分钟一次,执行时判断文件是否符合上传规则,符合则上传
4实现流程
4.1日志产生程序
日志产生程序将日志生成后,产生一个一个的文件,使用滚动模式创建文件名。
日志生成的逻辑由业务系统决定,比如在log4j配置文件中配置生成规则,如:当xxxx.log 等于10G时,滚动生成新日志
 log4j.logger.msg=info,msg

log4j.appender.msg=cn.maoxiangyi.MyRollingFileAppender

log4j.appender.msg.layout=org.apache.log4j.PatternLayout

log4j.appender.msg.layout.ConversionPattern=%m%n

log4j.appender.msg.datePattern='.'yyyy-MM-dd

log4j.appender.msg.Threshold=info

log4j.appender.msg.append=true

log4j.appender.msg.encoding=UTF-8

log4j.appender.msg.MaxBackupIndex=100

log4j.appender.msg.MaxFileSize=10GB

log4j.appender.msg.File=/home/hadoop/logs/log/access.log
细节:
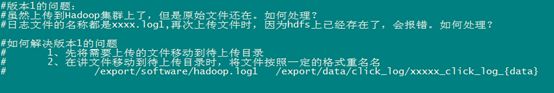
1、 如果日志文件后缀是1\2\3等数字,该文件满足需求可以上传的话。把该文件移动到准备上传的工作区间。
2、 工作区间有文件之后,可以使用hadoop put命令将文件上传。
阶段问题:
1、 待上传文件的工作区间的文件,在上传完成之后,是否需要删除掉。
4.2伪代码
使用ls命令读取指定路径下的所有文件信息,
ls | while read line
//判断line这个文件名称是否符合规则
if line=access.log.* (
将文件移动到待上传的工作区间
)
//批量上传工作区间的文件
hadoop fs –put xxx
脚本写完之后,配置linux定时任务,每5分钟运行一次。
5代码实现
代码第一版本,实现基本的上传功能和定时调度功能

代码第二版本:增强版V2(基本能用,还是不够健全)

6效果展示及操作步骤
1、日志收集文件收集数据,并将数据保存起来,效果如下:

2、上传程序通过crontab定时调度

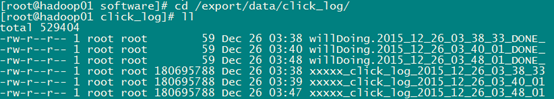
3、程序运行时产生的临时文件
4、Hadoo hdfs上的效果

大数据学习——点击流日志每天都10T,在业务应用服务器上,需要准实时上传至(Hadoop HDFS)上的更多相关文章
- 大数据学习:storm流式计算
Storm是一个分布式的.高容错的实时计算系统.Storm适用的场景: 1.Storm可以用来用来处理源源不断的消息,并将处理之后的结果保存到持久化介质中. 2.由于Storm的处理组件都是分布式的, ...
- 大数据学习——mapreduce运营商日志增强
需求 1.对原始json数据进行解析,变成普通文本数据 2.求出每个人评分最高的3部电影 3.求出被评分次数最多的3部电影 数据 https://pan.baidu.com/s/1gPsQXVYSQE ...
- 大数据学习总结(7)we should...
大数据场景一.各种标签查询 查询要素:人.事.物.单位 查询范围:A范围.B范围.... 查询结果:pic.name.data from 1.痛点:对所有文本皆有实时查询需求2.难点:传统SQL使用W ...
- 【Spark】通过Spark实现点击流日志分析
文章目录 数据大致内容及格式 统计PV(PageViews) 统计UV(Unique Visitor) 求取TopN 数据大致内容及格式 194.237.142.21 - - [18/Sep/2013 ...
- 大数据学习之Hadoop快速入门
1.Hadoop生态概况 Hadoop是一个由Apache基金会所开发的分布式系统集成架构,用户可以在不了解分布式底层细节情况下,开发分布式程序,充分利用集群的威力来进行高速运算与存储,具有可靠.高效 ...
- 大数据学习——Hadoop第一天
1.1 什么是HADOOP HADOOP是apache旗下的一套开源软件平台 HADOOP提供的功能:利用服务器集群,根据用户的自定义业务逻辑,对海量数据进行分布式处理 HADOOP的核心组件有 HD ...
- 大数据学习笔记——Hadoop编程实战之HDFS
HDFS基本API的应用(包含IDEA的基本设置) 在上一篇博客中,本人详细地整理了如何从0搭建一个HA模式下的分布式Hadoop平台,那么,在上一篇的基础上,我们终于可以进行编程实操了,同样,在编程 ...
- 大数据学习笔记之Hadoop(三):MapReduce&YARN
文章目录 一 MapReduce概念 1.1 为什么要MapReduce 1.2 MapReduce核心思想 1.3 MapReduce进程 1.4 MapReduce编程规范(八股文) 1.5 Ma ...
- 大数据学习路线,来qun里分享干货,
一.Linux lucene: 全文检索引擎的架构 solr: 基于lucene的全文搜索服务器,实现了可配置.可扩展并对查询性能进行了优化,并且提供了一个完善的功能管理界面. 推荐一个大数据学习群 ...
随机推荐
- git导出代码
1.快速查询 $git archive --format zip --output "./output.zip" master -0 ./output.zip 是生成的文件 mas ...
- P2044 随机数生成器
链接:https://www.luogu.org/problem/show?pid=2044#sub 题目描述 栋栋最近迷上了随机算法,而随机数是生成随机算法的基础.栋栋准备使用线性同余法(Linea ...
- postgresql版sde(10.4.1)新建数据库
使用sde pg版,第一次建sde库就是新安装sde的方法 然而从第二次开始可以有其他方式 新建一般的pg数据再转为sde数据库: 首先用建一般的pg数据库 首先要新建数据库 数据库名:新建的数据库名 ...
- react基础语法(四) state学习
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- DROP TABLE - 删除一个表
SYNOPSIS DROP TABLE name [, ...] [ CASCADE | RESTRICT ] DESCRIPTION 描述 DROP TABLE 从数据库中删除表或视图. 只有其所有 ...
- IIR数字滤波器
对于N阶IIR的计算方程式为: 一阶 Y(n)=a∗X(n)+(1−a)∗Y(n−1) 二阶 y[n]=b0⋅x[n]+b1⋅x[n−1]+b2⋅x[n−2]−a1⋅y[n−1]−a2⋅y[n−2]
- 利用CWinThread实现跨线程父子MFC窗口
利用CWinThread实现跨线程父子MFC窗口 MFC对象只能由创建该对象的线程访问,而不能由其他线程访问. 不遵守该准则将导致断言(assertion)或者无法预知的程序行为等运行期错误. 在多线 ...
- python⽤户登陆
⽤户登陆(三次输错机会)且每次输错误时显示剩余错误次数(提示:使⽤字符串格式化) count = 3 while count < 4: count -= 1 username = input(' ...
- DNS查询过程
DNS查询过程 假设www.abc.com的主机要查询www.xyz.abc.com的服务器ip地址. 知识点 1.hosts文件:以静态映射的方式提供IP地址与主机名的对照表,类似ARP表 2.域: ...
- 深度学总结:skip-gram pytorch实现
文章目录 skip-gram pytorch 朴素实现网络结构训练过程:使用nn.NLLLoss()batch的准备,为unsupervised,准备数据获取(center,contex)的pair: ...