
Spark Structured Streaming框架(2)之数据输入源详解
Spark Structured Streaming目前的2.1.0版本只支持输入源:File、kafka和socket。
1. Socket
Socket方式是最简单的数据输入源,如Quick example所示的程序,就是使用的这种方式。用户只需要指定"socket"形式并配置监听的IP和Port即可。
|
val scoketDF = spark.readStream .format("socket") .option("host","localhost") .option("port", 9999) .load() |
注意:
Socket方式Streaming是接收UTF8的text数据,并且这种方式最后只用于测试,不要用户端到端的项目中。
2. Kafka
Structured streaming提供接收kafka数据源的接口,用户使用起来也非常方便,只是需要注意开发环境所依赖的特别库,同时streaming运行环境的kafka版本。
2.1 开发环境
若以kafka作为输入源,那么开发环境需要再引入所依赖的架包。如使用了Spark版本是2.1.0,那么maven的pom.xml文件中需要添加如下的依赖库。
|
<dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-sql-kafka-0.10_2.11</artifactId> <version>2.1.0</version> </dependency> |
2.2 API
与使用socket作为输入源类似,只需要指定"kafka"作为输入源,同时传递kafka的server集和topic集。如下所示:
|
// Subscribe to 1 topic val df = spark .readStream .format("kafka") .option("kafka.bootstrap.servers", "host1:port1,host2:port2") .option("subscribe", "topic1") .load() df.selectExpr("CAST(key AS STRING)", "CAST(value AS STRING)") .as[(String, String)] // Subscribe to multiple topics val df = spark .readStream .format("kafka") .option("kafka.bootstrap.servers", "host1:port1,host2:port2") .option("subscribe", "topic1,topic2") .load() df.selectExpr("CAST(key AS STRING)", "CAST(value AS STRING)") .as[(String, String)] // Subscribe to a pattern val df = spark .readStream .format("kafka") .option("kafka.bootstrap.servers", "host1:port1,host2:port2") .option("subscribePattern", "topic.*") .load() df.selectExpr("CAST(key AS STRING)", "CAST(value AS STRING)") .as[(String, String)] |
2.3 运行环境
由于spark 2.1.0使用了kafka的版本是0.10,所以kafka server也要使用同样版本,即发送数据的kafka也需要使用0.10版本。
否则会出现如下的错误:
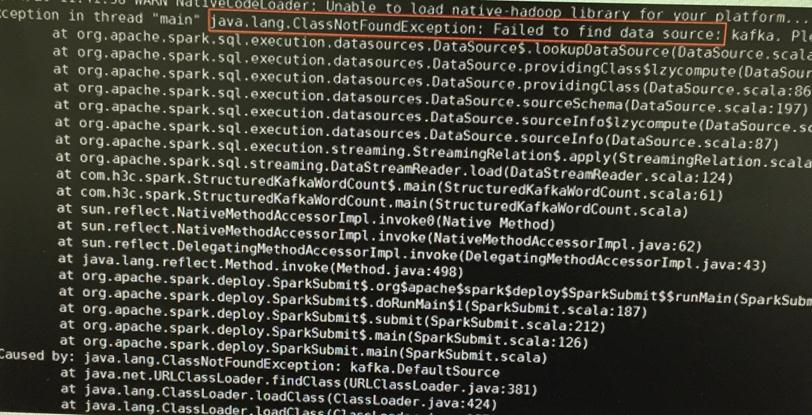
图 21
3. File
Structured Streaming可以指定一个目录的文件作为数据输入源,其中支持的文件格式有:text、csv、json、parquet。
如下所示:
|
object StructuredFile{ def main(args:Array[String]){ val spark = SparkSession .builder .appName("StructuredNetWordCount") .getOrCreate() val userSchema = new StructType().add("name","string").add("age","integer") val jsonDF = spark .readStream .schema(userSchema) .json("/root/jar/directory")//Equivalent to format("json").load("/root/jar/directore") Val query = jsonDF.writeStream .format(console) .start() Query.awaitTermination() } } |
读取文件的接口有5个:
- format(source).load(path):source参数是指文件的形式,有text、csv、json、parquet四种形式;
- text(path):其封装了format("text").load(path);
- json(path):其封装了format("json").load(path);
- csv(path):其封装了format("csv").load(path);
- parquet(path):其封装了format("parquet").load(path);
其中path参数为文件的路径,若该路径发现新增文件,则会被以数据流的形式被获取。但该路径只能是指定的格式文件,不能存放其它文件格式。
注意:
若是以Spark集群方式运行,则路径是hdfs种的文件路径;若是以local方式执行,则路径为本地路径。
获取的文件形式有四种,但并不是每种格式都需要调用schema()方法来配置文件信息:
- csv、json、parquet:用户需要通过schema()方法手动配置文件信息;
- text:不需要用户指定schema,其返回的列是只有一个"value"。
4) 自定义
若上述Spark Structured Streaming API提供的数据输入源不能满足要求,那么还有一种方法可以使用:修改源码。
如下通过获取"socket"数据源相应类的内容为例,介绍具体使用方式:
4.1 实现Provider
首先实现一个Provider,该类会返回一个数据的数据源对象。其中Provider实现类需要实现三个方法:
|
序号 |
方法 |
描述 |
|
1 |
souceSchema |
该方法返回一个配置信息的词典,key是字符串,value是StructType对象 |
|
2 |
createSource |
该方法返回一个接受数据源的对象,其为Source接口的子类 |
|
3 |
shortName |
该方法返回一个数据源的标识符,如上述format()方法传递的参数:"socket"、"json"或"kafka";此时返回的字符串,就是format()方法传递的参数 |
如下所示实现一个TextRabbitMQSourceProvider类:
|
class TextRabbitMQSourceProvider extends StreamSourceProvider with DataSourceRegister with Logging { private def parseIncludeTimestamp(params: Map[String, String]): Boolean = { Try(params.getOrElse("includeTimestamp", "false").toBoolean) match { case Success(bool) => bool case Failure(_) => throw new AnalysisException("includeTimestamp must be set to either \"true\" or \"false\"") } } /** Returns the name and schema of the source that can be used to continually read data. */ override def sourceSchema( sqlContext: SQLContext, schema: Option[StructType], providerName: String, parameters: Map[String, String]): (String, StructType) = { logWarning("The socket source should not be used for production applications! " + "It does not support recovery.") if (!parameters.contains("host")) { throw new AnalysisException("Set a host to read from with option(\"host\", ...).") } if (!parameters.contains("port")) { throw new AnalysisException("Set a port to read from with option(\"port\", ...).") } val schema = if (parseIncludeTimestamp(parameters)) { TextSocketSource.SCHEMA_TIMESTAMP } else { TextSocketSource.SCHEMA_REGULAR } ("textSocket", schema) } override def createSource( sqlContext: SQLContext, metadataPath: String, schema: Option[StructType], providerName: String, parameters: Map[String, String]): Source = { val host = parameters("host") val port = parameters("port").toInt new TextRabbitMQSource(host, port, parseIncludeTimestamp(parameters), sqlContext) } /** String that represents the format that this data source provider uses. */ override def shortName(): String = "RabbitMQ" } |
4.2 实现Source
用户需要实现一个真正接受数据的类,该类实例是由Provider实现类来实例化,如上述的createSource()方法。其中需要实现Source抽象类的几个方法,从而让Structured Streaming引擎能够调用:
|
序号 |
方法 |
描述 |
|
1 |
getOffset |
获取可用的数据偏移量,表明是否有可用的数据 |
|
2 |
getBatch |
获取可用的数据,以DataFrame对象形式返回 |
|
3 |
commit |
传递已经接收的数据偏移量 |
|
4 |
stop |
听着Source数据源 |
|
class TextRabbitMQSource(host: String, port: Int, includeTimestamp: Boolean, sqlContext: SQLContext) extends Source with Logging { @GuardedBy("this") private var socket: Socket = null @GuardedBy("this") private var readThread: Thread = null /** * All batches from `lastCommittedOffset + 1` to `currentOffset`, inclusive. * Stored in a ListBuffer to facilitate removing committed batches. */ @GuardedBy("this") protected val batches = new ListBuffer[(String, Timestamp)] @GuardedBy("this") protected var currentOffset: LongOffset = new LongOffset(-1) @GuardedBy("this") protected var lastOffsetCommitted : LongOffset = new LongOffset(-1) initialize() private def initialize(): Unit = synchronized { socket = new Socket(host, port) val reader = new BufferedReader(new InputStreamReader(socket.getInputStream)) readThread = new Thread(s"TextSocketSource($host, $port)") { setDaemon(true) override def run(): Unit = { try { while (true) { val line = reader.readLine() if (line == null) { // End of file reached logWarning(s"Stream closed by $host:$port") return } TextSocketSource.this.synchronized { val newData = (line, Timestamp.valueOf( TextSocketSource.DATE_FORMAT.format(Calendar.getInstance().getTime())) ) currentOffset = currentOffset + 1 batches.append(newData) } } } catch { case e: IOException => } } } readThread.start() } /** Returns the schema of the data from this source */ override def schema: StructType = if (includeTimestamp) TextSocketSource.SCHEMA_TIMESTAMP else TextSocketSource.SCHEMA_REGULAR override def getOffset: Option[Offset] = synchronized { if (currentOffset.offset == -1) { None } else { Some(currentOffset) } } /** Returns the data that is between the offsets (`start`, `end`]. */ override def getBatch(start: Option[Offset], end: Offset): DataFrame = synchronized { val startOrdinal = start.flatMap(LongOffset.convert).getOrElse(LongOffset(-1)).offset.toInt + 1 val endOrdinal = LongOffset.convert(end).getOrElse(LongOffset(-1)).offset.toInt + 1 // Internal buffer only holds the batches after lastOffsetCommitted val rawList = synchronized { val sliceStart = startOrdinal - lastOffsetCommitted.offset.toInt - 1 val sliceEnd = endOrdinal - lastOffsetCommitted.offset.toInt - 1 batches.slice(sliceStart, sliceEnd) } import sqlContext.implicits._ val rawBatch = sqlContext.createDataset(rawList) // Underlying MemoryStream has schema (String, Timestamp); strip out the timestamp // if requested. if (includeTimestamp) { rawBatch.toDF("value", "timestamp") } else { // Strip out timestamp rawBatch.select("_1").toDF("value") } } override def commit(end: Offset): Unit = synchronized { val newOffset = LongOffset.convert(end).getOrElse( sys.error(s"TextSocketStream.commit() received an offset ($end) that did not " + s"originate with an instance of this class") ) val offsetDiff = (newOffset.offset - lastOffsetCommitted.offset).toInt if (offsetDiff < 0) { sys.error(s"Offsets committed out of order: $lastOffsetCommitted followed by $end") } batches.trimStart(offsetDiff) lastOffsetCommitted = newOffset } /** Stop this source. */ override def stop(): Unit = synchronized { if (socket != null) { try { // Unfortunately, BufferedReader.readLine() cannot be interrupted, so the only way to // stop the readThread is to close the socket. socket.close() } catch { case e: IOException => } socket = null } } override def toString: String = s"TextSocketSource[host: $host, port: $port]" } |
4.3 注册Provider
由于Structured Streaming引擎会根据用户在format()方法传递的数据源类型来寻找具体数据源的provider,即在DataSource.lookupDataSource()方法中寻找。所以用户需要将上述实现的Provider类注册到Structured Streaming引擎中。所以用户需要将provider实现类的完整名称添加到引擎中的某个,这个地方就是在Spark SQL工程中的\spark-2.2.0\sql\core\src\main\resources\META-INF\services\org.apache.spark.sql.sources.DataSourceRegister文件中。用户通过将Provider实现类名称添加到该文件中,从而完成Provider类的注册工作。
如下所示在文件最后一行添加,我们自己自定义的实现类完整路径和名称:
|
org.apache.spark.sql.execution.datasources.csv.CSVFileFormat org.apache.spark.sql.execution.datasources.jdbc.JdbcRelationProvider org.apache.spark.sql.execution.datasources.json.JsonFileFormat org.apache.spark.sql.execution.datasources.parquet.ParquetFileFormat org.apache.spark.sql.execution.datasources.text.TextFileFormat org.apache.spark.sql.execution.streaming.ConsoleSinkProvider org.apache.spark.sql.execution.streaming.TextSocketSourceProvider org.apache.spark.sql.execution.streaming.RateSourceProvider org.apache.spark.sql.execution.streaming.TextRabbitMQSourceProvider |
4.4 使用API
再Spark SQL源码重新编译后,并肩其jar包丢进Spark的jars路径下。从而用户就能够像使用Structured Streaming自带的数据输入源一样,使用用户自定义的"RabbitMQ"数据输入源了。即用户只需将RabbitMQ字符串传递给format()方法,其使用方式和"socket"方式一样,因为上述的数据源内容其实是Socket方式的实现内容。
5. 参考文献
[1]. Structured Streaming Programming Guide.
Spark Structured Streaming框架(2)之数据输入源详解的更多相关文章
- Spark Structured Streaming框架(2)之数据输入源详解
Spark Structured Streaming目前的2.1.0版本只支持输入源:File.kafka和socket. 1. Socket Socket方式是最简单的数据输入源,如Quick ex ...
- Spark Structured Streaming框架(3)之数据输出源详解
Spark Structured streaming API支持的输出源有:Console.Memory.File和Foreach.其中Console在前两篇博文中已有详述,而Memory使用非常简单 ...
- Spark Structured streaming框架(1)之基本使用
Spark Struntured Streaming是Spark 2.1.0版本后新增加的流计算引擎,本博将通过几篇博文详细介绍这个框架.这篇是介绍Spark Structured Streamin ...
- Spark Structured Streaming框架(1)之基本用法
Spark Struntured Streaming是Spark 2.1.0版本后新增加的流计算引擎,本博将通过几篇博文详细介绍这个框架.这篇是介绍Spark Structured Streamin ...
- Spark Structured Streaming框架(4)之窗口管理详解
1. 结构 1.1 概述 Structured Streaming组件滑动窗口功能由三个参数决定其功能:窗口时间.滑动步长和触发时间. 窗口时间:是指确定数据操作的长度: 滑动步长:是指窗口每次向前移 ...
- Spark Structured Streaming框架(5)之进程管理
Structured Streaming提供一些API来管理Streaming对象.用户可以通过这些API来手动管理已经启动的Streaming,保证在系统中的Streaming有序执行. 1. St ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(二十九):推送avro格式数据到topic,并使用spark structured streaming接收topic解析avro数据
推送avro格式数据到topic 源代码:https://github.com/Neuw84/structured-streaming-avro-demo/blob/master/src/main/j ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十一)定制一个arvo格式文件发送到kafka的topic,通过Structured Streaming读取kafka的数据
将arvo格式数据发送到kafka的topic 第一步:定制avro schema: { "type": "record", "name": ...
- Spark2.3(三十五)Spark Structured Streaming源代码剖析(从CSDN和Github中看到别人分析的源代码的文章值得收藏)
从CSDN中读取到关于spark structured streaming源代码分析不错的几篇文章 spark源码分析--事件总线LiveListenerBus spark事件总线的核心是LiveLi ...
随机推荐
- eclipse 打包 jar 到 Linux上运行
1.选择需要打包的项目,右键 Export 2.选择Runnable JAR file,然后点击 Next 3.选择jar包运行的main类,以及定义jar包的名字,保存的地方 4.将 导出来的 ja ...
- 在CentOS7上部署OpenStack 步骤详解
OpenStack作为一个由NASA(美国国家航空航天局)和Rackspace合作研发并发起的,开放源代码项目的云计算管理平台项目.具体知识我会在后面文章中做出介绍,本章主要按步骤给大家演示在Cent ...
- 7. leetcode 104. Maximum Depth of Binary Tree
Given a binary tree, find its maximum depth. The maximum depth is the number of nodes along the long ...
- swift 录制多个音频 并将音频转换为mp3 并合成多个mp3文件为一个文件
我的需求是可以录制多个文件,最后生成的文件格式为mp3形式,查了下各种资料,因为swift无法直接将音频录制为mp3格式,所以最后我采取的解决方案为先将每个单独的文件转为mp3,最后逐一合并形成一个m ...
- js判断移动终端(手机浏览器)
方法1: <script type="text/javascript"> var browser = { versions: f ...
- [NOIP 2010]饮水入城 搜索+贪心
考试的时候写了个dfs找出来了,最后处理的时候想到了贪心,但是正确性没有想通.然后想了想动规,也没想通.最后没办法,用状态的话用了个状压,弄了40分. 正解是bfs+贪心.Dfs也有过的. 下面题解引 ...
- Eclipse中的Debug
一.Debug的基本过程 设置断点(双击待设断点左边行号处) 进入Debug模式(在待调试类上右键>调试方式,根据需求选择) 开始调试 二.Debug中的常用操作 继续执行[F8]:继续运行程序 ...
- ssh自学笔记
Ssh自学笔记 Ssh简介 传统的网络服务程序,如:ftp.pop和telnet在本质上都是不安全的,因为它们在网络上用明文传送口令和数据,别有用心的人非常容易就可以截获这些口令和数据.而且,这些服务 ...
- iPhone 尺寸
http://tool.lanrentuku.com/guifan/ui.html 这是本人复制的链接,,
- python进阶(6):多态,封装
昨天说了面向对象三大特性的继承,今天来说多态和封装,很多其他程序员说python不支持多态没有多态,并不是python没有多态,而是python处处皆多态.今天的讲课重点会放在封装. 一.多态 1.多 ...